
 脚本プランナー▸
 AIアプリ
 AIニュース
TokenFlow:動画編集を革新するAIフレームワーク
TokenFlow:動画編集を革新するAIフレームワーク紹介
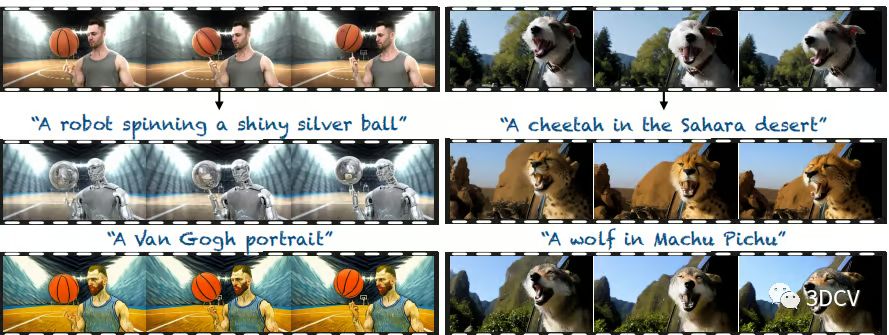
TokenFlowは、事前学習済みのテキストから画像への拡散モデルを利用して動画編集を行うフレームワークです。さらなる学習や微調整を必要とせず、一貫した動画編集を実現できます。TokenFlowの主な目的は、入力されたテキストプロンプトを通じて高品質な動画を生成しつつ、動画の一貫性と目標とする編集効果を維持することです。
TokenFlowの技術的背景
拡散モデル:TokenFlowはテキストから画像への拡散モデルの能力を活用しています。
生成系AI:近年、動画分野における生成系AIの応用が徐々に増えています。
画像生成:拡散モデルは画像生成において優れた性能を示し、動画編集技術の発展を推進しています。
テキスト駆動:TokenFlowはテキストプロンプトを通じて動画編集を指示します。
一貫性:拡散特徴空間内の一貫性を強制することで、動画編集の一貫性を実現しています。
TokenFlowの応用分野
動画編集:TokenFlowは主にテキスト駆動による動画編集に使用されます。
映像制作:映画や動画制作における特殊効果やシーン編集に活用できます。
広告制作:広告制作者がブランド要件に合致した動画コンテンツを迅速に生成するのに役立ちます。
教育動画:教育分野において、TokenFlowは教材ビデオの作成に使用できます。
ソーシャルメディア:ソーシャルメディアのコンテンツ制作者に効率的な動画編集ツールを提供します。
TokenFlowの実装方法
テキストから画像への拡散モデル:事前学習済みモデルを利用して動画編集を行います。
特徴の一貫性:拡散特徴空間内の一貫性を強制することで実現されます。
学習不要:追加の学習や微調整は不要です。
フレーム間対応:動画のフレーム間対応性を利用して一貫性を保ちます。
既存手法との組み合わせ:既存の画像編集手法と組み合わせて使用できます。
TokenFlowの利点と課題
利点:学習不要で、迅速に高品質な動画を生成できます。
一貫性:編集プロセス全体を通じて動画の一貫性を保ちます。
柔軟性:さまざまな既存手法と組み合わせて使用できます。
課題:長尺動画や複雑な動的シーンにおいて一貫性を維持すること。
改善の余地:解像度や動画時間の面でまだ向上の余地があります。
TokenFlowは、事前学習済みのテキストから画像への拡散モデルに基づく動画編集フレームワークとして、拡散特徴空間内で特徴を伝播させることで、動画の空間配置や動きを維持し、目標テキストと一致する高品質な動画を生成します。TokenFlowは学習や微調整を必要とせず、市販のあらゆるテキストから画像への編集手法と組み合わせて使用できます。複数の実世界動画における最先端の編集結果を提示することで、その手法の有効性が実証されています。プロの動画編集者でも一般ユーザーでも、TokenFlowは高品質で一貫性のある動画編集体験を提供します。
TokenFlowコードリポジトリ:https://github.com/omerbt/TokenFlow















