
 脚本プランナー▸
 AIアプリ
 AIニュース
MoshiVis:画像を見て自然な音声で議論できる視覚・音声モデル
小编 ·

MoshiVis:画像を見て自然な音声で議論できる視覚・音声モデル
MoshiVisとは?
MoshiVis はMoshiをベースに開発された視覚音声モデルであり、Moshiの低遅延かつ自然な会話能力を継承しつつ、画像内容について自然な会話スタイルで議論することができます。複数ターンの対話に対応しており、画像内のテキスト内容を読み上げたり、画像に関する質問に回答したりすることが可能です。
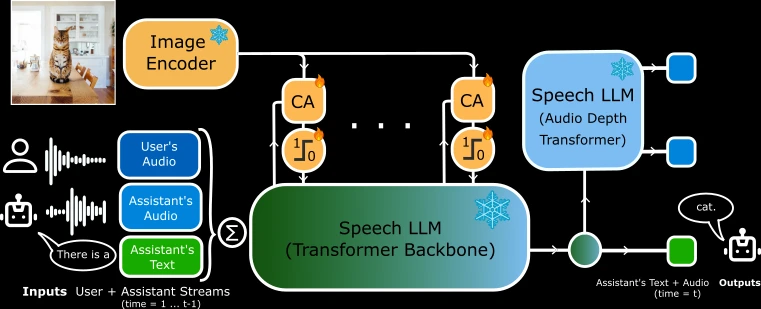
クロスアテンション機構を通じて視覚情報を音声ストリームに統合しつつ、低遅延かつ低メモリ使用量を維持しています。MoshiVis は PyTorch、Rust、MLX など複数のバックエンドをサポートしており、事前学習済みモデルと合成視覚対話データセットが公開されているため、リアルタイム音声インタラクションのシナリオに適しています。
MoshiVisの主な機能
視覚と音声の統合:MoshiVis は Moshi に視覚理解機能を追加し、画像情報を音声対話に組み込むことができます。コアとなる Transformer アーキテクチャを拡張し、クロスアテンション機構を導入することで、視覚情報を音声ストリームに注入します。
低遅延と低メモリ使用量:低遅延を維持しメモリ使用量を削減するため、MoshiVis のクロスアテンション投影重みは各レイヤーで共有され、ゲート機構によって視覚入力フローが調整されます。
自然な会話スタイル:視覚能力を統合しながらも、Moshi が持つ自然な会話スタイルを保持しています。
MoshiVisの技術アーキテクチャ
ベースモデル:7B パラメータの音声-テキスト基盤モデルである Moshi をベースにしています。
視覚エンコーダ:PaliGemma2 ファミリーの事前学習済み凍結 400M 視覚エンコーダを使用しています。
アダプタパラメータ:Moshi 基础上に約 206M のアダプタパラメータが追加され、視覚情報の処理に使用されます。
クロスアテンション機構:クロスアテンションモジュールにより視覚情報を音声ストリームに注入すると同時に、ゲート機構により視覚入力の影響を調整します。
MoshiVisモデルの公開
モデルバリアント:Moshika(女声)に基づく MoshiVis モデルが公開されており、音声コーデック、テキストトークナイザ、画像エンコーダ、ベースとなる Moshi モデルを含む完全なモデル重みが含まれています。
バックエンドサポート:PyTorch、Rust、MLX の 3 種類のバックエンドが提供されており、BF16、Q8_0 などさまざまな量子化フォーマットに対応しています。
ライセンス:モデル重み(視覚エンコーダを除く)は CC-BY 4.0 ライセンス下で公開されており、視覚エンコーダは Gemma ライセンス下で公開されています。
MoshiVisの使用方法
WebUI フロントエンド:WebUI フロントエンドが提供されており、エコーキャンセリングをサポートし、モデルのパフォーマンスを向上させます。ユーザーは事前ビルド済みの静的バージョンを使用するか、ソースコードを自行コンパイルして使用することができます。
バックエンドの実行:
PyTorch:約 24GB の GPU メモリが必要で、量子化はサポートされていません。
Rust:GPU アクセラレーションをサポートしており、Rust ツールチェーンと CUDA(macOS の場合は Metal)が必要です。
MLX:bfloat16 と量子化(q4、q8)フォーマットをサポートしています。
実行コマンド:詳細な実行コマンドが提供されており、ユーザーは必要に応じて異なるバックエンドと量子化フォーマットを選択できます。
関連リンク:
GitHub プロジェクト:https://github.com/kyutai-labs/moshivis
HuggingFace モデル:https://huggingface.co/collections/kyutai/moshivis-v01-67cef4acae6a5d75d6d6c883









