
 脚本プランナー▸
 AIアプリ
 AIニュース
Umi-OCR:無料でオープンソースのバッチ対応オフラインOCRツール
小编 ·

Umi-OCR:無料でオープンソースのバッチ対応オフラインOCRツール
Umi-OCRとは?
Umi-OCRは、百度のPaddleOCRフレームワークをベースに開発された、オープンソースで無料のオフラインOCRツールです。スクリーンショット/画像の一括インポート、PDFドキュメント認識、透かし/ヘッダー・フッターの除去、QRコードのスキャン/生成、複数言語ライブラリの内蔵などの機能を備えており、高精度認識、オフライン動作、多言語対応、効率的なバッチ処理などの利点があります。
Umi-OCRの主な特徴
オフライン動作:完全にオフラインで使用でき、ネットワーク接続が不要で、ユーザーのプライバシーを保護します。
多言語サポート:複数言語ライブラリを内蔵し、さまざまな言語の文字認識をサポートします。
多彩な認識機能:
スクリーンショットOCR:スクリーンショットや画像貼り付けによる文字認識をサポートします。
バッチOCR:画像を一括インポートして文字認識が可能で、さまざまな画像形式に対応します。
PDF認識:PDFドキュメントからテキストを抽出し、ヘッダーやフッターなどを除外することができます。
QRコード認識:QRコードのスキャンと生成をサポートします。
数式認識:数学の数式認識をサポートします(テスト中)。
テキスト後処理:認識結果のレイアウト整理をサポートし、邪魔な文字を除外します。
柔軟な呼び出し:コマンドラインとHTTPインターフェースでの呼び出しをサポートし、開発者の統合に便利です。
Umi-OCRの技術的特性
高精度認識:複数の言語モデルを内蔵し、簡体字/繁体字中国語、英語、日本語、韓国語、および一般的なヨーロッパ言語をサポートし、混植テキスト認識にも対応します。
複雑なレイアウト解析:縦書きテキスト、表、簡単な数式を正確に認識します。
低品質画像の最適化:ぼやけ、傾き、低照度の画像に対して前処理を行い、認識精度を向上させます。
効率的なバッチ処理と柔軟な出力:フォルダのドラッグ&ドロップや画像の一括インポートをサポートし、数百ファイルのOCR認識をワンクリックで完了します。
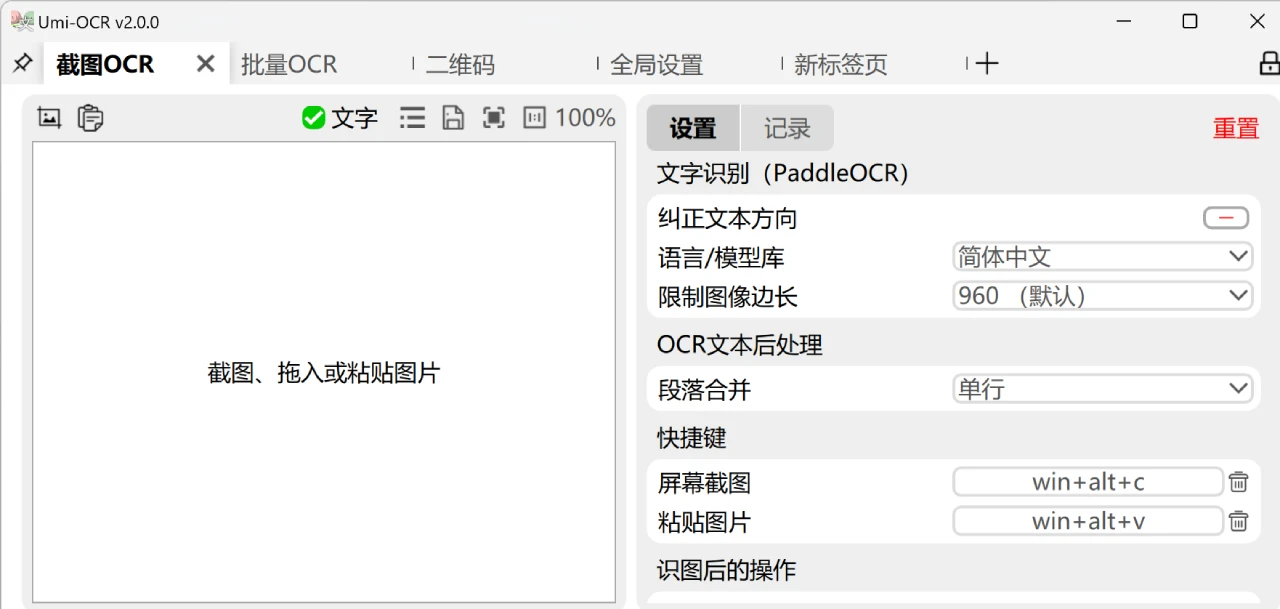
Umi-OCRの使用シーン
オフィスシーン:スキャンされたPDFや画像レポートからテキストを素早く抽出し、編集可能なドキュメントに変換します。
学術研究:外国語の文献や古典資料を認識し、翻訳や引用を支援します。
マルチメディア処理:動画のスクリーンショット、漫画の翻訳、ゲームの字幕にテキスト抽出サポートを提供します。
自動化フロー:コマンドラインインターフェースを通じて他のツールチェーンに統合し、バッチOCRの自動化を実現します。
Umi-OCRのダウンロードと使用方法
ダウンロードリンク:
蓝奏云(国内おすすめ、登録不要/速度制限なし):https://hiroi-sora.lanzoul.com/s/umi-ocr
GitHub Release:https://github.com/hiroi-sora/Umi-OCR/releases/tag/v2.1.4
インストール方法:解凍するだけで使え、インストール不要です。Windows 7 x64およびLinux x64プラットフォームをサポートしています。
コマンドラインでのインストール:Scoop(Windows)からインストール:
scoop install extras/umi-ocr
今後の計画
基盤プラグイン机制のリファクタリング。
オンラインOCR APIプラグインの追加。
独立した数式認識プラグインの実装。
画像翻訳とオフライン翻訳のサポート。
MacOSおよびより多くのLinuxディストリビューションへの対応
先日紹介したolmOCRも良く、PDF変換を重視する場合は試してみる価値があります。









