
 脚本プランナー▸
 AIアプリ
 AIニュース
olmOCR:PDFやドキュメントを高精度で変換する強力なオープンソースOCRツール
小编 ·

olmOCR:PDFやドキュメントを高精度で変換する強力なオープンソースOCRツール
OLMOCRとは?
OLMOCRは、PDFファイルを高精度でテキストに変換できるオープンソースのツールです。変換時にはドキュメントの読み順を保持し、表、数式、手書き内容の認識をサポートします。また、高いスループットでドキュメントを処理でき、自然な読み順を保持したテキスト変換が可能で、精度が高いためハルシネーションが少なくなっています。
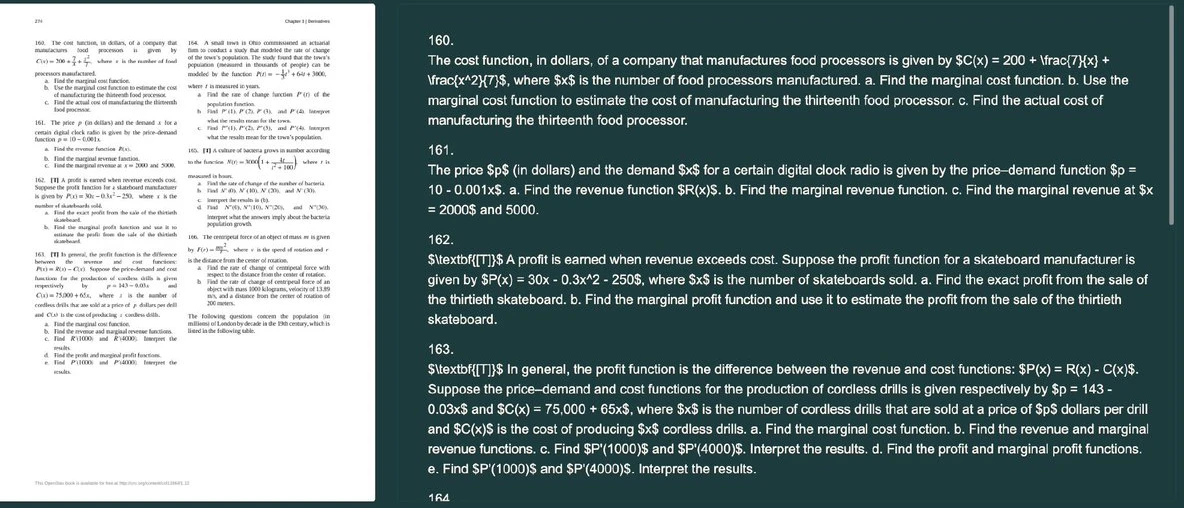
olmOCRの機能と特徴
高精度: OLMOCRは高度なOCR技術を提供し、変換プロセスにおいてコンテンツの正確性を最大限に保持します。
多様なフォーマットに対応: このツールは複雑なフォーマットを含むドキュメントなど、さまざまな種類のPDFを処理できます。
開発ツールキット: 基本的なOCR機能に加え、PDFを線形化するためのツールセットも含まれており、AI言語モデルの学習に適したデータセットの生成に便利です。
olmOCRの利用シーン
紙のドキュメント画像をテキストにデジタル化して、ドキュメント管理を容易にします。
内蔵機能により、表の内容などの重要なデータを抽出でき、後での分析や利用に便利です。
大量のドキュメント処理が必要な企業や研究機関に適しています。
教育分野において、試験資料や手書きノートをデジタル化して変換するために使用できます。
医療業界では、スキャンした医療記録や表を処理するためにこのツールを活用できます。
法律分野では、法律ドキュメントの効率的な管理と検索に利用できます。
紙のドキュメントをデジタル化してアーカイブする歴史研究プロジェクトに適しています。
olmOCRの優位性
高精度認識:表や数式などの複雑な構造を識別する能力を備えています。
コスト効率が高い:PDFを100万ページ変換あたりの費用はわずか190ドルです。
大規模処理能力:大量のファイルを一括変換できます。
さまざまなハードウェアと互換性がある:異なるハードウェア構成で動作させることができます。
包括的なコンポーネントを提供:モデルの重み、データ、学習コードが提供されており、ユーザーが柔軟に選択できます。
olmOCRよくある質問
Q: 手書きテキストの認識に対応していますか?
A: はい、olmOCRは手書きテキストを認識できます。
Q: 一括処理に制限はありますか?
A: olmOCRは大規模な一括処理をサポートしており、異なるハードウェア環境にも柔軟に対応します。
Q: 無料トライアル版はありますか?
A: 概要とすべてのコンポーネントはオープンソースであり、GitHubで入手できます。
Q: PDF1ページの平均処理時間はどのくらいですか?
A: 具体的な時間はハードウェア構成によって異なりますが、全体的な運用コストは非常に低くなっています。
Q: 対応している言語は何ですか?
A: olmOCRは複雑な構造のコンテンツを含む、複数の言語をサポートしています。
オンラインデモ:olmocr.allenai.org にアクセス
GitHubリポジトリ:https://github.com/allenai/olmocr









