
 脚本プランナー▸
 AIアプリ
 AIニュース
バイトダンスのOmniHumanモデルが即夢で内測開始
小编 ·

バイトダンスのOmniHumanモデルが即夢で内測開始
字节跳动が発表したOmniHumanモデルはすでに即夢AIでベータテストが開始されています。このモデルは全く新しいマルチモーダル動画生成技術を採用しており、ユーザーが1枚の画像と1つの音声を入力するだけで、極めてリアルな実写風の人物動画アニメーションを生成することができます。顔の表情から全身の動きまでをカバーし、会話、歌唱、ダンスなどにも対応しています。
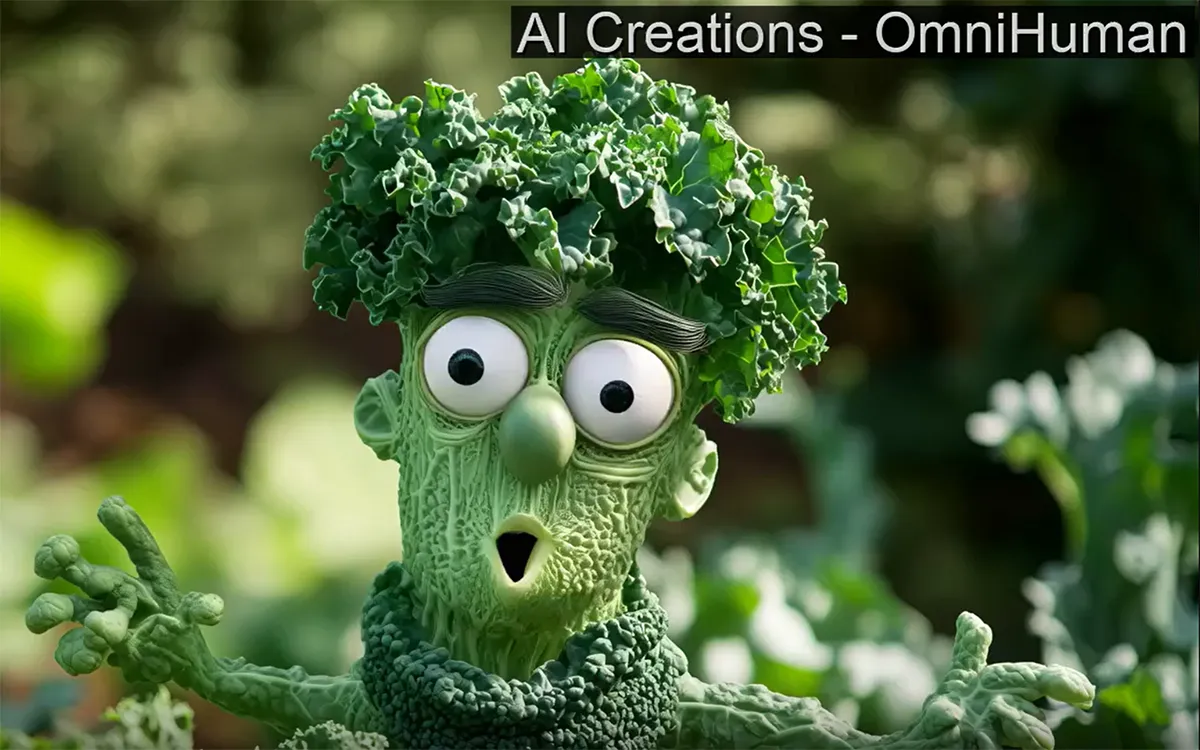
OmniHumanモデルの主な機能:
動画生成:入力した1枚の写真を高品質な全身のダイナミックな動画に変換することができ、デジタルヒューマンに会話や歌唱など多様な自然な動作を行わせることが可能です。
マルチモーダル入力:ポートレート、半身、全身など異なるサイズの画像入力を同時にサポートし、音声コンテンツと組み合わせることで、トレーニングデータの効果も良好で、高品質なアニメーション動画を生成できます。
OmniHumanモデルはポートレートと全身の動画生成だけでなく、アニメや3Dカートゥーンなど、実写ではない様々なタイプの画像入力においても優れたパフォーマンスを発揮します。即夢aiの責任者によると、OmniHumanはすでに良好な効果を示していますが、映画・テレビ品質のリアルな動画生成にはまだ改善の余地があるとのことです。OmniHumanは順次利用開放を進めており、現在は小規模なベータテストを実施し、厳格なセキュリティ審査メカニズムを設定しています。
OmniHumanはどこで使える?
即夢AIにログインし、左サイドバーから動画生成を選択します。
私もベータテストを申請しているところです…ユーザーによっては口の動き合わせの効果があまり良くないと言う人もいれば、素晴らしいと評価する人もいます。









