
 脚本プランナー▸
 AIアプリ
 AIニュース
OmniHuman:エンドツーエンドのマルチモーダル人体動画生成フレームワーク
小编 ·

OmniHuman:エンドツーエンドのマルチモーダル人体動画生成フレームワーク
OmniHumanはバイトダンスの拡散Transformerに基づくマルチモーダルデジタルヒューマン動画生成フレームワークです。たった1枚の写真と1つの音声だけで動画を生成でき、動き、口の動き、表情がほぼ完璧に再現されます。
OmniHumanフレームワークは、訓練段階で動きに関連する条件を混合することでデータ規模を拡大します。このフレームワークの核心は、複数の入力モダリティを処理し、よりリアルで自然なデジタルヒューマン動画を生成できる点にあります。
OmniHumanの主な特徴
マルチモーダル入力:OmniHumanはテキスト、音声、動画など複数の入力形式をサポートし、生成されたデジタルヒューマンが異なるシーンでより豊かな感情や動作を表現できるようにします。異なるモダリティのデータを融合することで、高品質データが不足しているというボトルネックを突破します。
データ規模の拡大:動きに関連する条件を導入することで、OmniHumanは訓練過程においてデータセットを効果的に拡大し、生成モデルの汎用性と表現力を向上させます。
高品質な出力:このフレームワークは高度なディープラーニング技術を活用し、高品質なデジタルヒューマン動画を生成します。実在の人物だけでなく、3Dキャラクターやアニメキャラクターもサポートし、ライブ配信、エンターテインメント、教育などさまざまな分野に対応します。
リアルタイム生成:OmniHumanはリアルタイム生成機能も備えており、ユーザーはインタラクティブなシーンでデジタルヒューマンからのフィードバックや表現を即座に受け取ることができます。
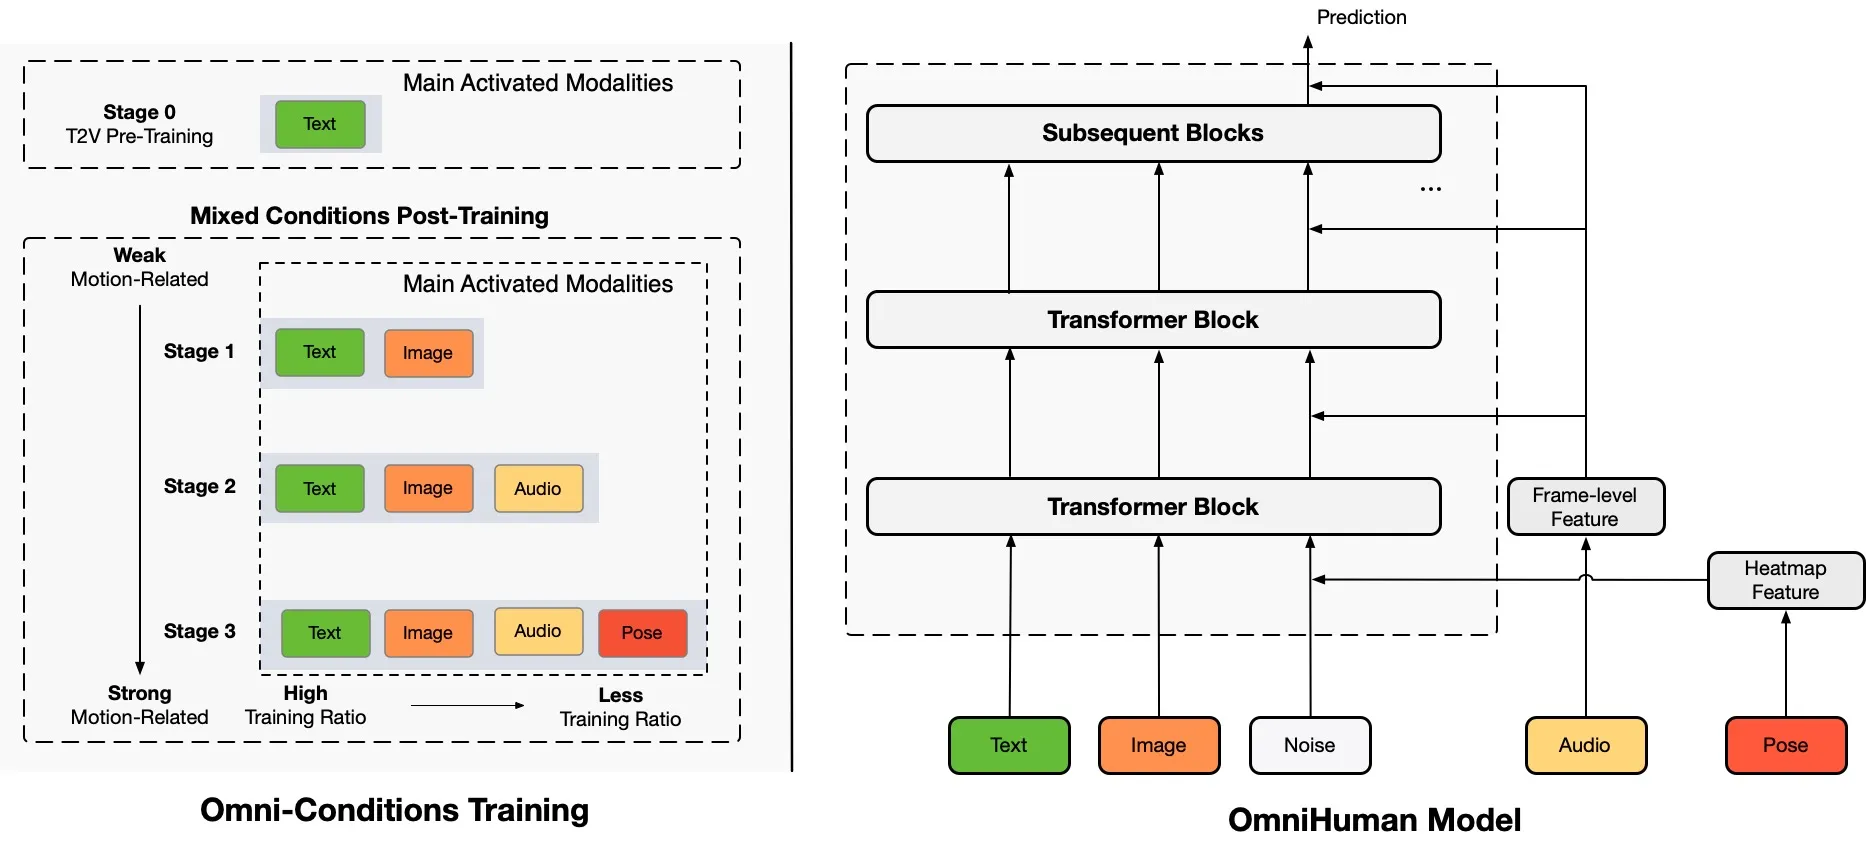
OmniHumanは音声駆動、動画駆動、組み合わせ駆動信号など複数の駆動モードもサポートしており、ユーザーが入力面でより大きな柔軟性を持てるようにしています。さらに、OmniHumanは人体と物体のインタラクションや、難易度の高い体の姿勢も処理でき、生成される動画の実在感と表現力をさらに高めています。OmniHumanフレームワークの設計理念は、データ駆動型の動作生成を最大限に活用し、最終的に極めてリアルな人間の動画生成を実現することです。既存のエンドツーエンドの音声駆動方式と比較して、OmniHumanはよりリアルな動画を生成できるだけでなく、入力面でもより大きな柔軟性を提供します。動画サンプルはttfamilyのプロジェクトページで閲覧でき、さまざまなシーンでの応用効果が紹介されています。
OmniHumanの応用シーン
バーチャル配信者:ライブ配信プラットフォーム上で、OmniHumanはバーチャル配信者を生成し、リアルタイムのインタラクションやエンターテインメントコンテンツを提供できます。
教育訓練:バーチャル教師を生成することで、OmniHumanはオンライン教育において個別化された学習体験を提供できます。
ゲーム開発:ゲーム内では、バーチャルキャラクターをOmniHumanで生成することで、ゲームの没入感とインタラクション性を向上させることができます。
OmniHumanプロジェクトアドレス:https://omnihuman-lab.github.io









