
 脚本プランナー▸
 AIアプリ
 AIニュース
Janus-ProとJanusFlowの違いと共通点は?
小编 ·

Janus-ProとJanusFlowの違いと共通点は?
Janus-Pro と JanusFlow は DeepSeek が発表した2つのマルチモーダルaiモデルです。どちらも画像理解と生成タスクに特化していますが、技術アーキテクチャ、設計思想、応用シーンには比較的明らかな違いがあります。以下、それぞれの違いをご紹介します:
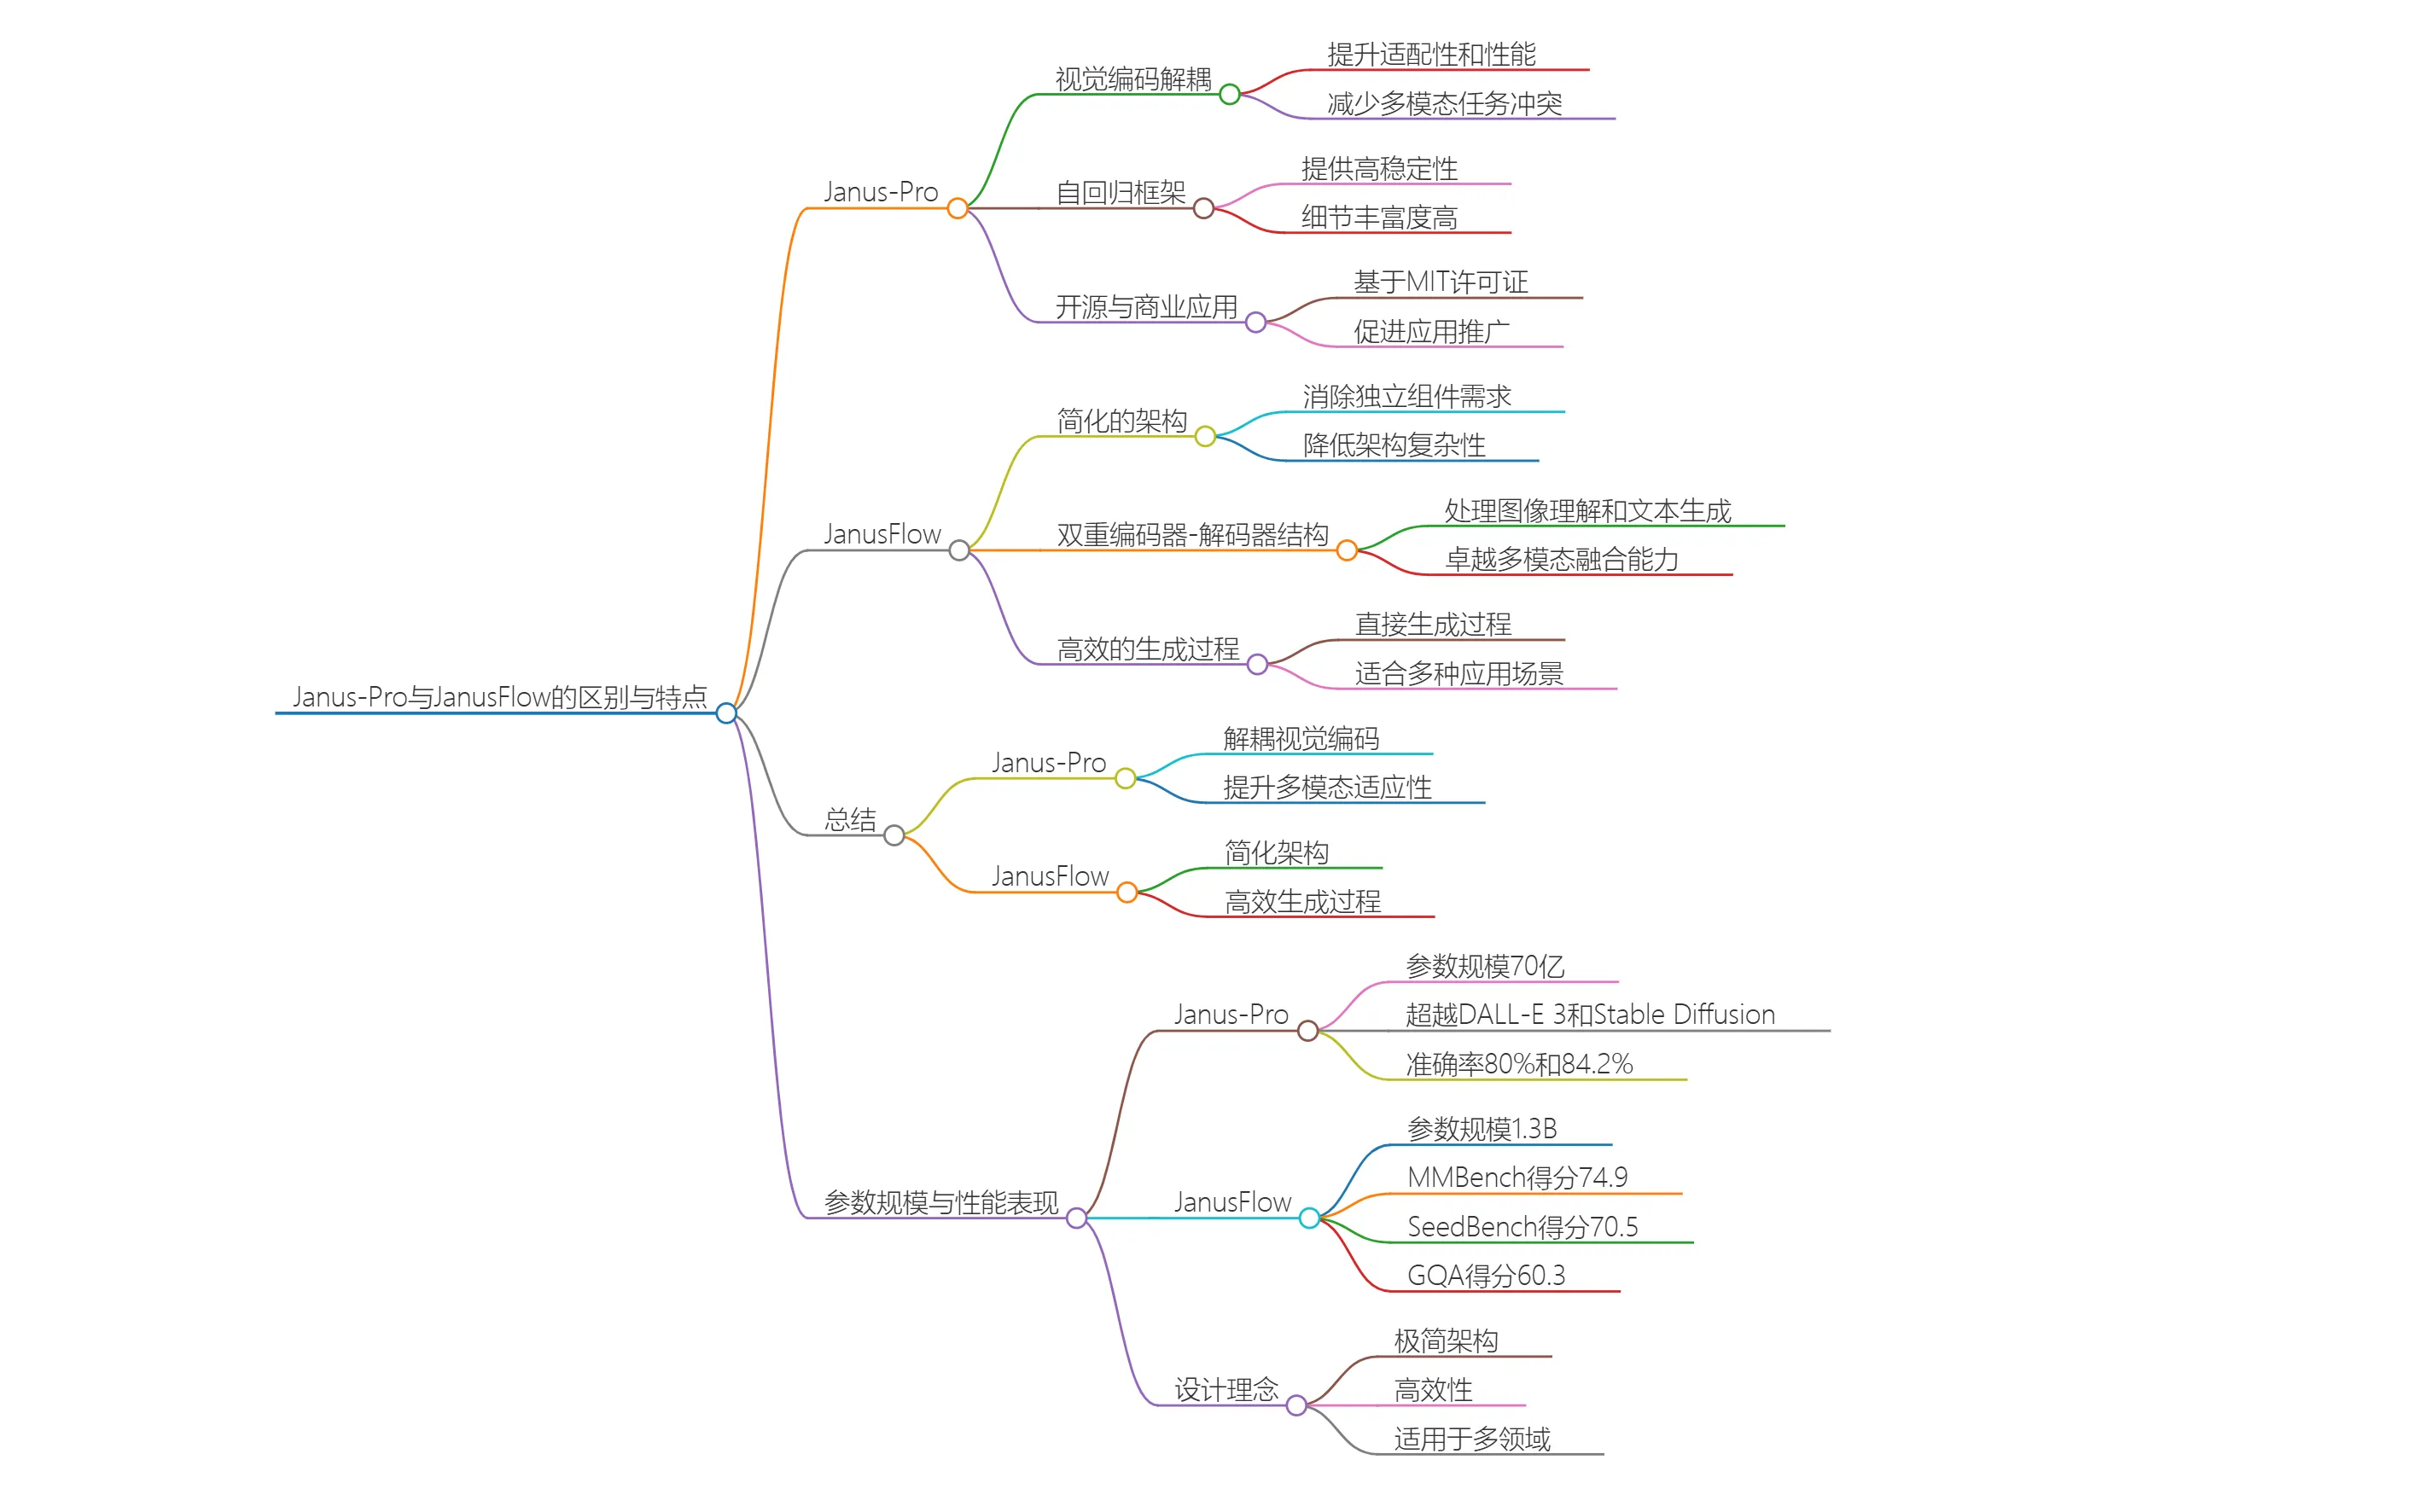
1. 技術アーキテクチャ
Janus-Pro:
視覚エンコーディングの分離技術を採用しており、視覚エンコーディングプロセスを独立したパスに分割し、マルチモーダル理解と生成タスクをそれぞれ処理することで、従来のモデルにおける視覚エンコーダーの2つのタスク間の機能衝突を解決しています。
統一された Transformer アーキテクチャに基づき、モデル設計が簡素化され、拡張能力が向上しています。
視覚エンコーダーとして SigLIP-L を使用し、384x384 解像度の画像入力をサポートし、画像生成には LlamaGen Tokenizer を採用しています。
JanusFlow:
生成フロー(Rectified Flow)と自己回帰言語モデルの融合により、極めてシンプルで強力なマルチモーダルフレームワークを実現し、複雑な改造なしに高品質な画像を生成できます。
同様に視覚エンコーダーとして SigLIP-L を使用し、SDXL-VAE に基づいて画像生成を行い、精細度がさらに高くなっています。
2. 設計思想
Janus-Pro:
柔軟性と効率性を重視しており、視覚エンコーディングの分離によりモデルが異なるタスクへの適応性を向上させ、視覚问答、画像注釈などのマルチモーダルシナリオに適しています。
統一されたマルチモーダルフレームワークとなることを目指しており、画像内容を効率的に理解するだけでなく、高品質な画像を生成することもできます。
JanusFlow:
極めてシンプルなアーキテクチャと高い拡張性を重視しており、生成フローと言語モデルの融合により、マルチモーダルモデリングプロセスが簡素化され、大規模応用に適しています。
研究者や開発者に対して、効率的かつ柔軟なマルチモーダルソリューションを提供し、マルチタスク拡張をサポートすることを目的としています。
3. 性能表現
Janus-Pro:
GenEval と DPG-Bench ベンチマークテストにおいて、Janus-Pro-7B の精度はそれぞれ 80% と 84.2% に達し、OpenAI の DALL-E 3 と Stable Diffusion47 を上回りました。
マルチモーダル理解タスクで優れたパフォーマンスを発揮し、タスク専用モデルと同等かそれ以上の性能を示しています。
JanusFlow:
画像生成タスクにおいて優れたパフォーマンスを発揮し、生成品質が高く、384x384 解像度に対応しています。
視覚问答、画像注釈などの理解タスクにおいて、性能は専用モデルと同等かそれ以上です。
4. 応用シーン
Janus-Pro:
広告デザイン、ゲーム開発、芸術創作など、高品質な画像生成とマルチモーダル理解を必要とするシナリオに適しています。
研究者や企業開発者など、複数のタスクに柔軟に適応する必要があるユーザーに適しています。
JanusFlow:
スマートアシスタント、バーチャルリアリティなど、高效な生成と理解を必要とする大規模応用やマルチタスク拡張により適しています。
極めてシンプルなアーキテクチャのため、リソースが限られているが高性能モデルを必要とするユーザーに適しています。
5. オープンソースとデプロイ
両モデルともオープンソース化されており、MIT ライセンスに従っています。開発者は GitHub からコードとモデルの重みを取得できます。
Janus-Pro と JanusFlow は技術アーキテクチャ、設計思想、応用シーンにおいてそれぞれ異なる重点を持っています:
Janus-Pro は視覚エンコーディングの分離と統一された Transformer アーキテクチャにより、効率的なマルチモーダル理解と生成を実現し、高品質な画像生成と柔軟なタスク適応を必要とするシーンに適しています。
JanusFlow は生成フローと言語モデルの融合により、極めてシンプルで強力なマルチモーダルフレームワークを提供し、大規模応用やマルチタスク拡張に適しています。
両モデルの発表はマルチモーダル AI 分野に新たなブレークスルーをもたらしました。ユーザーは具体的なニーズに応じて、適切なモデルを選択してデプロイ・活用することができます。









