
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten

JanusFlow: Ein multimodales KI-Modell von DeepSeek
JanusFlow: Ein multimodales KI-Modell von DeepSeekEinführung
DeepSeek-Team hat ein fortschrittliches multimodales KI-Modell vorgestellt, das darauf abzielt, visuelle Verstehens- und Generierungsaufgaben zu vereinheitlichen. Durch die Kombination eines autoregressiven Sprachmodells (LLM) und der Rectified-Flow-Technologie ermöglicht es die gleichzeitige Verarbeitung von Bildverstehen und Text-zu-Bild-Generierung in einem einzigen Modell.
Kernfunktionen
Bildverstehen: Kann Bildinhalte analysieren und relevante Beschreibungen generieren, unterstützt visuelle Fragebeantwortung, Bildannotation und ähnliche Aufgaben.
Text-zu-Bild-Generierung: Erzeugt hochwertige Bilder auf Basis von Textbeschreibungen, geeignet für kreatives Design, Werbung und weitere Bereiche.
Einheitliche multimodale Aufgaben: Integriert Verstehens- und Generierungsaufgaben in einem einzigen Modell und vermeidet so die Komplexität traditioneller Ansätze, bei denen mehrere unabhängige Modelle gepflegt werden müssen.
End-to-End-Training: Das Modell erreicht ein End-to-End-Training, indem der visuelle Encoder direkt mit dem Verstehensframework des autoregressiven Sprachmodells und dem auf Rectified Flow basierenden Generierungsframework verschmolzen wird.
Technische Merkmale
Kombination aus autoregressivem Sprachmodell und Rectified Flow: Durch die Verschmelzung des autoregressiven Sprachmodells mit der Rectified-Flow-Technologie erreicht JanusFlow eine effiziente Bildgenerierungs- und Verstehensfähigkeit. Rectified Flow ist eine auf gewöhnlichen Differentialgleichungen (ODE) basierende Generierungsmethode, die den Trainingsprozess vereinfacht und die Generierungsqualität verbessert.
Entkoppelter visueller Encoder: JanusFlow verwendet für Verstehens- und Generierungsaufgaben jeweils unabhängige visuelle Encoder, um Interferenzen zwischen den Aufgaben zu vermeiden, und verbessert gleichzeitig durch eine Darstellungsabstimmungsstrategie die semantische Konsistenz.
Classifier-Free Guidance (CFG): Während des Bildgenerierungsprozesses nutzt JanusFlow die CFG-Technik, um die Ausrichtung der generierten Bilder an den Textbedingungen zu steuern und so die Bildqualität zu verbessern.
Leistungsfähigkeit
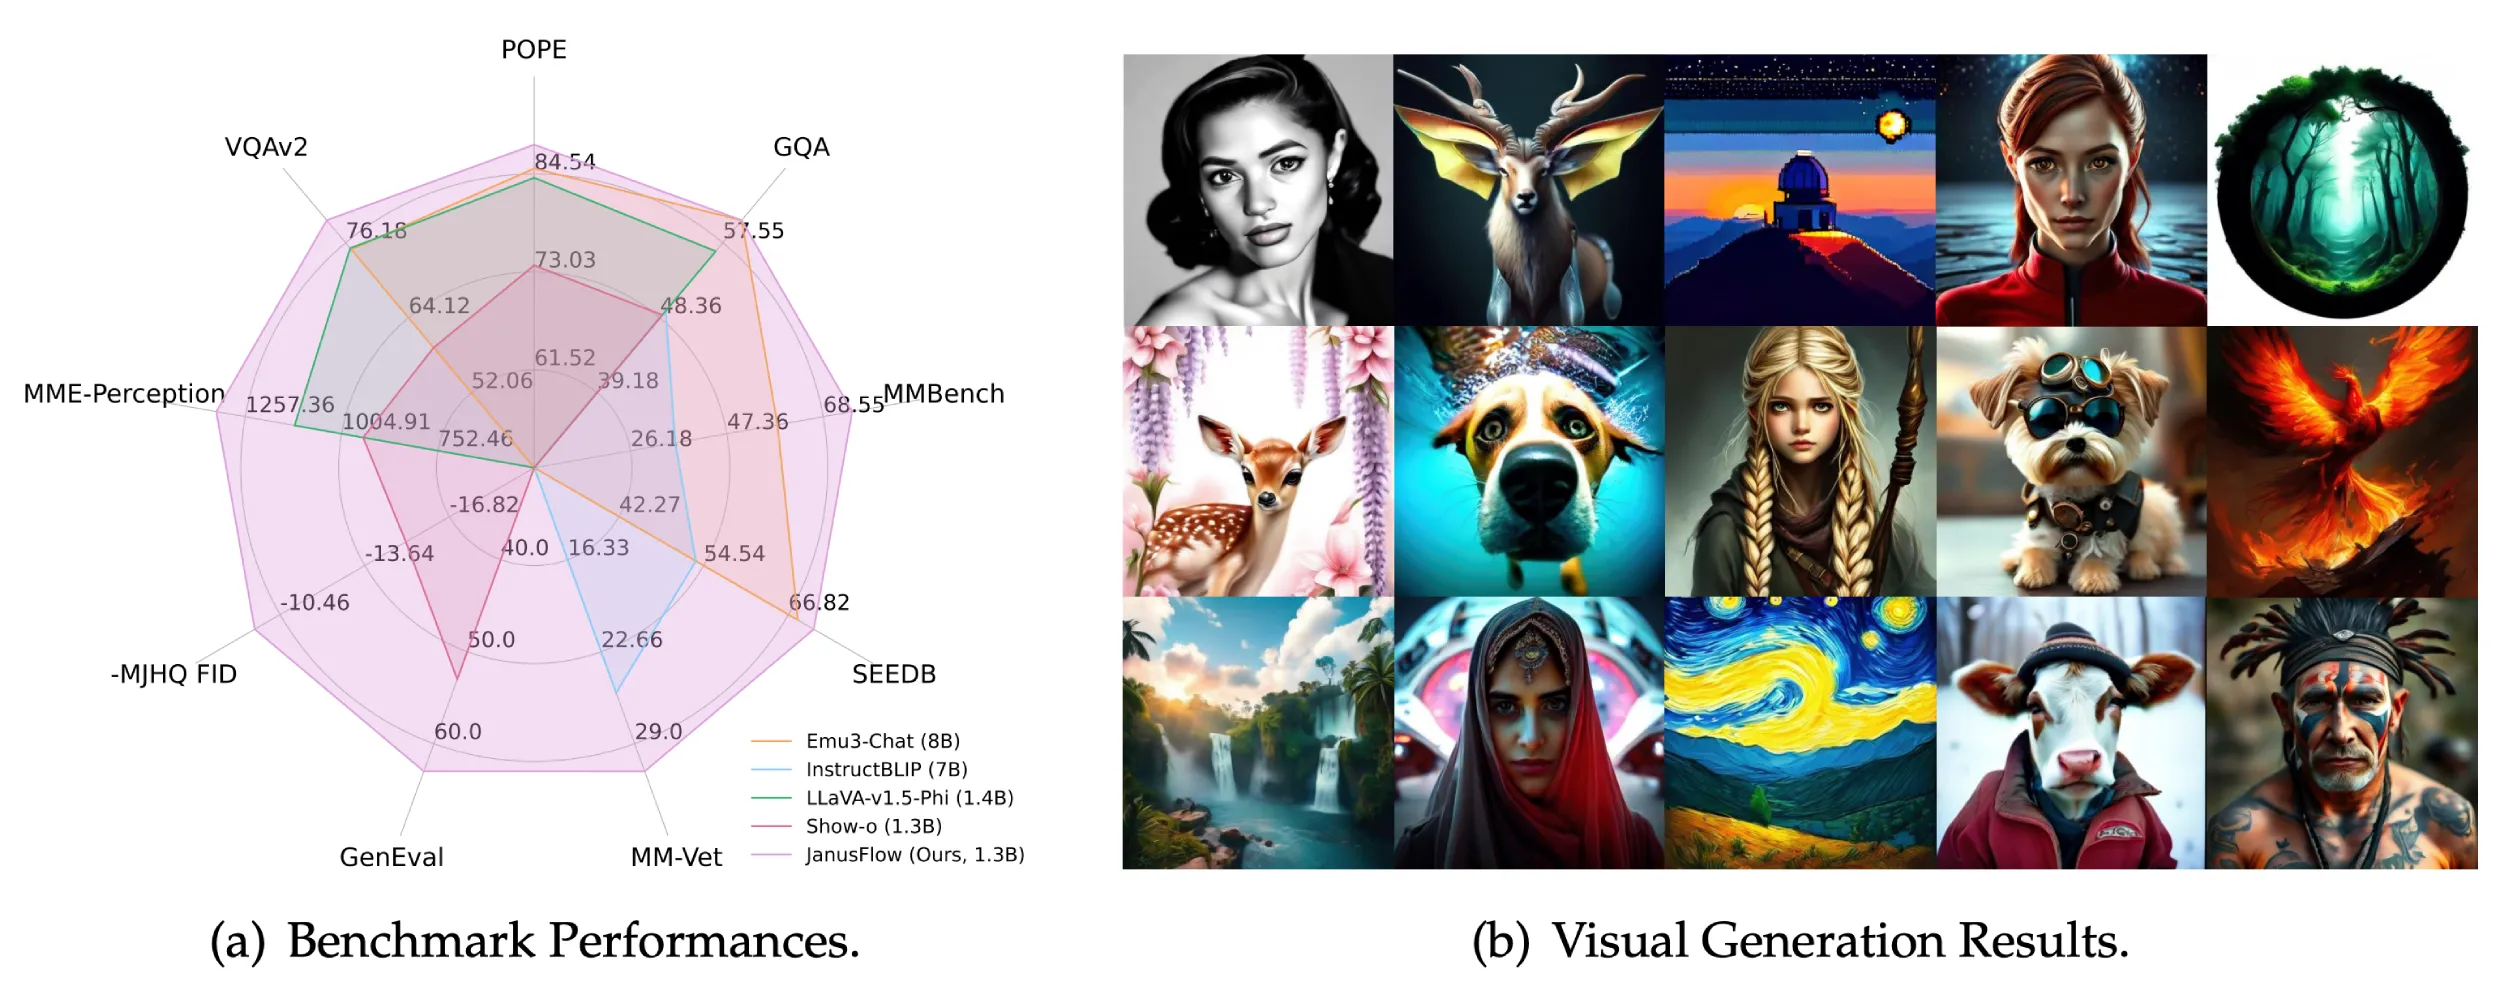
Bildgenerierung: In den GenEval- und DPG-Bench-Tests übertrifft JanusFlow Stable Diffusion v1.5 und SDXL und erreicht in Bezug auf semantische Genauigkeit und visuelle Qualität der erzeugten Bilder eine führende Position29.
Bildverstehen: Bei visuellen Verstehensaufgaben wie MMBench, SeedBench und GQA erzielt JanusFlow Werte von 74.9, 70.5 bzw. 60.3 und übertrifft damit mehrere gleichgroße spezialisierte Modelle.
Technische Vorteile
Das Designkonzept von JanusFlow besteht darin, durch eine schlanke Architektur komplexe Funktionen zu realisieren. Durch die Nutzung vortrainierter visueller Encoder in Kombination mit großen Sprachmodellen werden die Gesamtleistung und Effizienz des Modells gesteigert. Diese innovative Architektur positioniert JanusFlow an der Spitze des multimodalen AI-Bereichs und bietet ein breites Anwendungspotenzial.
Trainingsstrategie
Anpassungsphase: Zufällige Initialisierung der Komponenten und Durchführung eines ersten Trainings, damit die neuen Module effektiv mit dem vortrainierten Modell zusammenarbeiten.
Einheitliches Vortraining: Kombination aus multimodalem Verstehen, Bildgenerierung und reinen Textdaten, mit schrittweiser Erhöhung des Anteils der Generierungsdaten.
Supervised Fine-Tuning (SFT): Feinabstimmung des Modells mittels Instruction-Tuning-Daten, um die Reaktionsfähigkeit und Generierungsqualität weiter zu verbessern.
Anwendungsszenarien
Kreatives Design: Erzeugung hochwertiger Bilder aus Textbeschreibungen, einsetzbar in Werbung, Spieleentwicklung und ähnlichen Bereichen.
Visuelle Fragebeantwortung: Bereitstellung intelligenter, bildbasierter Frage-Antwort-Dienste in Bildung, Museumsführungen und weiteren Bereichen.
Multimodale Inhaltserstellung: Kombination von Text und Bild zur Erzeugung neuer Medieninhalte, geeignet für soziale Medien, Nachrichtenberichte u. v. m.
Open Source und Ressourcen
JanusFlow ist ein Open-Source-Projekt. Die zugehörigen Ressourcen umfassen:
GitHub-Repository: https://github.com/deepseek-ai/Janus
Modell-Download:Hugging Face
Online-Demo: Demo
Wissenschaftliches Paper: arXiv
Verwandte Nachrichten:
Was sind die Unterschiede und Gemeinsamkeiten zwischen Janus-Pro und JanusFlow?
DeepSeek veröffentlicht spät in der Nacht neue multimodale KI-Modelle: Janus-Pro und JanusFlow















