
 脚本プランナー▸
 AIアプリ
 AIニュース
Seed-ASR:バイトダンスの自動音声認識モデル

Seed-ASR:バイトダンスの自動音声認識モデル
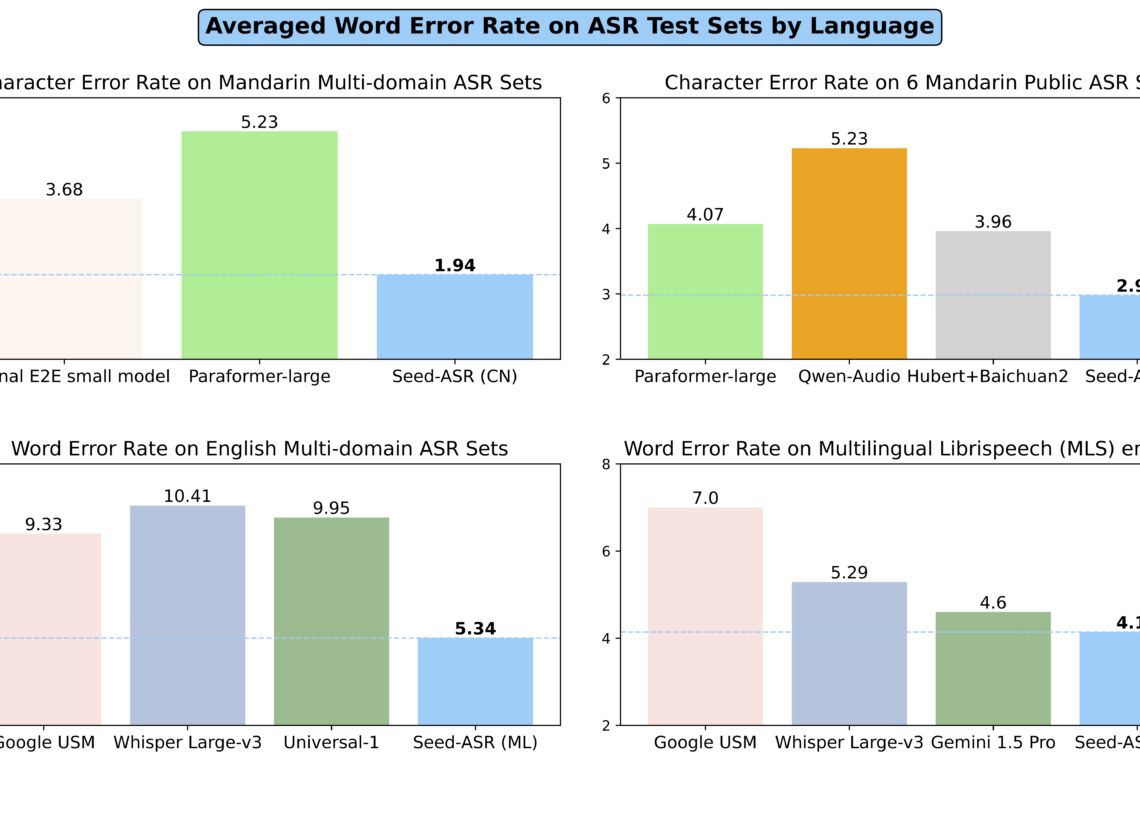
Seed-ASRは、バイトダンスの自動音声認識モデルであり、さまざまな音声をテキスト情報に変換することができます。従来のTTSが単一のタスクを対象としているのとは異なり、Seed-TTSはさまざまな音をモデル化でき、同時に多くの側面から操作することが可能です。異なる言語、方言、アクセント、さらには吃音などの音声上の欠陥も認識できます。Seed-ASRは、2000万時間以上の音声データと約90万時間のペアASRデータでトレーニングされています。普通话だけでなく、13種類の方言と7種類の外国語、およびさまざまなアクセントの英語も認識できます。
Seed-ASRは強力なコンテキスト認識能力を備えており、特定のコンテキスト下での音声内容を識別できます。例えば、モデルは過去の会話や会議記録を利用して、現在の音声中の人名、地名、その他のコンテキストに関連するキーワードをより正確に認識することができます。
Seed-ASRは強力な拡張性を備えています。これは、固定されたシステムではなく、具体的なニーズに応じてカスタマイズ可能なプラットフォームであることを意味します。例えば、医学用語に特化して認識させたい場合や、特定のアクセントを理解させたい場合など、ファインチューニングによって実現できます。
Seed-ASRの中核となる技術は、大規模言語モデルを音声認識に融合させ、Seed-ASRにコンテキスト理解能力を導入したことです。これは単に2つのシステムを組み合わせたものではなく、音声処理の方法を根本から変えるものです。まるで音声認識システムに超強力な脳を搭載したかのようで、聞くだけでなく考えることもできます。
Seed-ASRの技術的なハイライト:
高精度認識:数十億のパラメータを持つモデルで複雑な音声入力を処理し、高精度な認識を実現します。
大容量モデル:大規模言語モデルを使用し、音声認識の精度とコンテキスト理解能力を向上させます。「スーパーコンピュータ」を使ってメモを聞いてもらうようなもので、考えれば考えるほどクールです。
多言語対応:普通话、13種類の方言、および複数の外国語をサポートし、40以上の言語への拡張が計画されています。
コンテキスト認識:コンテキスト情報を組み合わせて認識精度を向上させます。まるで友達とチャットしているときに、以前話した内容を理解し、その情報に基づいて現在の言葉をより正確に理解できるようなものです。
段階的なトレーニング方法:自己教師あり学習、教師ありファインチューニング、コンテキストファインチューニング、強化学習を含み、段階的にモデルの能力を高めます。
Seed-ASRの応用シナリオ:
ヒューマンコンピュータインタラクション:音声入力チャネルを提供し、リアルタイムで音声を文字に変換して入力することで、デバイス/ハードウェア/アプリケーションと迅速かつ便利に対話する目的を達成します。
コンテンツ審査:録音を文字に認識し、品質検査ルールを通じてテキストを分析し、違反コンテンツをタイムリーに発見して処理します。
会議・インタビューの文字起こし:会議やインタビューの音声をリアルタイムまたは非同期で文字に認識し、音声部分を自動的に分割して認識することで、コスト削減と効率化を実現します。
音動画字幕:音声や歌詞を自動でテキストに変換することをサポートし、ワンクリックで音声や動画に対応した字幕コンテンツを生成します。
Seed-ASRは既に豆包(ドウバオ)アプリに適用されており、ユーザーの英語会話、バーチャルチャットパートナー、友人や家族の声の複製など、さまざまなシナリオで使用されています。さらに多くの企業顧客向けに、Seed-ASRは火山エンジンを依托し、音声インタラクション、コンテンツ審査、会議・インタビューの文字起こし、音動画字幕などのシナリオでも実用化されています。
現在まで、豆包大規模モデルチームの音声チームは Seed-TTS 、Seed-ASRなど多くの技術成果をリリースしています。
Seed-ASR公式サイト:https://bytedancespeech.github.io/seedasr_tech_report/









