
 脚本プランナー▸
 AIアプリ
 AIニュース
Seed-TTS:ByteDanceが開発した高品質なテキスト読み上げモデル
小编 ·

Seed-TTS:ByteDanceが開発した高品質なテキスト読み上げモデル
最近、TTS分野が爆発的に盛り上がっています。chatTTSがオープンソース化された直後、Byteがseed-ttsを公開し、素晴らしい効果を発揮しました。
Seed-TTSは、字节跳动が開発した高品質なテキスト読み上げ(TTS)モデルであり、Seed-TTSモデルは人間の音声とほとんど区別がつかない音声を生成することができます。
音声生成の基礎モデルとして、Seed-TTS は音声の文脈学習において優れた性能を発揮し、話者の類似性と自然さに関する性能は、客観的・主観的な評価の両方で実際の人間の音声と一致しています。
Seed-TTSはトレーニングなしで、わずかな音声クリップだけで高度に自然で表現力豊かな音声をクローンして生成でき、小説の読み上げや配音などのタスクにも対応できます。
Seed-TTSは、感情、イントネーション、話し方など、さまざまな音声属性に対する高度な制御機能を提供し、テキストを編集することで生成された音声を編集することもできます。
Seed-TTSは、音声色や音程、感情を保持しながら、オーディオ内の内容を変更することができます。
Seed-TTSは話速の調整が可能で、オーディオの速度を自由に制御できます。
Seed-TTSは、さまざまな音声属性(感情など)に対して卓越した制御性を提供し、野外の話者に対して高度に表現力豊かで多様な音声を生成することができます。
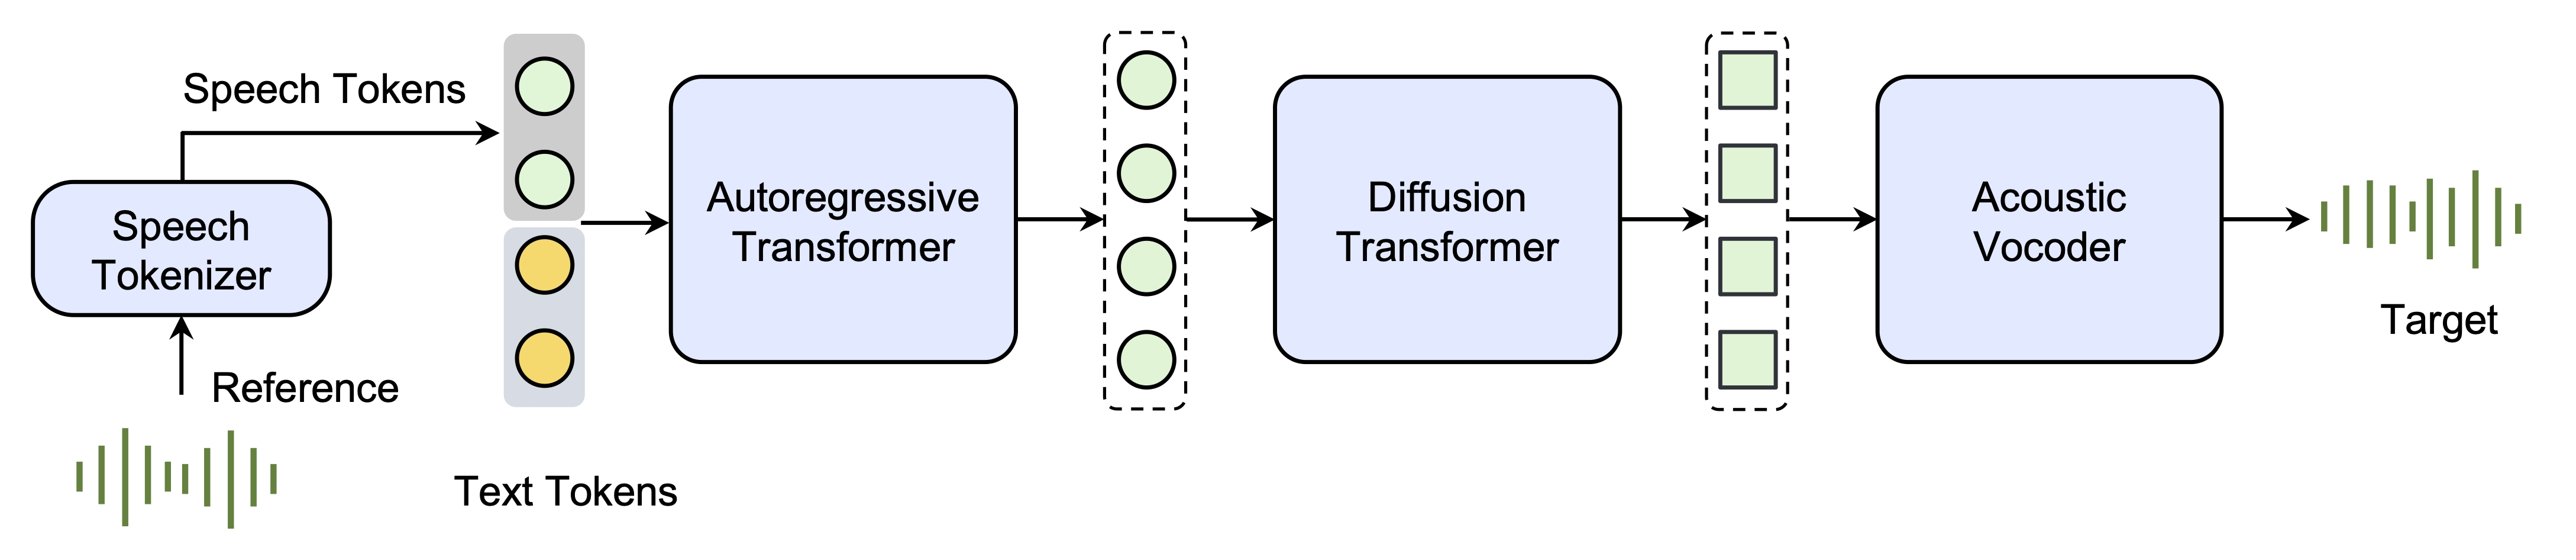
さらに、音声分解のための自己蒸留手法や、モデルの堅牢性、話者の類似性、制御性を強化するための強化学習手法を提案します。また、Seed-TTSモデルの自己回帰的でない(NAR)変種であるSeed-TTS DiTも提案します。これは完全に拡散に基づくアーキテクチャを採用しています。従来のNARベースのTTSシステムとは異なり、Seed-TTS DiTは事前に推定された音素継続時間に依存せず、エンドツーエンドで音声生成を行います。この変種が客観的・主観的な評価の両方で言語モデルベースの変種に匹敵する性能を達成し、音声編集におけるその有効性を実証します。
論文:https://arxiv.org/abs/2406.02430









