
 Assistant scénario▸
 Apps AI
 Actualités AI

IndexTTS : modèle TTS de Bilibili basé sur XTTS et Tortoise
IndexTTS : modèle TTS de Bilibili basé sur XTTS et TortoiseIntroduction
IndexTTS est un modèle de synthèse vocale développé par Bilibili à partir de XTTS et Tortoise, offrant des capacités TTS zero-shot de niveau industriel. Conçu spécifiquement pour le chinois, il adopte une modélisation hybride caractères-pinyin permettant de corriger rapidement les erreurs de prononciation. Il combine un encodeur conditionnel Conformer et un décodeur BigVGAN2, améliorant ainsi la stabilité de l'entraînement, la fidélité de la voix et la qualité sonore du résultat.
Fonctionnalités principales :
✅ Prise en charge du chinois et de l'anglais
✅ Correction pinyin en chinois : saisie du pinyin pour ajuster la prononciation des caractères polyphoniques (par exemple, « 长 » peut être spécifié comme « zhǎng » ou « cháng »)
✅ Contrôle des pauses via la ponctuation : gestion du rythme des pauses vocales à l'aide des signes de ponctuation
✅ Amélioration de la qualité sonore : l'encodeur Conformer extrait les caractéristiques vocales, le décodeur BigVGAN2 améliore la qualité de génération des formes d'onde
✅ Contrôle séparé des émotions : réglage indépendant de l'expression émotionnelle et du timbre du locuteur
✅ Contrôle précis de la durée : prise en charge de deux modes, définition du nombre de repères ou génération autorégressive
Points forts techniques :
✅ Modélisation hybride en chinois : la couche d'entrée accepte une saisie mixte de texte brut et de pinyin, prédit automatiquement le pinyin non annoté et réduit le taux d'erreur sur les mots
✅ Encodeur Conformer : fusion des mécanismes de convolution et d'auto-attention, renforçant la modélisation du timbre et de la prosodie
✅ Décodeur BigVGAN2 : générateur de formes d'onde basé sur une architecture GAN, alliant efficacité de calcul et qualité sonore
Principaux avantages :
✓ Prononciation précise des caractères polyphoniques
✓ Rythme de pauses naturel
✓ Qualité sonore haute fidélité
✓ Clonage vocal rapide
✓ Prise en charge du chinois et de l'anglais
Applications typiques :
La voix synthétisée par IndexTTS est naturelle et émotionnellement expressive, proche de la voix humaine, et convient largement aux scénarios tels que assistants intelligents | livres audio | doublage vidéo | service client intelligent | outils éducatifs.
Performances
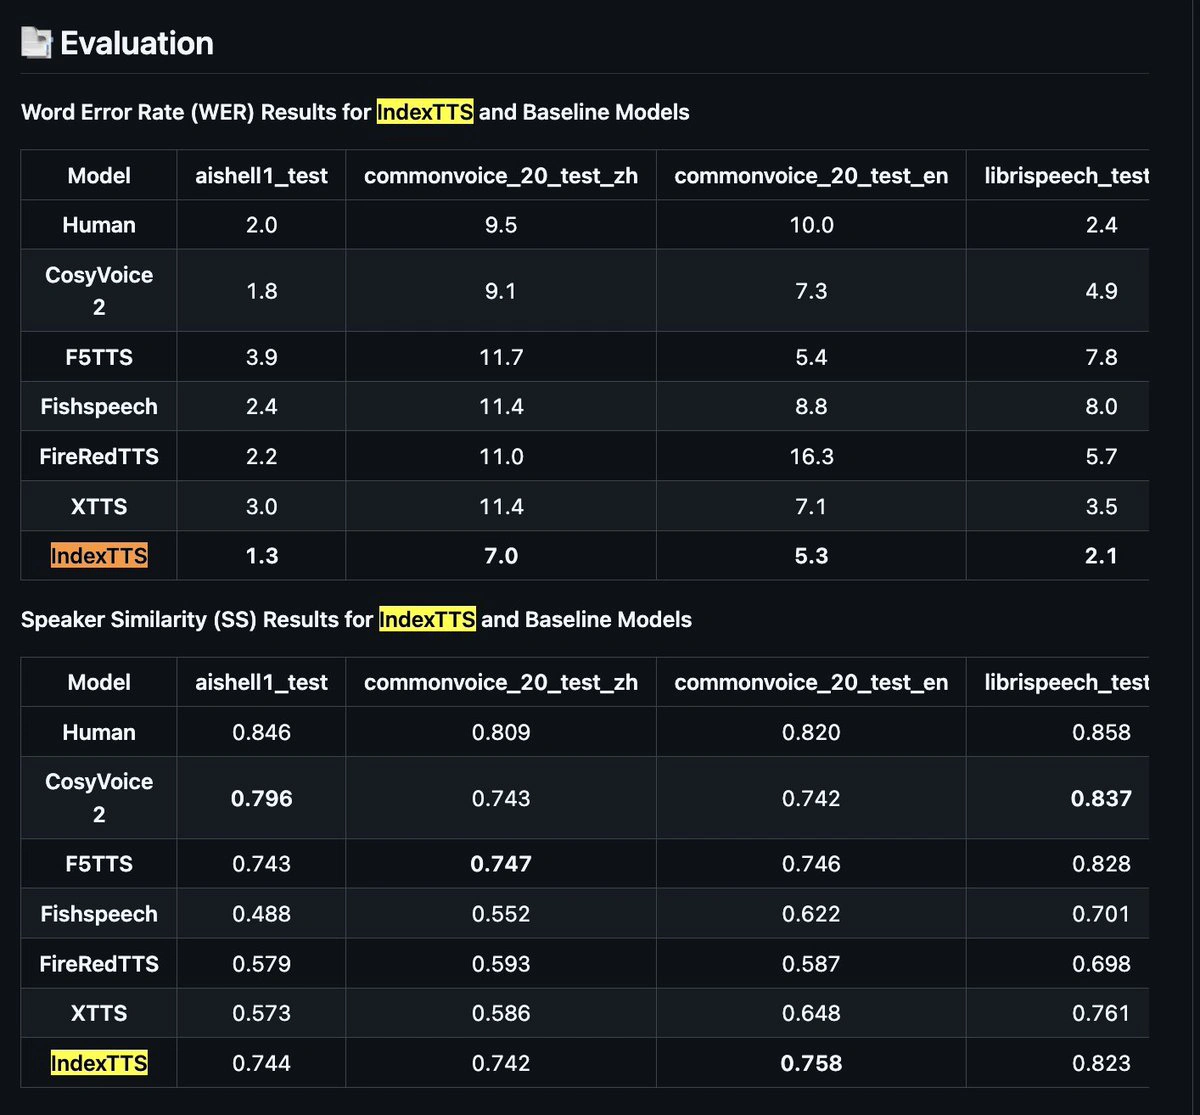
✓ Naturalité et cohérence : en termes de naturalité, de cohérence du contenu et de clonage vocal zero-shot, IndexTTS présente des améliorations significatives par rapport aux modèles existants tels que XTTS.
✓ Efficacité d'entraînement et d'inférence : le processus d'entraînement est relativement simple, la vitesse d'inférence est plus rapide, et les performances dépassent celles des principaux systèmes TTS open source tels que Fish-Speech, CosyVoice2, FireRedTTS, F5-TTS.
✓ Taux d'utilisation du codebook : par rapport à la quantification vectorielle (VQ) et à la quantification de Schur finie (FSQ), le problème d'effondrement du codebook est résolu, avec un taux d'utilisation du codebook proche de 100 %.
Méthode de déploiement :
Cloner le dépôt GitHub
Installer PyTorch et autres dépendances
Préparer et prétraiter les données audio
Entraîner ou charger un modèle pré-entraîné
Ajuster les paramètres et générer les fichiers audio
Adresse du projet :https://github.com/index-tts/index-tts














