
 Assistant scénario▸
 Apps AI
 Actualités AI
Step-Video-T2V : modèle avancé de génération texte-vidéo
Step-Video-T2V : modèle avancé de génération texte-vidéoIntroduction
Step-Video-T2V est un modèle avancé de génération de texte en vidéo, open source, développé en collaboration par StepFun et Geely Auto. Il possède de nombreuses caractéristiques remarquables et démontre une grande puissance dans le domaine de la génération vidéo.
Points forts du modèle Step-Video-T2V
Il utilise le modèle DiT et la méthode d'entraînement par flow matching, permettant une compression spatiale de 16×16 et une compression temporelle de 8×, améliorant considérablement l'efficacité de la génération vidéo à grande échelle.
Avec ses impressionnants 30 milliards de paramètres, il est capable de générer des vidéos de haute qualité d'une résolution pouvant atteindre 544x992.
Il prend en charge les invites en chinois et en anglais, facilitant son utilisation par des utilisateurs de divers horizons linguistiques.
Caractéristiques fonctionnelles de Step-Video-T2V
Paramètres à grande échelle : avec un nombre de paramètres atteignant 30 milliards, le modèle dispose d'une capacité de génération et d'une précision extrêmement élevées, lui permettant de comprendre plus précisément les descriptions textuelles et de les transformer en vidéos de haute qualité.
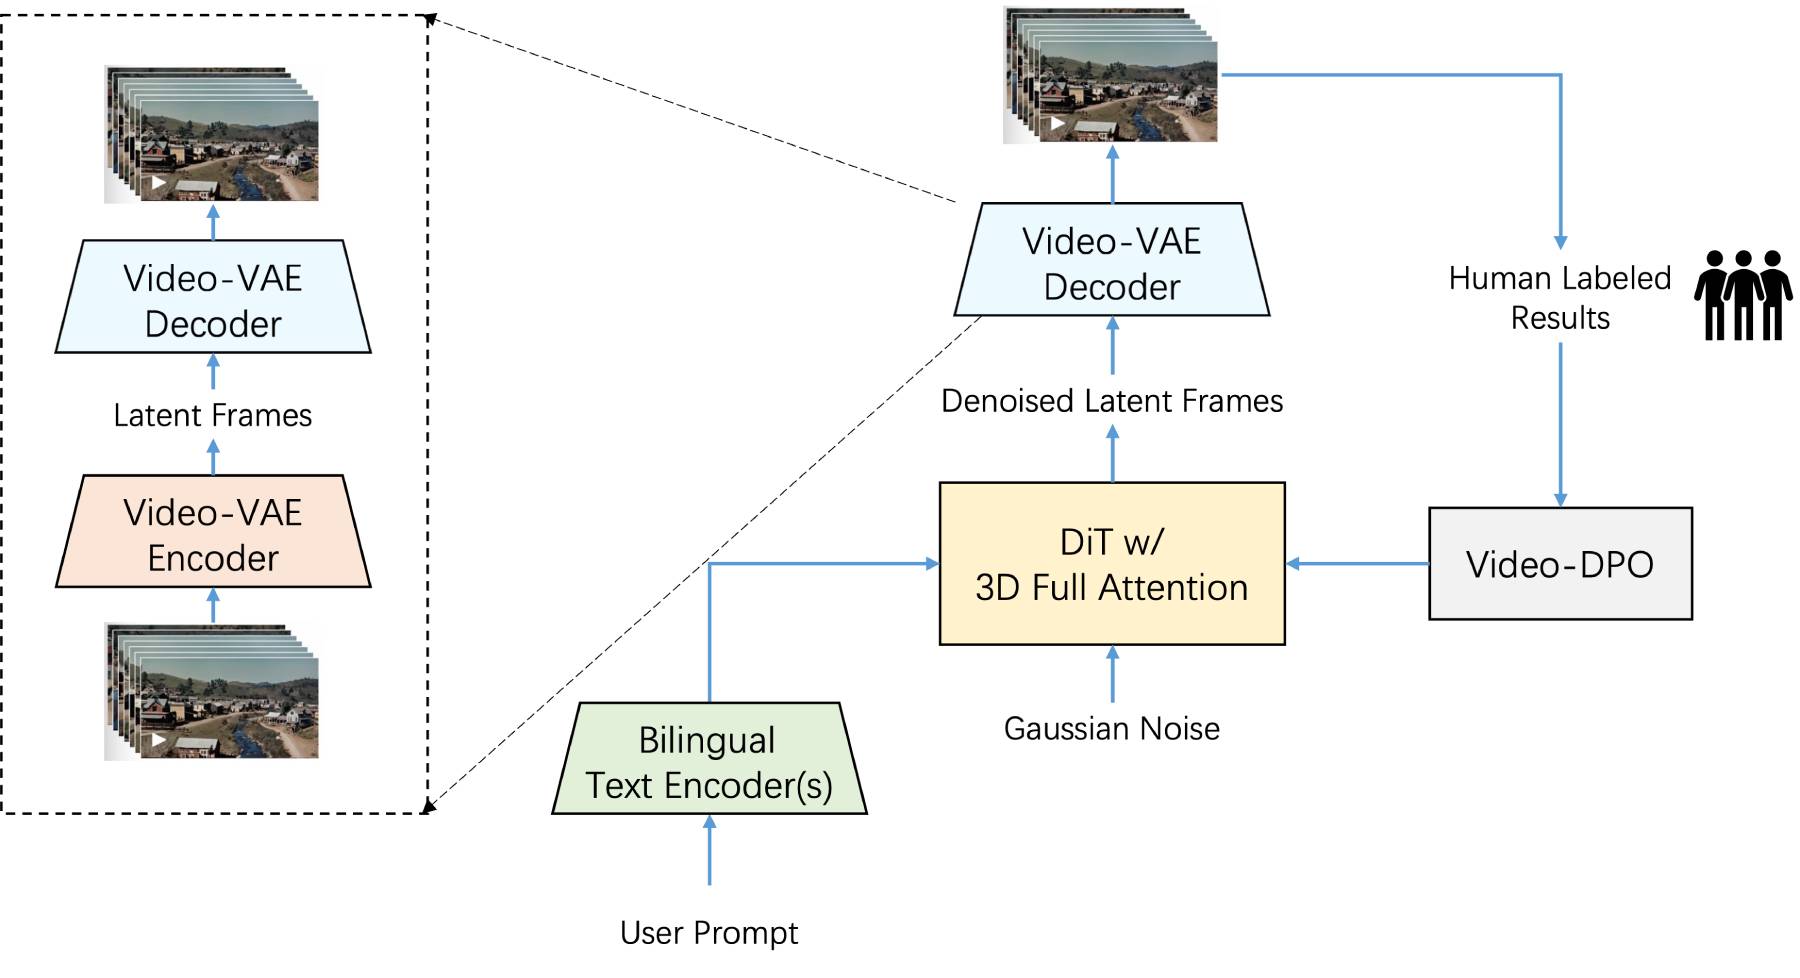
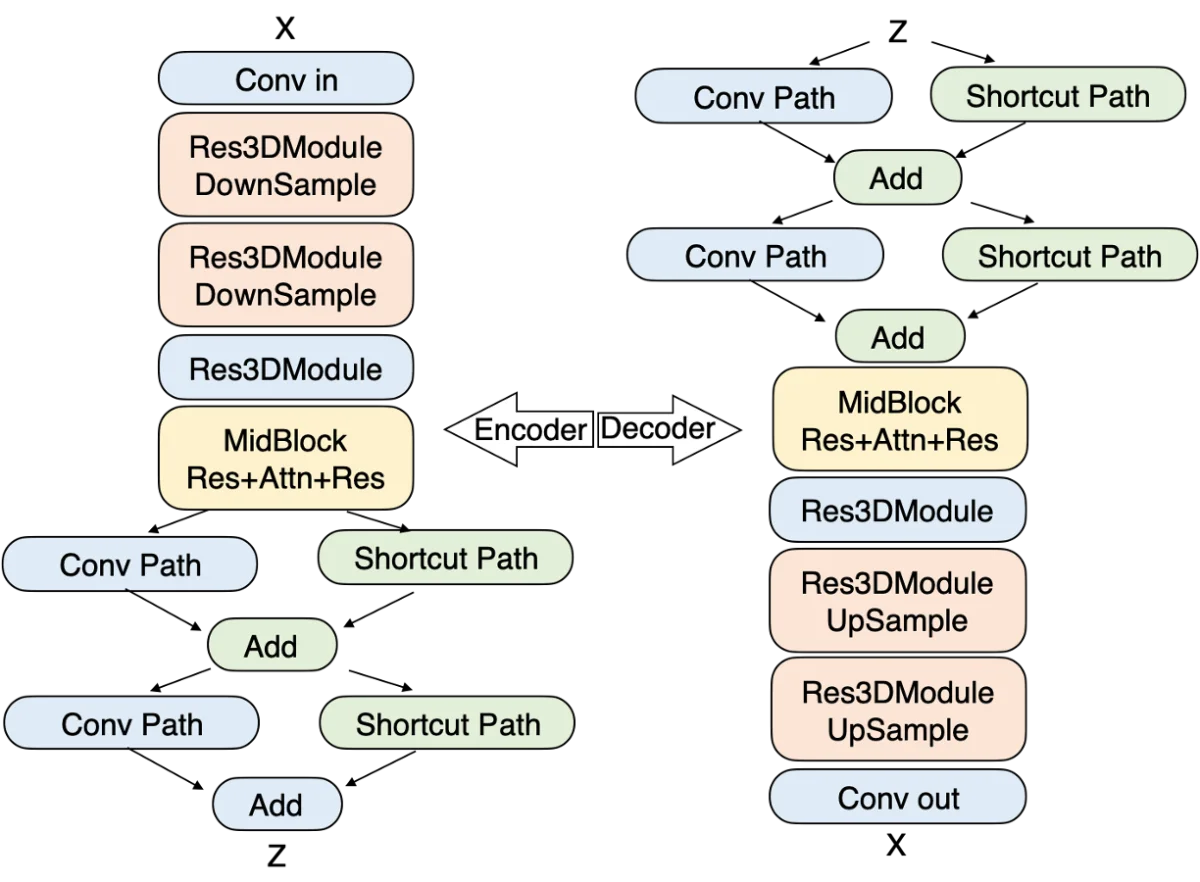
Génération vidéo efficace : il prend en charge la génération de vidéos de haute qualité allant jusqu'à 204 images (544x992 pixels), répondant ainsi à des besoins de création variés. Il utilise un auto-encodeur variationnel à compression profonde (Video-VAE), permettant une compression spatiale de 16×16 et une compression temporelle de 8×, garantissant la qualité vidéo tout en réduisant efficacement les coûts d'entraînement et d'inférence.
Encodeur de texte bilingue : il prend en charge les entrées en chinois et en anglais, et est capable de comprendre en profondeur et de générer du contenu vidéo conforme aux descriptions textuelles, permettant aux utilisateurs de différentes langues d'utiliser le modèle facilement.
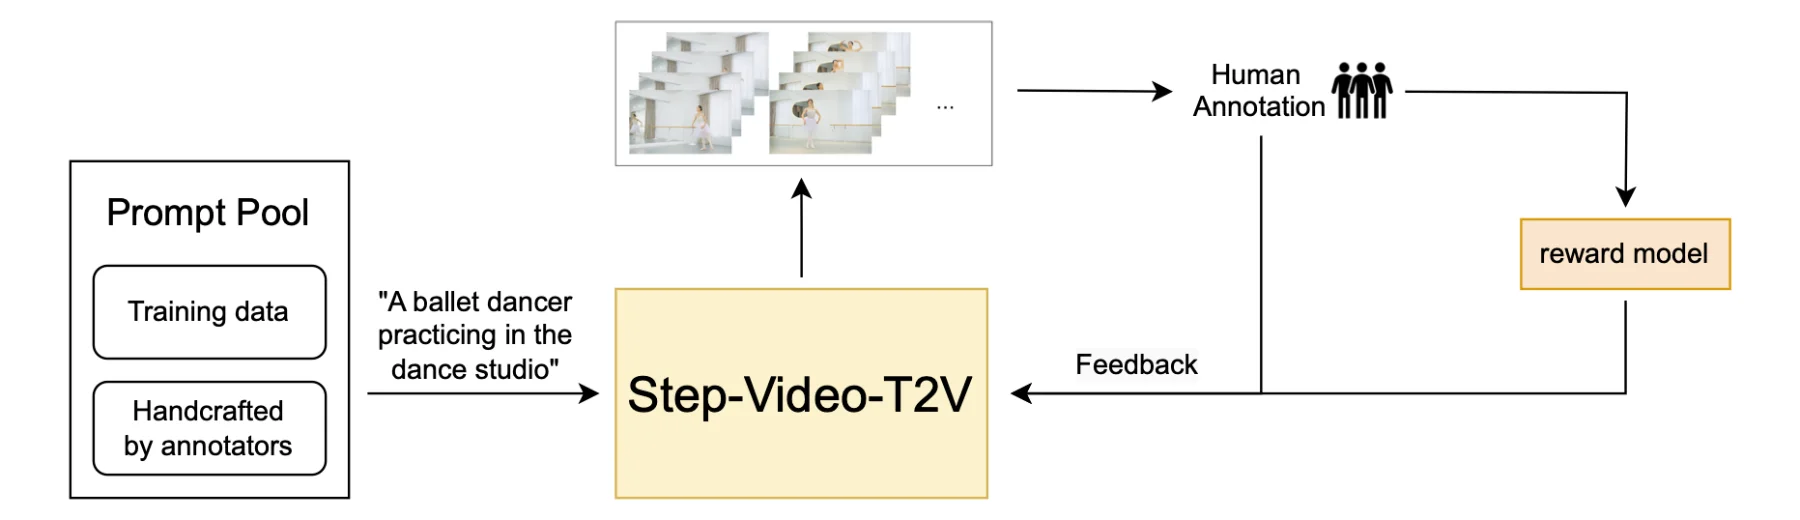
Architecture avancée : il utilise une architecture DiT à attention 3D complète, capable de s'adapter avec flexibilité aux changements de résolution dynamique, garantissant ainsi stabilité et haute qualité de la génération vidéo. Il introduit l'optimisation des préférences vidéo (Direct Preference Optimization, DPO), qui, grâce à un mécanisme de retour humain, améliore encore la qualité et la fluidité des vidéos générées, les rendant plus conformes aux attentes des utilisateurs.
Fusion multimodale : en combinant la compréhension de trois modalités (image, voix et texte), le contenu généré est plus réaliste dans ses détails. Par exemple, les expressions des personnages générés sont plus vivantes, les variations de lumière et d'ombre plus naturelles, et les mouvements des objets dynamiques plus fluides et réalistes.
Modes de fonctionnement flexibles : il propose une version de base (génération en 50 étapes) et une version Turbo (accélération par distillation en 15 étapes) pour répondre aux besoins de performance des différents utilisateurs dans divers scénarios. En pratique, la génération d'une vidéo de 204 images nécessite environ 4 GPU de 80 Go de mémoire vidéo et prend environ 12 minutes.
Cas d'utilisation de Step-Video-T2V
Production vidéo créative : il aide les créateurs de vidéos à générer des scènes complexes et du contenu vidéo créatif raffiné, ce qui le rend particulièrement adapté à la production publicitaire, à la création de vidéos courtes, etc.
Production d'animation et de films : dans les industries de l'animation et du cinéma, il peut être utilisé pour générer des personnages virtuels de haute qualité, des scènes dynamiques et des actions complexes.
Éducation et formation : il permet de produire des vidéos pédagogiques très interactives, rendant le processus d'apprentissage plus vivant et intéressant, et renforçant l'engagement et l'efficacité d'apprentissage des étudiants.
Industrie du divertissement : il peut générer automatiquement des cinématiques de jeux, des bandes-annonces de films et d'autres contenus de divertissement, économisant ainsi beaucoup de temps et de coûts de main-d'œuvre.
Diffusion culturelle : il est particulièrement performant en matière d'esthétique chinoise, capable de générer des peintures à l'encre, des scènes de style ancien, etc., contribuant à la diffusion numérique de la culture traditionnelle et permettant à cette dernière de prendre un nouveau souffle à l'ère moderne.
Comment utiliser Step-Video-T2V :
1. Installer les dépendances :
Installez les bibliothèques Python et les dépendances nécessaires. Généralement, cela peut être fait via pip ou d'autres gestionnaires de paquets .
pip install transformers torch torchvision torchaudio
2. Configurer l'environnement :
Configurez l'environnement matériel requis pour l'exécution. Il est recommandé d'utiliser au moins 4 GPU NVIDIA de 80 Go de mémoire vidéo.
Téléchargez et décompressez les fichiers de poids du modèle dans le répertoire spécifié.
3. Charger le modèle :
Utilisez la bibliothèque Hugging Face Transformers pour charger le modèle pré-entraîné Step-Video-T2V.
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "stepfun-ai/Step-Video-T2V"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
4. Générer une vidéo :
Préparez l'invite textuelle et convertissez-la sous une forme utilisable par le modèle.
Exécutez le script de génération et attendez le résultat.
input_text = "A red-haired woman performing on stage."
inputs = tokenizer(input_text, return_tensors="pt")
# Generate video frames (this is a simplified example; actual implementation may vary)
outputs = model.generate(**inputs, max_length=204)  # Adjust parameters as needed
# Save or display the generated video frames
5. Post-traitement :
Effectuez un post-traitement sur les images vidéo générées, comme l'assemblage en une vidéo complète, l'ajout de l'audio, etc.
Accès aux ressources :
Dépôt GitHub : https://github.com/stepfun-ai/Step-Video-T2V
Démonstration sur Hugging Face : https://huggingface.co/stepfun-ai














