
 Assistant scénario▸
 Apps AI
 Actualités AI
Moshi : convertisseur vocal temps réel open source
Moshi : convertisseur vocal temps réel open sourceIntroduction
Moshi est un modèle Transformer de génération vocale en temps réel multi-flux, prenant en charge la conversation vocale en full-duplex. Sa principale caractéristique est l'entrée et la sortie vocales simultanées (full-duplex), ainsi que sa capacité à gérer des scénarios de conversation complexes, notamment les informations non verbales telles que la voix qui se superpose, les interruptions et les expressions émotionnelles.
Cela signifie qu'il peut écouter et parler en même temps, et vise à résoudre certains problèmes des systèmes de dialogue traditionnels, tels que la latence, la perte d'informations non verbales (comme les émotions) et la structure rigide des tours de parole.
Communication full-duplex : les systèmes de dialogue traditionnels sont à tour de rôle (une personne finit de parler avant que l'autre ne commence). Moshi dépasse cette limitation et prend en charge la communication full-duplex. Cela signifie que Moshi peut générer des réponses vocales pendant que l'utilisateur parle, sans être limité par les tours de parole, et peut gérer des dynamiques de conversation complexes, telles que la voix qui se superpose, les interruptions et les retours rapides.
Traitement multi-flux : Moshi réalise l'écoute et la génération vocale simultanées en traitant plusieurs flux audio. Cette architecture multi-flux lui permet de gérer avec flexibilité les interactions vocales entre l'utilisateur et le système, sans rompre le flux naturel de la conversation.
Par rapport aux systèmes de dialogue vocal traditionnels, Moshi présente plusieurs avantages notables :
Réponse en temps réel : la vitesse de réponse de Moshi est très rapide, avec une latence de seulement 160 à 200 millisecondes, proche de la vitesse de réaction dans une conversation naturelle, offrant ainsi une expérience conversationnelle plus fluide.
Traitement vocal de bout en bout : les systèmes traditionnels reposent généralement sur un processus voix-vers-texte-vers-voix, tandis que Moshi peut traiter directement l'entrée vocale et générer une sortie vocale, préservant les informations non verbales telles que le ton et les émotions.
Dialogue full-duplex : Moshi ne dépend pas d'une alternance stricte des tours de parole, mais peut traiter simultanément les voix de l'utilisateur et du système, ce qui signifie qu'il peut gérer la voix qui se superpose et les interruptions, se rapprochant ainsi de la forme naturelle de la conversation humaine.
Principales caractéristiques de Moshi :
Dialogue vocal en temps réel : Moshi génère directement une sortie audio à partir d'une entrée audio, au lieu de s'appuyer sur le processus traditionnel voix-vers-texte-vers-voix. En traitant directement les données vocales, Moshi préserve les informations non verbales telles que le ton, les émotions, la voix qui se superpose et les interruptions, garantissant une conversation plus naturelle et fluide.
Communication full-duplex : Moshi est capable d'écouter et de parler en même temps, ce qui signifie qu'il peut générer des réponses vocales pendant que l'utilisateur parle, sans alternance stricte des tours de parole. Il peut gérer des scénarios de conversation complexes, tels que la voix qui se superpose et des retours ininterrompus (comme « hmm » ou « je vois ») pouvant être insérés à tout moment.
Faible latence : la latence de Moshi est conçue pour être très faible, théoriquement seulement 160 millisecondes, et en pratique environ 200 millisecondes. Cela signifie que Moshi peut répondre aux entrées de l'utilisateur quasiment en temps réel, offrant une expérience conversationnelle plus fluide.
Méthode du monologue intérieur : Moshi prédit les jetons de texte avant de générer la voix, ce qui améliore considérablement la qualité linguistique et la cohérence de la voix générée. Cela rend non seulement la voix générée plus claire, mais améliore également les capacités de reconnaissance vocale et de synthèse vocale du système dans un environnement de streaming. Moshi introduit un mécanisme de « monologue intérieur » qui permet les fonctionnalités de reconnaissance vocale en continu (ASR) et de synthèse vocale (TTS), prenant en charge le traitement simultané du langage et de l'audio dans un flux de dialogue continu.
Traitement parallèle de plusieurs flux audio : Moshi est capable de traiter simultanément les flux vocaux de l'utilisateur et du système. Cette capacité de traitement multi-flux permet à Moshi non seulement de générer sa propre voix, mais aussi de comprendre et de répondre en temps réel à la voix de l'utilisateur.
Traitement des émotions et de la dynamique vocale : en traitant directement la voix plutôt qu'un texte intermédiaire, Moshi est capable de comprendre et de générer une voix chargée d'émotion, et de gérer des dynamiques de conversation complexes, telles que l'expression des émotions, les variations de voix, etc.
Prise en charge de dynamiques de conversation complexes : Moshi est capable de gérer les dynamiques complexes d'une conversation naturelle, telles que les interruptions, le chevauchement, les interjections et les réponses. Les systèmes traditionnels reposent sur une alternance claire des tours de parole (une personne parle avant que l'autre ne prenne la parole), mais Moshi élimine cette limitation, rendant la conversation plus naturelle.
Architecture du modèle Moshi
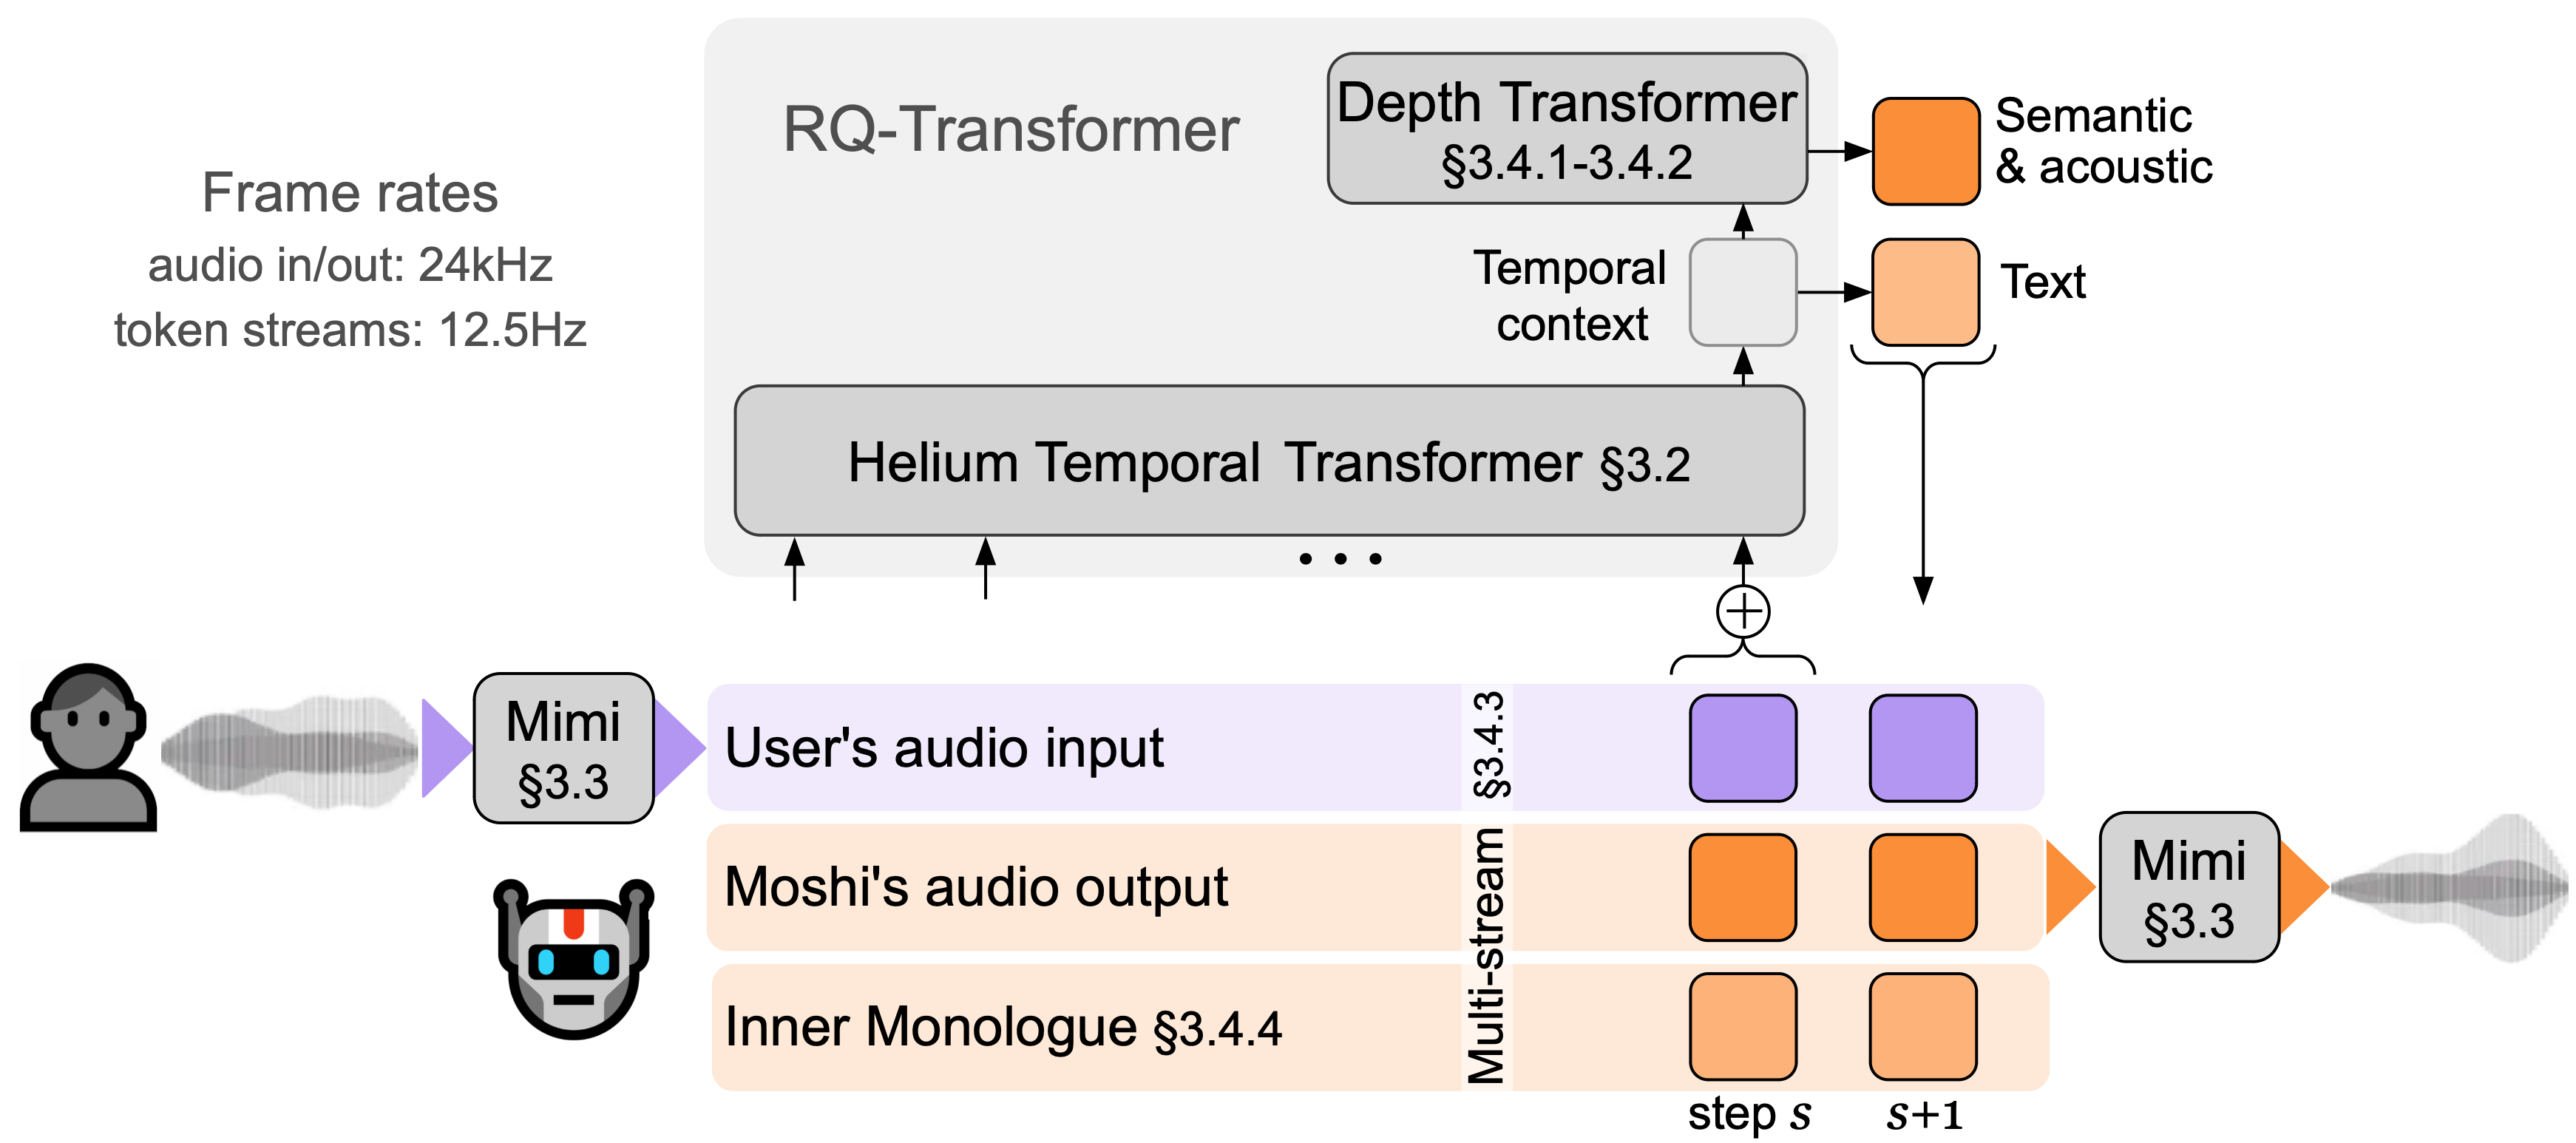
Moshi se compose de trois parties principales : Helium, un modèle de langage 7B entraîné sur 2,1 billions de jetons ; Mimi, un codec audio neuronal qui modélise les informations sémantiques et acoustiques ; et une nouvelle architecture multi-flux qui peut modéliser séparément l'audio de l'utilisateur et celui de Moshi.
Grâce à leur travail协同, ces modules permettent un dialogue full-duplex fluide, l'expression des émotions ainsi que le traitement de dynamiques de conversation complexes.
Modèle de langage textuel Helium
Helium est le cœur de Moshi. Il s'agit d'un modèle de langage textuel doté de 7 milliards de paramètres, basé sur une architecture Transformer (similaire à GPT). Helium fournit à Moshi de puissantes capacités de compréhension et de génération du langage, capable de gérer des tâches complexes de raisonnement textuel et de dialogue.
Ses données d'entraînement comprennent 2,1 billions de mots anglais, ce qui lui confère un large éventail de connaissances et de capacités linguistiques.
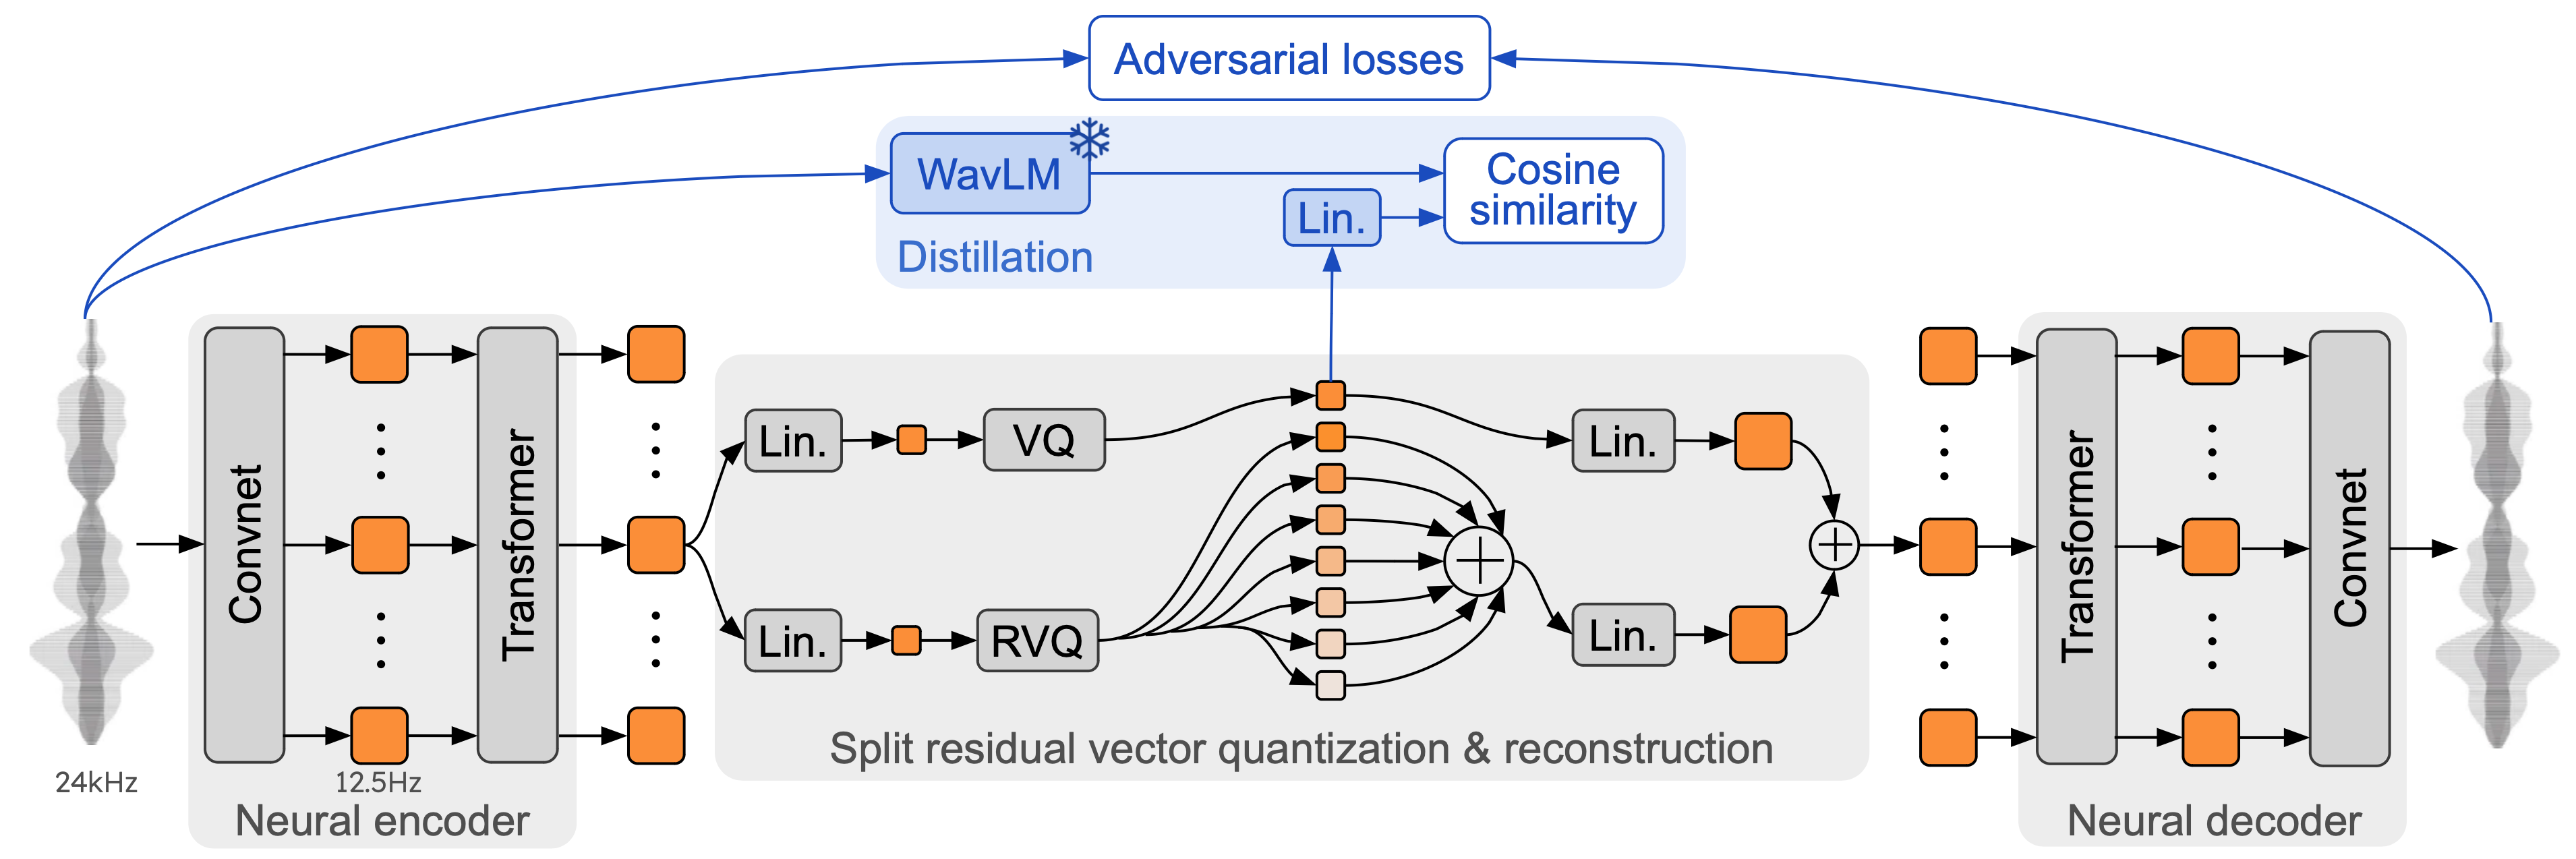
Codec audio neuronal Mimi :Mimi est le composant de traitement audio de Moshi. Il s'agit d'un codec audio neuronal, chargé de convertir l'audio en jetons vocaux discrets et capable de générer inversement une sortie vocale de haute qualité.
Mimi utilise la technique de quantification vectorielle résiduelle (RVQ) pour coder les données vocales en jetons vocaux et sémantiques discrets, garantissant une haute fidélité vocale et une cohérence linguistique.
En combinant les jetons sémantiques et acoustiques, Mimi peut non seulement générer une voix naturelle, mais aussi traiter des contextes vocaux complexes et des informations émotionnelles.
Méthode du monologue intérieur :La méthode du monologue intérieur est la technologie clé de la génération vocale de Moshi, qui permet au modèle de prédire les jetons de texte synchronisés avec l'audio avant de générer la voix. Cette méthode améliore non seulement la qualité linguistique de la voix générée, mais permet également à Moshi de réaliser la reconnaissance vocale et la conversion texte-vers-voix dans un environnement de streaming.
Génération synchronisée de texte et de voix : avant de générer l'audio, Moshi génère un flux de texte correspondant à sa sortie vocale. Ce flux de texte sert de base à la génération vocale, rendant la génération vocale plus précise et aidant à gérer des scénarios de conversation complexes.
Compatibilité avec le streaming : cette méthode permet à Moshi de traiter la voix tout en réalisant une reconnaissance vocale et une synthèse vocale (TTS) efficaces dans un environnement de streaming.
Cette architecture de modèle est conçue pour traiter plusieurs flux audio en parallèle et générer de la voix et du texte en temps réel. Moshi peut générer la voix du système tout en traitant celle de l'utilisateur, ce qui lui permet de prendre en charge une conversation naturelle sans interruption.
Méthodes techniques détaillées de Moshi
1. Architecture de génération voix-vers-voix
L'innovation centrale de Moshi consiste à considérer le dialogue vocal comme une tâche de génération voix-vers-voix, plutôt que comme un processus traditionnel à plusieurs composants texte-vers-voix puis voix-vers-voix. Les systèmes de dialogue vocal traditionnels comprennent plusieurs modules indépendants tels que la détection d'activité vocale (VAD), la reconnaissance vocale (ASR), la compréhension du langage naturel (NLU), la génération de langage naturel (NLG) et la synthèse vocale (TTS).
Moshi génère directement des jetons vocaux, ce qui fait que la voix ne dépend pas d'une représentation textuelle intermédiaire dans le processus de compréhension et de génération, évitant ainsi la perte d'informations (comme les émotions, le ton et les sons non verbaux).
2. Modèle de langage textuel Helium
Moshi est basé sur le modèle de langage textuel Helium, un grand modèle de génération de texte doté de 7B paramètres. Helium est pré-entraîné sur 2,1 billions de données en anglais, avec de puissantes capacités de compréhension, de raisonnement et de génération du langage. Il constitue la base de compréhension sémantique de Moshi, prenant en charge des fonctionnalités complexes de traitement du langage naturel, y compris le dialogue ouvert et les questions-réponses.
Principales caractéristiques de Helium :
Architecture Transformer autorégressive : Moshi est basé sur Helium, un modèle de langage textuel basé sur une architecture Transformer. Semblable au Transformer classique, Helium utilise des mécanismes d'attention multi-couches et une modélisation autorégressive pour traiter les entrées textuelles et générer des sorties. Le modèle possède 7B paramètres, suffisants pour prendre en charge l'apprentissage à grande échelle sur de grands corpus.
Normalisation RMS : la normalisation RMS est utilisée dans les modules d'attention, les modules feed-forward et la couche de sortie, améliorant la stabilité de l'entraînement du modèle.
Encodage positionnel rotatif (RoPE) : utilisé pour traiter des fenêtres de contexte plus longues (4 096 jetons), garantissant que le modèle peut capturer les dépendances à longue distance dans la conversation.
FlashAttention efficace : grâce à un calcul d'attention optimisé, l'inférence du modèle sur de longues séquences d'entrée est plus efficace.
3. Codec audio neuronal Mimi
Mimi est le codec audio neuronal utilisé dans Moshi pour le traitement audio de la voix. Sa mission est de discrétiser les signaux vocaux continus en jetons audio. Ces jetons audio discrets, similaires aux jetons de texte, peuvent représenter des informations détaillées dans la voix. Mimi adopte la technique de quantification vectorielle résiduelle (RVQ), préservant un audio de haute qualité à un débit binaire plus faible, prenant en charge la génération et le traitement vocal en temps réel.
Technologies clés de Mimi :
Quantification vectorielle résiduelle (RVQ) : Mimi utilise une quantification vectorielle résiduelle multi-niveaux pour discrétiser des signaux audio complexes en plusieurs niveaux de jetons audio. Cette méthode permet à chaque pas de temps de coder efficacement les informations sémantiques et acoustiques de la voix, tout en garantissant la qualité de la reconstruction audio.
Combinaison de jetons sémantiques et acoustiques : les jetons audio utilisés par Mimi incluent des informations sémantiques et acoustiques. Les jetons sémantiques préservent le contenu de la voix (par exemple, les mots spécifiques prononcés), tandis que les jetons acoustiques décrivent les caractéristiques audio de la voix, telles que le timbre, l'émotion et l'intonation.
Codage et décodage en streaming : Mimi prend en charge le streaming, permettant une génération et une reconnaissance vocales continues dans des dialogues en temps réel. Cela permet à Moshi de réagir à une vitesse très proche de celle d'une conversation naturelle.
4. Architecture du RQ-Transformer
Moshi adopte une architecture de génération hiérarchique multi-flux, capable de traiter en parallèle plusieurs flux audio. En modélisant simultanément le flux vocal de l'utilisateur et le flux vocal du système lui-même, Moshi permet des interactions flexibles au cours de la conversation, autorisant des dynamiques de dialogue complexes telles que l'entrelacement des locuteurs, les interruptions et les interjections.
Il s'agit d'une architecture proposée précédemment pour la génération d'images discrètes, qui permet de modéliser la hiérarchie des jetons sémantiques et acoustiques sans augmenter la longueur de la séquence d'Helium. Cela signifie que chaque seconde d'audio ne nécessite que 12,5 passages à travers le modèle de base de 7B, permettant un fonctionnement en temps réel sur un L4 ou un MacBook Pro M3 ! Combinée à la latence des jetons de MusicGen, cela offre des performances de pointe pour la modélisation audio du langage.
Modélisation autorégressive hiérarchique : Moshi utilise un RQ-Transformer (Residual Quantizer Transformer) pour décomposer les jetons audio en plusieurs niveaux, et génère l'audio via une modélisation autorégressive hiérarchique. Concrètement, le modèle utilise d'abord un grand Temporal Transformer pour traiter la séquence temporelle, puis un Depth Transformer plus petit pour traiter plusieurs sous-séquences à chaque pas de temps. Cette conception améliore considérablement l'efficacité de la génération de longues séquences audio.
Génération de séquences multimodales : le modèle génère simultanément plusieurs séquences (incluant texte, jetons sémantiques et jetons audio), et garantit leur alignement temporel précis grâce à un mécanisme de monologue interne. Le contenu généré à chaque pas de temps inclut non seulement la voix actuelle, mais également le préfixe textuel correspondant, rendant la voix générée plus logique sur le plan sémantique.
Architecture du RQ-Transformer
5. Le mécanisme de « monologue interne »
Le mécanisme de « monologue interne » de Moshi est l'une des innovations clés de sa génération vocale. Grâce à ce mécanisme, Moshi prédit les jetons textuels temporellement alignés correspondants avant de générer l'audio. Cela améliore non seulement la cohérence linguistique de la voix générée, mais permet également la reconnaissance vocale en temps réel (ASR) et la conversion texte-vers-parole (TTS).
Caractéristiques du mécanisme de « monologue interne » :
Génération alignée de texte et d'audio : Moshi prédit d'abord le texte, puis génère l'audio, rendant la voix produite plus précise et fluide sur le plan grammatical et sémantique.
Mécanisme de latence : en introduisant une latence entre le texte et l'audio, Moshi peut exécuter séparément les tâches d'ASR et de TTS. Par exemple, si le texte est généré en premier puis l'audio, le modèle est en mode TTS ; sinon, il est en mode ASR. Moshi peut basculer de manière transparente entre ces deux modes, garantissant que le modèle peut à la fois générer et reconnaître la parole.
Moshi : Mécanisme de latence
Moshi : Mode TTS
6. Modélisation multi-flux
L'architecture de Moshi permet de traiter simultanément plusieurs flux audio, pouvant à la fois surveiller la voix de l'utilisateur et générer la propre voix du système. Pendant la conversation, Moshi peut gérer dynamiquement les chevauchements de l'audio (comme les interruptions et l'entrelacement) sans avoir à划分 pré定义明确ment les tours de parole. Cette technologie rend la conversation plus naturelle.
Génération synchronisée des jetons sémantiques et acoustiques : Moshi utilise un mécanisme de génération parallèle de jetons sémantiques et audio, et optimise les dépendances entre ces jetons en introduisant un décalage temporel. En modélisant précisément les flux audio de l'utilisateur et du système, Moshi peut gérer avec flexibilité des scénarios de conversation complexes.
Traitement audio double flux : Moshi traite simultanément les flux vocaux de l'utilisateur et du système, et réalise une conversation full-duplex grâce à la modélisation parallèle de deux flux audio autorégressifs. Cette conception permet au modèle de gérer les chevauchements vocaux et les interruptions dans les conversations naturelles.
Alignement par décalage du sémantique et de l'audio : en introduisant un décalage entre les jetons sémantiques et les jetons audio, il garantit que le contenu vocal généré est cohérent et efficace. Le décalage peut être de 1 à 2 trames, selon la dynamique de la conversation.
Moshi : Modélisation multi-flux
7. Entraînement et fine-tuning du modèle
Pré-entraînement à grande échelle : le modèle de langage textuel de Moshi (Helium) possède de riches capacités de compréhension et de génération linguistique grâce à un pré-entraînement sur plus de 2,1 billions de jetons en anglais. Le modèle est entraîné sur de grands volumes de données textuelles et vocales, et peut gérer divers scénarios de conversation complexes.
Entraînement multi-étapes non supervisé et supervisé : Moshi est d'abord pré-entraîné sur de grandes quantités de données vocales non supervisées, puis post-entraîné sur des données multi-flux contenant des conversations naturelles, et enfin soumis à un fine-tuning par instructions pour mieux performer dans les conversations réelles.
Pré-entraînement d'Helium : d'abord, pré-entraîner le modèle de langage textuel Helium sur un grand jeu de données textuelles, afin d'améliorer ses capacités de compréhension linguistique et de raisonnement.
Pré-entraînement de Moshi : entraîner le modèle audio multi-flux sur des jeux de données audio non annotés, pour apprendre à gérer la génération vocale et la compréhension sémantique.
Fine-tuning multi-flux : utiliser le jeu de données Fisher (composé de données de conversation vocale à deux voies) pour affiner le modèle, améliorant sa capacité à traiter les entrées vocales multi-flux.
Fine-tuning par instructions : enfin, affiner le modèle à l'aide de données de dialogues générés par instructions, afin d'améliorer ses performances dans des scénarios de conversation naturelle.
Augmentation de données : pendant l'entraînement, Moshi utilise des techniques d'augmentation de données, telles que l'ajout de bruit de fond et la simulation d'écho utilisateur, permettant au modèle de performer de manière stable dans différents environnements vocaux et renforçant sa robustesse.
Évaluation des performances de Moshi
1. Qualité et cohérence de la génération vocale
Clarté vocale : Moshi excelle dans la génération vocale ; les expériences montrent qu'il peut générer une voix de haute qualité et facile à comprendre. Il peut maintenir la cohérence vocale pendant la génération, en particulier dans les longues conversations, ce qui constitue un indicateur de performance important pour les modèles conversationnels dans des contextes complexes.
Naturel et cohérence de la voix : en utilisant le codec audio neuronal Mimi, Moshi peut générer une voix haute fidélité et maintenir la cohérence de la voix du système. De plus, le modèle est capable de générer un ton émotionnel approprié en fonction des différents contextes conversationnels, améliorant le naturel de l'expérience utilisateur.
2. Performances de réponse en temps réel
Faible latence : la latence théorique de Moshi est de 160 millisecondes, et les tests réels donnent environ 200 millisecondes. Cela signifie que Moshi peut répondre aux entrées utilisateur quasiment en temps réel, améliorant considérablement la fluidité de l'interaction et l'expérience conversationnelle.
Capacité de communication full-duplex : Moshi a démontré lors des tests sa capacité à recevoir et générer simultanément de la voix. Cette fonctionnalité full-duplex lui permet de gérer les chevauchements vocaux et les interruptions de conversation, affichant une vitesse de réponse proche de la conversation humaine naturelle.
3. Reconnaissance vocale et compréhension du dialogue
Reconnaissance automatique de la parole (ASR) : grâce à l'approche du monologue interne, Moshi combine les flux textuels et vocaux, améliorant significativement la précision de la reconnaissance vocale. Le modèle capture non seulement les entrées vocales de l'utilisateur, mais renforce également la précision des réponses du système en générant d'abord une prédiction textuelle.
Capacités de compréhension et de raisonnement du dialogue : Moshi utilise le modèle de langage Helium pour la compréhension textuelle et le raisonnement, ce qui lui permet de bien performer dans le traitement de questions complexes, les dialogues ouverts et les questions-réponses de connaissance. Les résultats expérimentaux montrent que Moshi peut comprendre efficacement le contexte et fournir des réponses raisonnables.
4. Robustesse du traitement vocal multi-flux
Traitement des chevauchements vocaux : Moshi est capable de gérer, lors de l'évaluation, des scénarios de conversation complexes, tels que des conversations avec chevauchement de plusieurs flux vocaux. Ceci est très important pour le multitâche dans les applications réelles, car les conversations naturelles impliquent souvent des interruptions et des chevauchements de voix.
Traitement des conversations multi-contextes : Moshi est entraîné sur plusieurs flux de données et peut bien performer dans différents scénarios de conversation, qu'il s'agisse du flux vocal d'un utilisateur unique ou de conversations simultanées avec plusieurs utilisateurs.
5. Questions-réponses et acquisition de connaissances
Moshi surpasse les autres systèmes de dialogue vocal actuels dans les tâches de questions-réponses et d'acquisition de connaissances. Grâce à ses solides capacités de compréhension textuelle et de génération vocale en temps réel, Moshi peut gérer des sessions de questions-réponses multi-tours, extrayant et répondant précisément aux questions des utilisateurs.
Reasonnement langagier et questions de bon sens : le modèle est capable de traiter des tâches de raisonnement complexes et performe bien dans diverses évaluations standard du traitement du langage naturel (NLP), telles que les questions de bon sens, la compréhension de lecture et les questions ouvertes.
6. Émotion vocale et génération personnalisée
Génération vocale émotionnelle : Moshi a démontré lors des évaluations sa capacité à générer une voix émotionnelle. Il peut produire des sorties vocales avec différentes émotions (comme la colère, la joie ou la tristesse) en fonction du contexte de la conversation.
Style vocal personnalisé : grâce au fine-tuning par instructions pendant l'entraînement, Moshi peut générer différents styles de voix ou des rôles spécifiques selon les besoins de l'utilisateur. Cette capacité de personnalisation lui permet de se montrer plus polyvalent dans des scénarios de conversation spécifiques.
7. Sécurité et fiabilité
Évaluation de la sécurité des dialogues : Moshi fait preuve d'une bonne sécurité dans le traitement des conversations contenant du contenu sensible ou inapproprié. Il est capable d'identifier efficacement et d'éviter de générer du contenu inapproprié, garantissant la sécurité et l'éthique de la conversation.
Robustesse et adaptation aux environnements bruyants : dans les évaluations en environnement bruyant et complexe, Moshi a démontré une bonne robustesse. Grâce à des techniques d'augmentation de données (telles que l'ajout de bruit et le traitement de l'écho), le modèle peut faire face à différents environnements vocaux et garantir une sortie de haute qualité dans des conditions bruyantes.
Huit. Résultats des tests complets
Les tests de performance complets de Moshi montrent qu'il obtient des résultats de pointe en génération vocale, compréhension du dialogue, réponse en temps réel et traitement de conversations complexes. En particulier, Moshi surpasse largement les systèmes conversationnels traditionnels dans la gestion des conversations qui se chevauchent, des interruptions vocales et de la génération émotionnelle.
Rapport technique : https://kyutai.org/Moshi.pdf
GitHub : https://github.com/kyutai-labs/moshi
Téléchargement du modèle : https ://huggingface.co/collections/kyutai/moshi-v01-release-66eaeaf3302bef6bd9ad7acd
Essai en ligne : https://moshi.chat/
Actualités connexes :














