
 Assistant scénario▸
 Apps AI
 Actualités AI
YOLO-World : détection d'objets à vocabulaire ouvert en temps réel
YOLO-World : détection d'objets à vocabulaire ouvert en temps réelIntroduction
YOLO-World, un outil de détection d'objets en temps réel développé par le laboratoire d'IA de Tencent, est capable d'identifier et de localiser automatiquement divers objets dans une image. YOLO-World surpasse de nombreuses méthodes de pointe en termes de vitesse et de précision.
YOLO-World est le détecteur YOLO de nouvelle génération, conçu pour la détection d'objets en vocabulaire ouvert en temps réel. YOLO-World a été pré-entraîné sur de grands ensembles de données vision-langage (notamment Objects365, GQA, Flickr30K et CC3M), ce qui lui confère de solides capacités de détection en vocabulaire ouvert zero-shot et de localisation dans les images, permettant la détection d'objets en temps réel sans entraînement. Même si certains objets n'ont jamais été vus auparavant, YOLO-World convient à la détection d'objets et à la segmentation d'instances en vocabulaire ouvert.
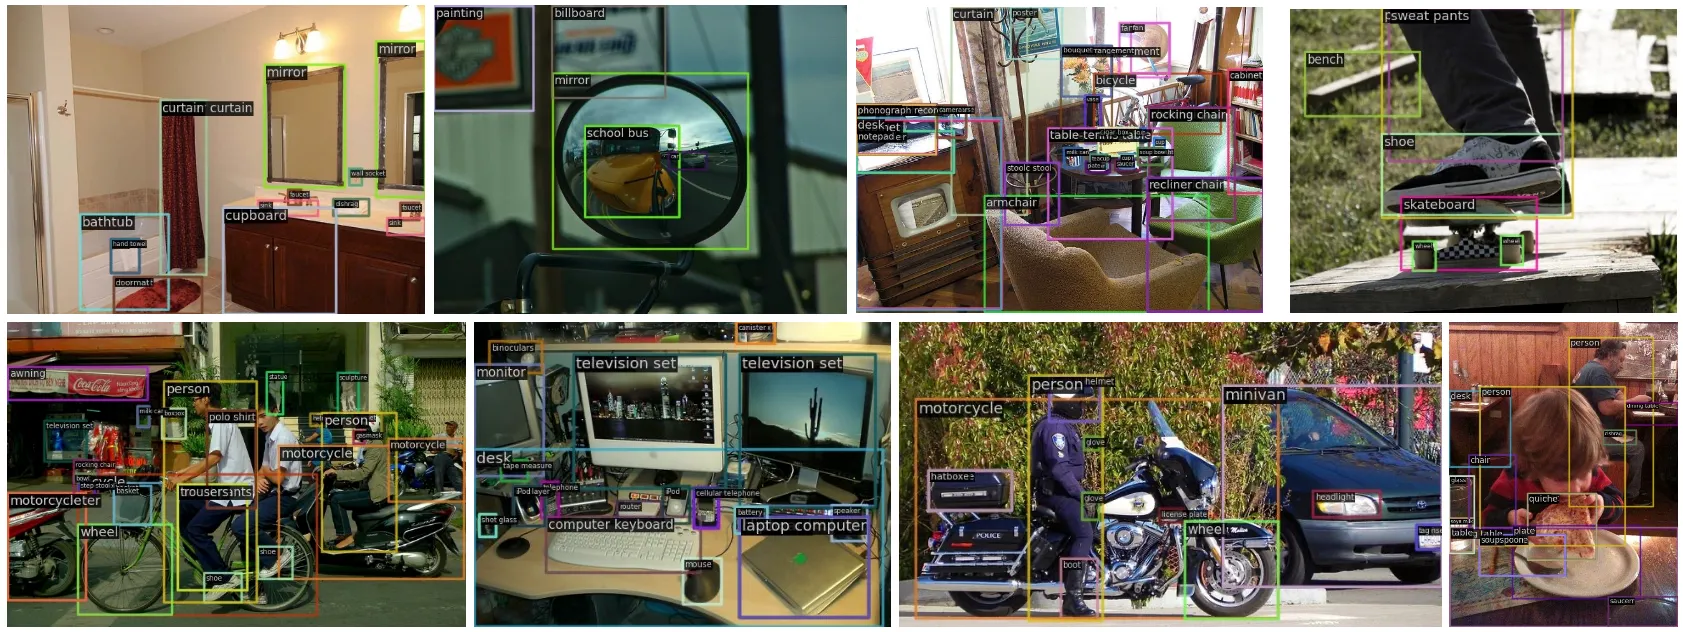
Fonctionnalités et caractéristiques de YOLO-World :
1. Apprentissage à grande échelle : YOLO-World acquiert de riches connaissances visuelles et linguistiques en apprenant à partir d'un grand nombre d'images accompagnées de descriptions correspondantes (telles que des noms d'objets), ce qui lui permet de reconnaître une grande variété d'objets.
Le projet a été pré-entraîné sur de grands ensembles de données vision-langage, notamment Objects365, GQA, Flickr30K et CC3M, dotant YOLO-World de solides capacités zero-shot en vocabulaire ouvert et de localisation dans les images.
2. Rapide et précis : YOLO-World atteint 35,4 AP lors de l'évaluation zero-shot sur l'ensemble de données LVIS, avec une vitesse de traitement de 52,0 FPS sur V100, surpassant de nombreuses méthodes de pointe en termes de vitesse et de précision. Il maintient une précision élevée même sur des images contenant des scènes complexes. YOLO-World prétend être 20 fois plus rapide que GroundingDINO.
3. Détection zero-shot : plus impressionnant encore, même si certains objets n'ont jamais été rencontrés auparavant, YOLO-World peut, grâce à ses apprentissages et capacités de compréhension préalables, identifier et localiser avec succès ces nouveaux objets à partir d'indices contextuels présents dans l'image. Cela signifie qu'il n'est pas nécessaire de l'entraîner pour détecter une nouvelle catégorie d'objets. Il suffit de fournir le nom de la classe sous forme d'invite textuelle, et le modèle renverra les boîtes englobantes de ces objets (s'ils existent).
4. Compréhension des objets : YOLO-World ne se limite pas aux informations visuelles, mais intègre également des informations linguistiques. Il comprend les descriptions en langage humain, ce qui lui permet d'identifier des objets même s'il ne les a jamais vus directement auparavant.
5. Par rapport aux méthodes existantes de détection en vocabulaire ouvert, le modèle YOLO-World est au moins 20 fois plus rapide. Il peut traiter environ 52 images par seconde.
6. Il établit un nouvel état de l'art sur l'ensemble de données LVIS pour la détection d'objets.














