
 Assistant scénario▸
 Apps AI
 Actualités AI
MoshiVis : un modèle vision-parole qui écoute, voit et discute d'images avec une voix fluide
小编 ·

MoshiVis : un modèle vision-parole qui écoute, voit et discute d'images avec une voix fluide
Qu'est-ce que MoshiVis ?
MoshiVis est un modèle vocal visuel-vision développé à partir de Moshi, qui conserve la faible latence et la capacité de conversation naturelle de Moshi, permettant de discuter du contenu des images dans un style de conversation naturelle. Il prend en charge les conversations à plusieurs tours, peut décrire le contenu textuel des images et répondre aux questions relatives aux images.
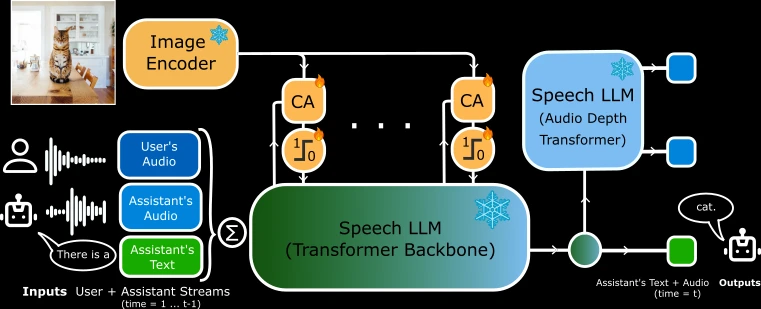
Il intègre les informations visuelles dans le flux vocal grâce à un mécanisme d'attention croisée, tout en maintenant une faible latence et une faible empreinte mémoire. MoshiVis offre plusieurs supports de backend (tels que PyTorch, Rust, MLX), et publie des modèles pré-entraînés ainsi qu'un ensemble de données synthétiques de dialogues visuels, adaptés aux scénarios d'interaction vocale en temps réel.
Fonctionnalités principales de MoshiVis
Combinaison de la vision et de la voix : MoshiVis ajoute une capacité de compréhension visuelle à Moshi, permettant d'intégrer les informations des images dans la conversation vocale. En étendant l'architecture Transformer principale, il introduit un mécanisme d'attention croisée pour injecter les informations visuelles dans le flux vocal.
Faible latence et faible empreinte mémoire : afin de maintenir une faible latence et de réduire l'utilisation de la mémoire, les poids de projection de l'attention croisée de MoshiVis sont partagés entre les couches, et un mécanisme de porte (gating) régule le flux d'entrée visuelle.
Style de conversation naturelle : tout en intégrant les capacités visuelles, le modèle conserve le style de conversation naturelle d'origine de Moshi.
Architecture technique de MoshiVis
Modèle de base : basé sur Moshi, un modèle de base voix-texte de 7B paramètres.
Encodeur visuel : utilise un encodeur visuel pré-entraîné et gelé de 400M de la famille PaliGemma2.
Paramètres de l'adaptateur : environ 206M paramètres d'adaptateur ont été ajoutés à Moshi pour le traitement des informations visuelles.
Mécanisme d'attention croisée : un module d'attention croisée injecte les informations visuelles dans le flux vocal, tandis qu'un mécanisme de porte régule l'influence de l'entrée visuelle.
Publication du modèle MoshiVis
Variantes du modèle : un modèle MoshiVis basé sur Moshika (voix féminine) a été publié, comprenant les poids complets du modèle, y compris le codec vocal, le tokeniseur de texte, l'encodeur d'images et le modèle Moshi de base.
Support des backends : trois backends sont pris en charge, notamment PyTorch, Rust et MLX, avec différents formats de quantification (tels que BF16, Q8_0, etc.).
Licence : les poids du modèle (à l'exception de l'encodeur visuel) sont publiés sous la licence CC-BY 4.0, et l'encodeur visuel est publié sous la licence Gemma.
Comment utiliser MoshiVis
Frontend WebUI : un frontend WebUI est fourni, prenant en charge la suppression d'écho pour améliorer les performances du modèle. Les utilisateurs peuvent utiliser une version statique préconstruite ou compiler eux-mêmes le code source.
Exécution du backend :
PyTorch : nécessite environ 24 Go de mémoire GPU, ne prend pas en charge la quantification.
Rust : prend en charge l'accélération GPU, nécessite la chaîne d'outils Rust et CUDA (ou Metal sur macOS).
MLX : prend en charge les formats bfloat16 et quantifiés (q4, q8).
Commandes d'exécution : des commandes d'exécution détaillées sont fournies, les utilisateurs peuvent choisir différents backends et formats de quantification selon leurs besoins.
Liens connexes :
Projet GitHub :https://github.com/kyutai-labs/moshivis
Modèle HuggingFace :https://huggingface.co/collections/kyutai/moshivis-v01-67cef4acae6a5d75d6d6c883
Démo :https://vis.moshi.chat/
Papier :https://arxiv.org/abs/2503.15633









