
 Assistant scénario▸
 Apps AI
 Actualités AI
Janus-Pro vs. JanusFlow : quelles différences et similarités ?
小编 ·

Janus-Pro vs. JanusFlow : quelles différences et similarités ?
Janus-Pro et JanusFlow sont deux modèles IA multimodaux publiés par DeepSeek . Bien qu'ils soient tous deux axés sur les tâches de compréhension et de génération d'images, ils présentent des différences assez marquées en termes d'architecture technique, de philosophie de conception et de scénarios d'application. Voici une présentation de leurs différences :
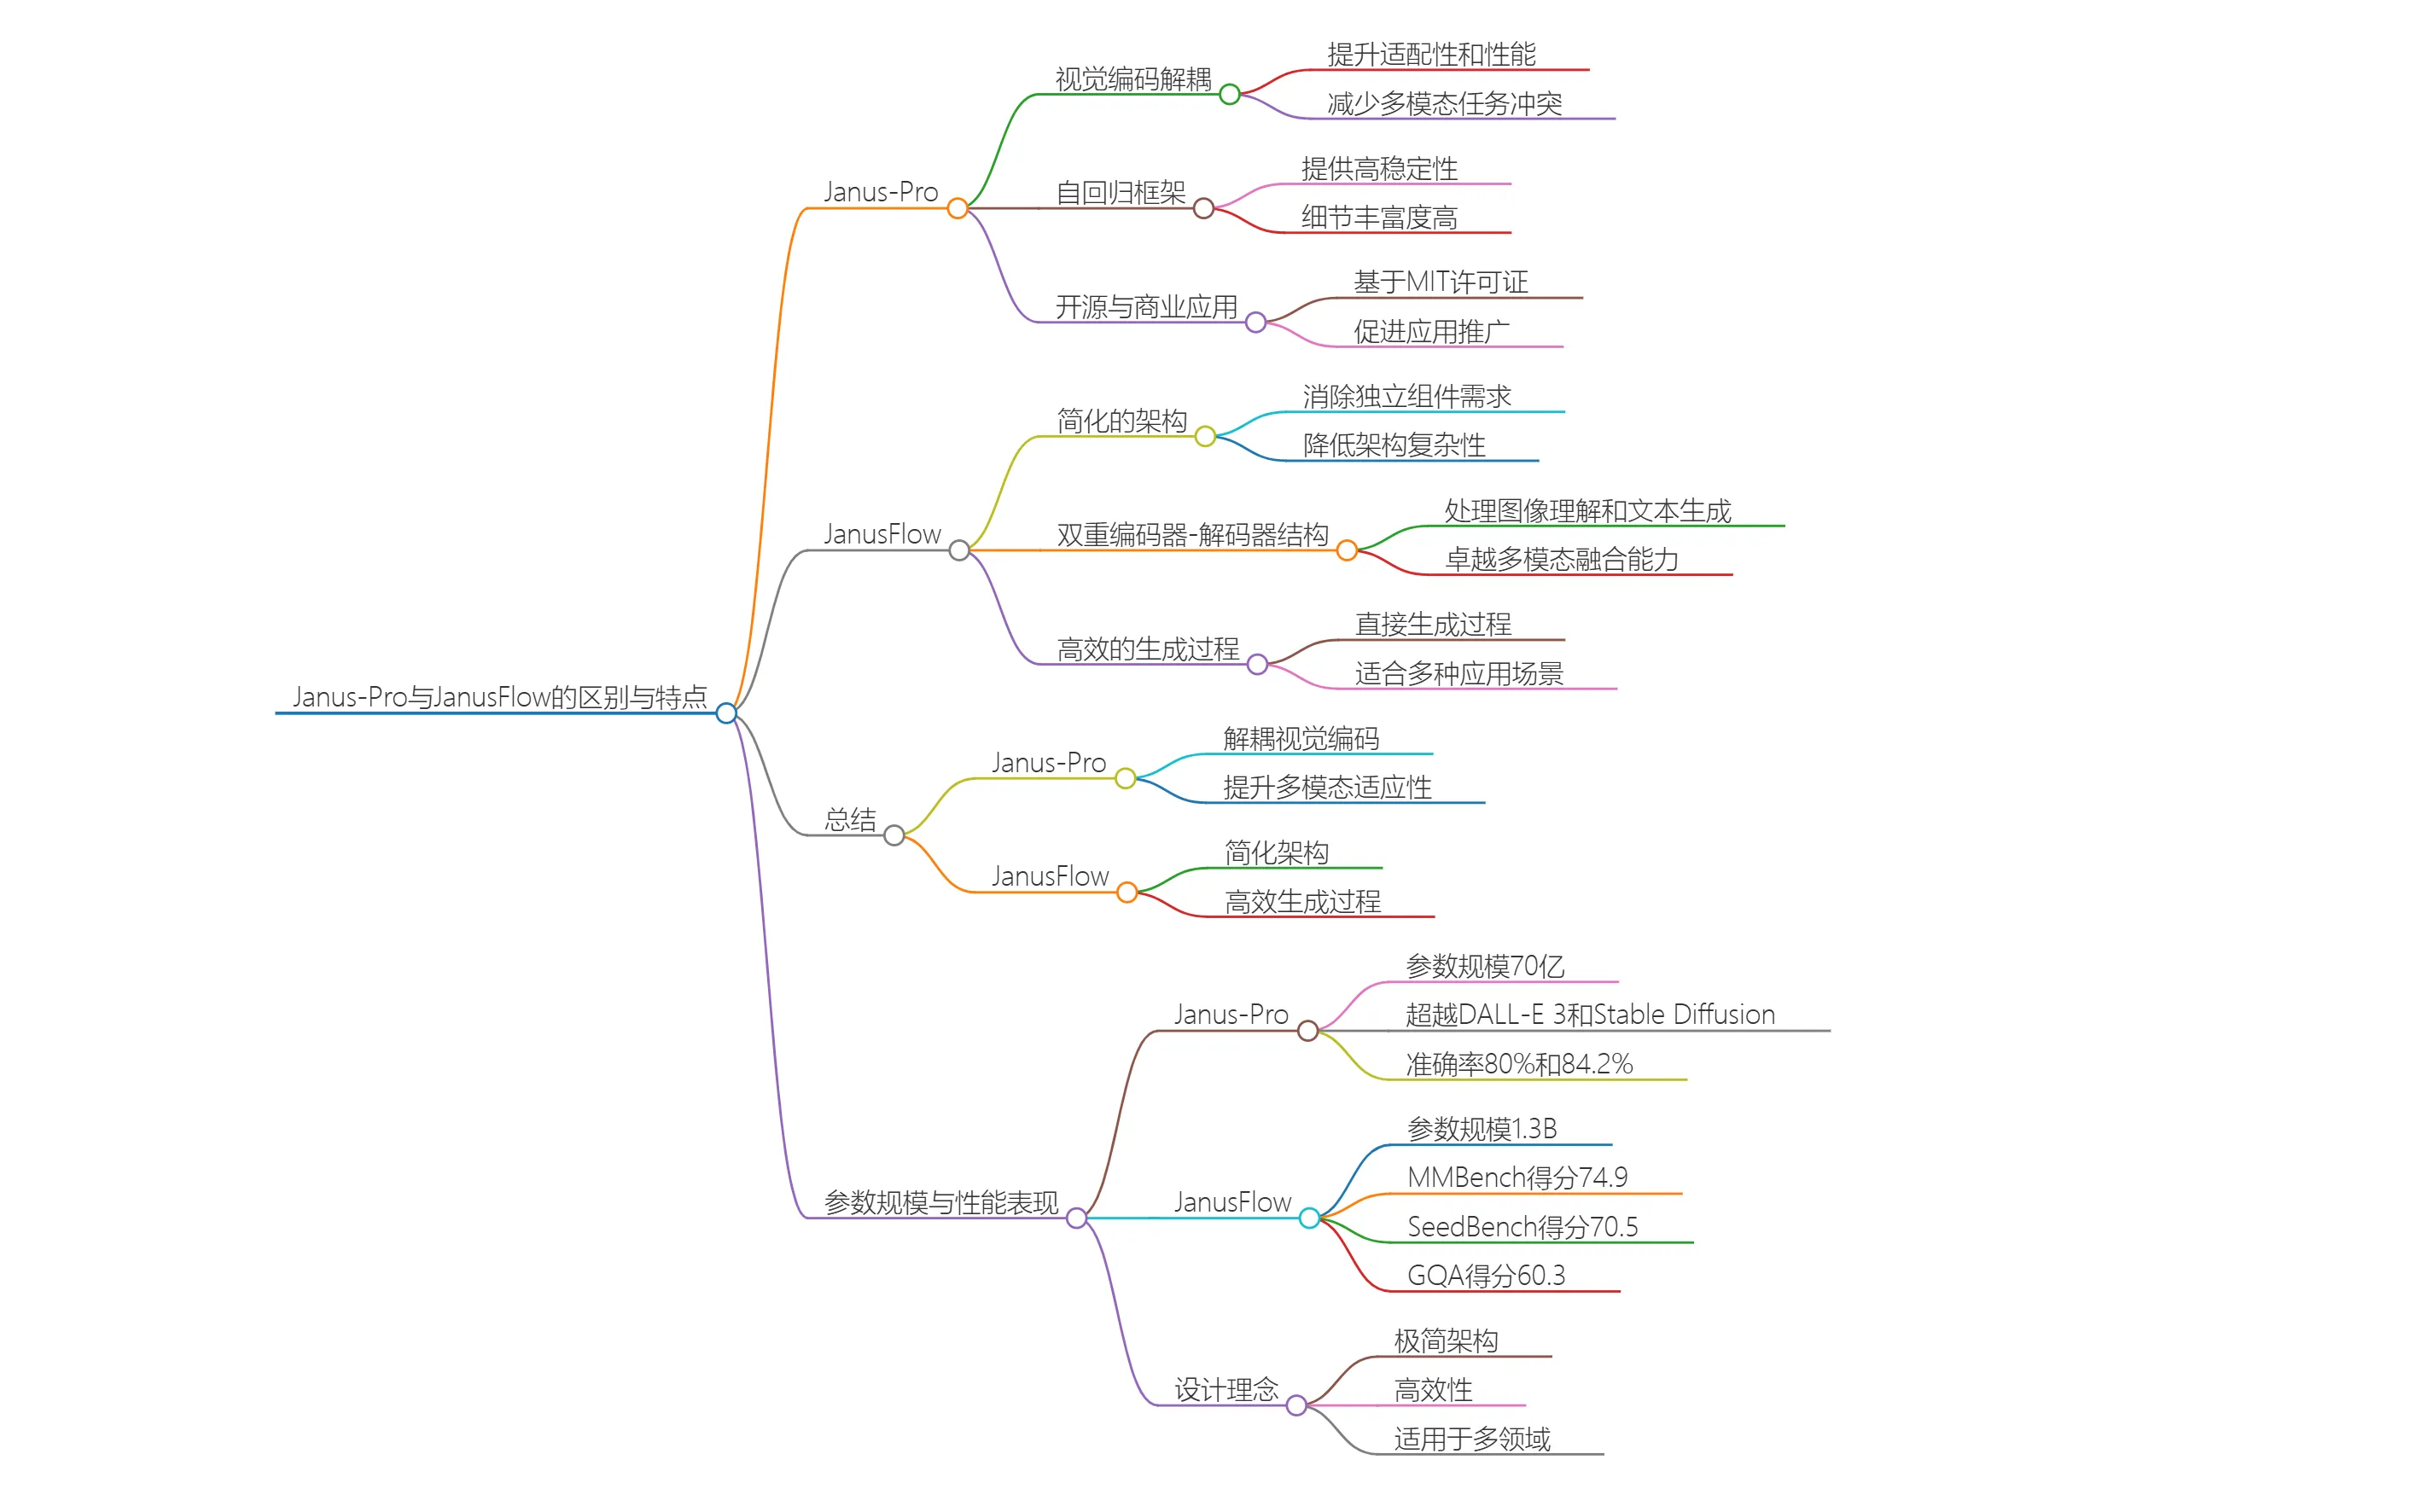
1. Architecture technique
Janus-Pro :
Adopte une technique d'encodage visuel découplé, qui sépare le processus d'encodage visuel en chemins indépendants pour traiter séparément les tâches de compréhension et de génération multimodales, résolvant ainsi le conflit fonctionnel de l'encodeur visuel dans les deux types de tâches des modèles traditionnels.
Repose sur une architecture Transformer unifiée, ce qui simplifie la conception du modèle et améliore sa capacité d'extension.
Utilise SigLIP-L comme encodeur visuel, prend en charge les entrées d'images en résolution 384x384, et utilise le LlamaGen Tokenizer pour la génération d'images.
JanusFlow :
Fusionne un flux génératif (Rectified Flow) avec un modèle de langage autorégressif, permettant ainsi un cadre multimodal minimaliste mais puissant, capable de générer des images de haute qualité sans modifications complexes.
Utilise également SigLIP-L comme encodeur visuel et s'appuie sur SDXL-VAE pour la génération d'images, offrant une meilleure finesse de génération.
2. Philosophie de conception
Janus-Pro :
Met l'accent sur la flexibilité et l'efficacité, en améliorant l'adaptabilité du modèle à différentes tâches grâce à un encodage visuel découplé, ce qui le rend adapté aux scénarios multimodaux tels que la réponse à des questions visuelles et l'annotation d'images.
Vise à devenir un cadre multimodal unifié, capable à la fois de comprendre efficacement le contenu des images et de générer des images de haute qualité.
JanusFlow :
Mise sur une architecture minimaliste et une grande extensibilité. Grâce à la fusion d'un flux génératif et d'un modèle de langage, il simplifie le processus de modélisation multimodale, ce qui le rend adapté aux applications à grande échelle.
Vise à fournir aux chercheurs et aux développeurs une solution multimodale efficace et flexible, prenant en charge l'extension multi-tâches.
3. Performances
Janus-Pro :
Dans les benchmarks GenEval et DPG-Bench, le modèle Janus-Pro-7B atteint respectivement une précision de 80 % et 84,2 %, surpassant le DALL-E 3 d'OpenAI et Stable Diffusion 47.
Excelle dans les tâches de compréhension multimodale, atteignant des performances comparables voire supérieures à celles des modèles spécialisés.
JanusFlow :
Performant dans les tâches de génération d'images, offrant une qualité de génération élevée et une compatibilité avec la résolution 384x384.
Dans les tâches de compréhension telles que la réponse à des questions visuelles et l'annotation d'images, ses performances sont comparables voire supérieures à celles des modèles spécialisés.
4. Scénarios d'application
Janus-Pro :
Convient aux scénarios nécessitant une génération d'images de haute qualité et une compréhension multimodale, tels que la conception publicitaire, le développement de jeux et la création artistique.
Idéal pour les utilisateurs ayant besoin d'une adaptation flexible à plusieurs tâches, comme les chercheurs et les développeurs en entreprise.
JanusFlow :
Plus adapté aux applications à grande échelle et à l'extension multi-tâches, comme les assistants intelligents et la réalité virtuelle, qui nécessitent une génération et une compréhension efficaces.
Grâce à son architecture minimaliste, il convient aux utilisateurs disposant de ressources limitées mais ayant besoin de modèles haute performance.
5. Open source et déploiement
Les deux modèles sont open source et distribués sous licence MIT. Les développeurs peuvent obtenir le code et les poids des modèles via GitHub.
Janus-Pro et JanusFlow ont chacun leurs propres orientations en termes d'architecture technique, de philosophie de conception et de scénarios d'application :
Janus-Pro, grâce à son encodage visuel découplé et à son architecture Transformer unifiée, permet une compréhension et une génération multimodales efficaces, et convient aux scénarios nécessitant une génération d'images de haute qualité et une adaptation flexible aux tâches.
JanusFlow, grâce à la fusion d'un flux génératif et d'un modèle de langage, offre un cadre multimodal minimaliste mais puissant, adapté aux applications à grande échelle et à l'extension multi-tâches.
La publication de ces deux modèles apporte de nouvelles avancées dans le domaine de l'IA multimodale. Les utilisateurs peuvent choisir le modèle le plus adapté à leurs besoins spécifiques pour le déploiement et l'application.









