
 Assistant scénario▸
 Apps AI
 Actualités AI
Seed-ASR : modèle de reconnaissance automatique de la parole par ByteDance

Seed-ASR : modèle de reconnaissance automatique de la parole par ByteDance
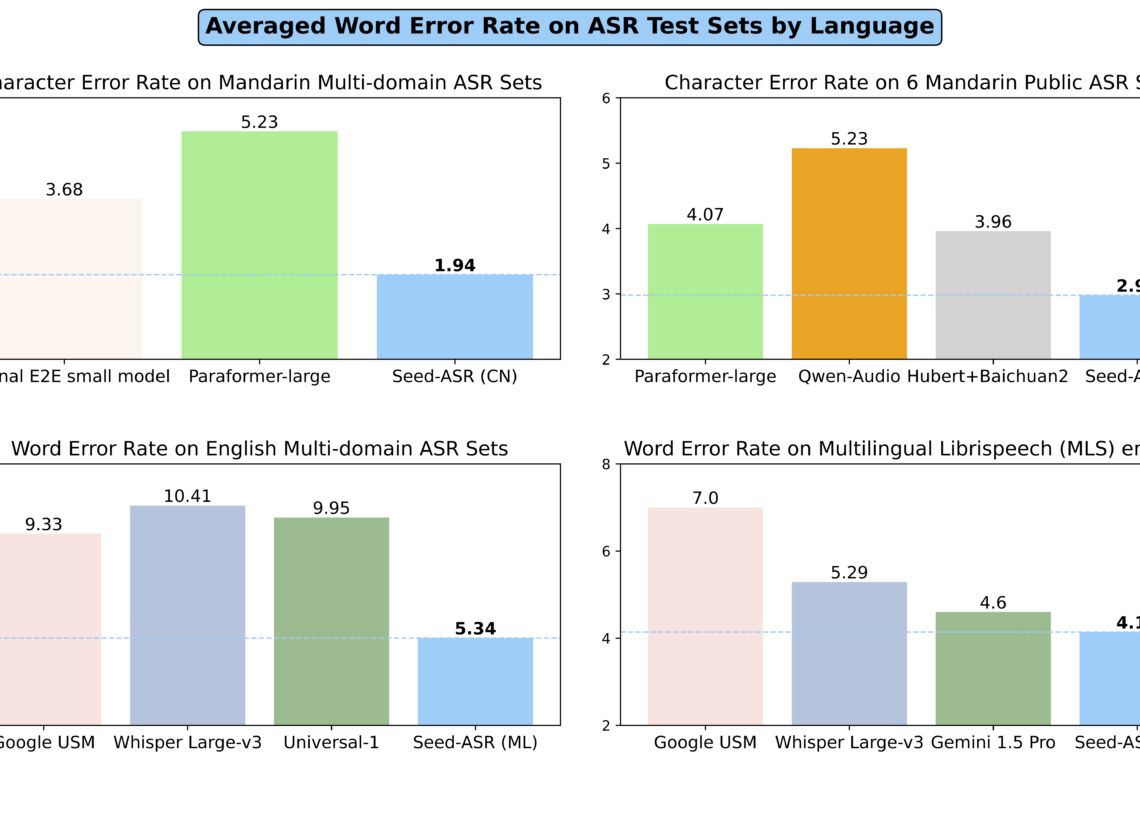
Seed-ASR, modèle de reconnaissance automatique de la parole de ByteDance, permet de convertir diverses voix en informations textuelles. Contrairement aux systèmes TTS traditionnels axés sur une seule tâche, Seed-TTS est capable de modéliser une grande variété de voix et permet un contrôle simultané selon de nombreuses dimensions. Il peut reconnaître différentes langues, dialectes, accents, et même des imperfections vocales telles que des mots avalés.Seed-ASR a été entraîné sur plus de 20 millions d'heures de données vocales et près de 900 000 heures de données ASR appariées.Il prend non seulement en charge le mandarin, mais reconnaît également 13 dialectes chinois, 7 langues étrangères ainsi que l'anglais sous divers accents.
Seed-ASR dispose d'une solide capacité de prise en compte du contexte, lui permettant de reconnaître le contenu vocal dans un contexte précis. Par exemple, le modèle peut s'appuyer sur des conversations historiques ou des comptes rendus de réunions pour identifier plus précisément les noms de personnes, les lieux ou d'autres mots-clés contextuels présents dans l'audio en cours.
Seed-ASR offre une excellente évolutivité. Autrement dit, il ne s'agit pas d'un système figé, mais d'une plateforme personnalisable selon des besoins spécifiques. Par exemple, si vous souhaitez qu'il reconnaisse spécifiquement la terminologie médicale ou qu'il comprenne un accent particulier, cela est possible grâce au fine-tuning.
La technologie centrale de Seed-ASR consiste à intégrer un grand modèle de langage dans la reconnaissance vocale, conférant ainsi à Seed-ASR une capacité de compréhension contextuelle. Il ne s'agit pas simplement d'assembler deux systèmes, mais bien de transformer fondamentalement la façon dont la voix est traitée. C'est comme si l'on dotait le système de reconnaissance vocale d'un super cerveau, non seulement capable d'écouter, mais aussi de réfléchir.
Points forts techniques de Seed-ASR :
Reconnaissance haute précision : traitement d'entrées vocales complexes grâce à un modèle comportant des dizaines de milliards de paramètres, pour une reconnaissance haute précision.
Modèle à grande capacité : grâce à l'utilisation d'un grand modèle de langage, la précision de la reconnaissance vocale et la compréhension du contexte sont améliorées ; c'est comme disposer d'un « superordinateur » pour vous aider à dicter vos notes — c'est plutôt impressionnant.
Prise en charge multilingue : inclut le mandarin, 13 dialectes chinois ainsi que plusieurs langues étrangères, et prévoit une extension à plus de 40 langues.
Prise en compte du contexte : capable d'intégrer les informations contextuelles pour améliorer la précision de la reconnaissance, comme lorsqu'on discute avec un ami : il comprend ce qui a été dit auparavant et interprète plus justement la phrase en cours.
Méthode d'entraînement par étapes : comprenant l'apprentissage auto-supervisé, le fine-tuning supervisé, le fine-tuning contextuel et l'apprentissage par renforcement, pour renforcer progressivement les capacités du modèle.
Scénarios d'application de Seed-ASR :
Interaction homme-machine : fournit un canal d'entrée vocale en convertissant la parole en texte en temps réel, afin d'interagir rapidement et facilement avec les appareils, le matériel ou les applications.
Modération de contenu : convertit les enregistrements en texte, puis applique des règles d'assurance qualité pour analyser le texte, détecter rapidement les contenus non conformes et intervenir.
Transcription de réunions et d'entretiens : reconnaît en temps réel ou en différé les audios de réunions et d'entretiens en texte, segmente automatiquement les parties contenant de la voix pour la reconnaissance, réduisant ainsi les coûts et améliorant l'efficacité.
Sous-titres audio et vidéo : prend en charge la reconnaissance automatique de la parole et des paroles en texte à partir de contenus audio et vidéo, générant en un clic les sous-titres correspondants.
Seed-ASR a déjà été déployé dans l'application Doubao, où les internautes l'utilisent dans divers scénarios tels que les conversations en anglais, les compagnons de chat virtuels ou la reproduction de la voix de proches. Destinée à un nombre plus large de clients professionnels, Seed-ASR s'appuie sur Volcengine et est également mise en œuvre dans des scénarios d'interaction vocale, de modération de contenu, de transcription de réunions et d'entretiens, ainsi que de sous-titrage audio et vidéo.
À ce jour, l'équipe du grand modèle Doubao a publié plusieurs résultats techniques dans le domaine de la parole, notamment Seed-TTS et Seed-ASR.
Site officiel de Seed-ASR :https://bytedancespeech.github.io/seedasr_tech_report/









