
 Assistant scénario▸
 Apps AI
 Actualités AI
Seed-TTS : un modèle de synthèse vocale de haute qualité signé ByteDance
小编 ·

Seed-TTS : un modèle de synthèse vocale de haute qualité signé ByteDance
Récemment, le domaine TTS a explosé. Juste après l'open source de chatTTS, Byte a publié seed-tts, avec d'excellents résultats.
Seed-TTS est un modèle de synthèse vocale (TTS) de haute qualité développé par ByteDance. Le modèle Seed-TTS est capable de générer une voix quasi indiscernable de la voix humaine.
En tant que modèle fondamental de génération vocale,Seed-TTS excelle dans l'apprentissage en contexte de la parole, et ses performances en termes de similarité et de naturel avec le locuteur correspondent à celles d'une vraie voix humaine, tant sur le plan des évaluations objectives que subjectives.
Seed-TTS, sans nécessiter d'entraînement, n'a besoin que d'un court extrait vocal pour cloner et générer une voix très naturelle et expressive, capable de prendre en charge des tâches telles que la lecture de romans et le doublage.
Seed-TTS offre également des capacités de contrôle avancées sur divers attributs de la voix, y compris, mais sans s'y limiter, les émotions, l'intonation, le style de parole, etc., et permet également d'éditer la voix générée en modifiant le texte.
Seed-TTS peut modifier le contenu d'un fichier audio tout en conservant intacts le timbre, la hauteur et les émotions.
Seed-TTS permet de régler la vitesse de la parole et de contrôler librement la vitesse de l'audio.
Seed-TTS offre une contrôlabilité exceptionnelle sur divers attributs vocaux (tels que les émotions) et est capable de générer une voix hautement expressive et diversifiée pour des locuteurs du monde réel.
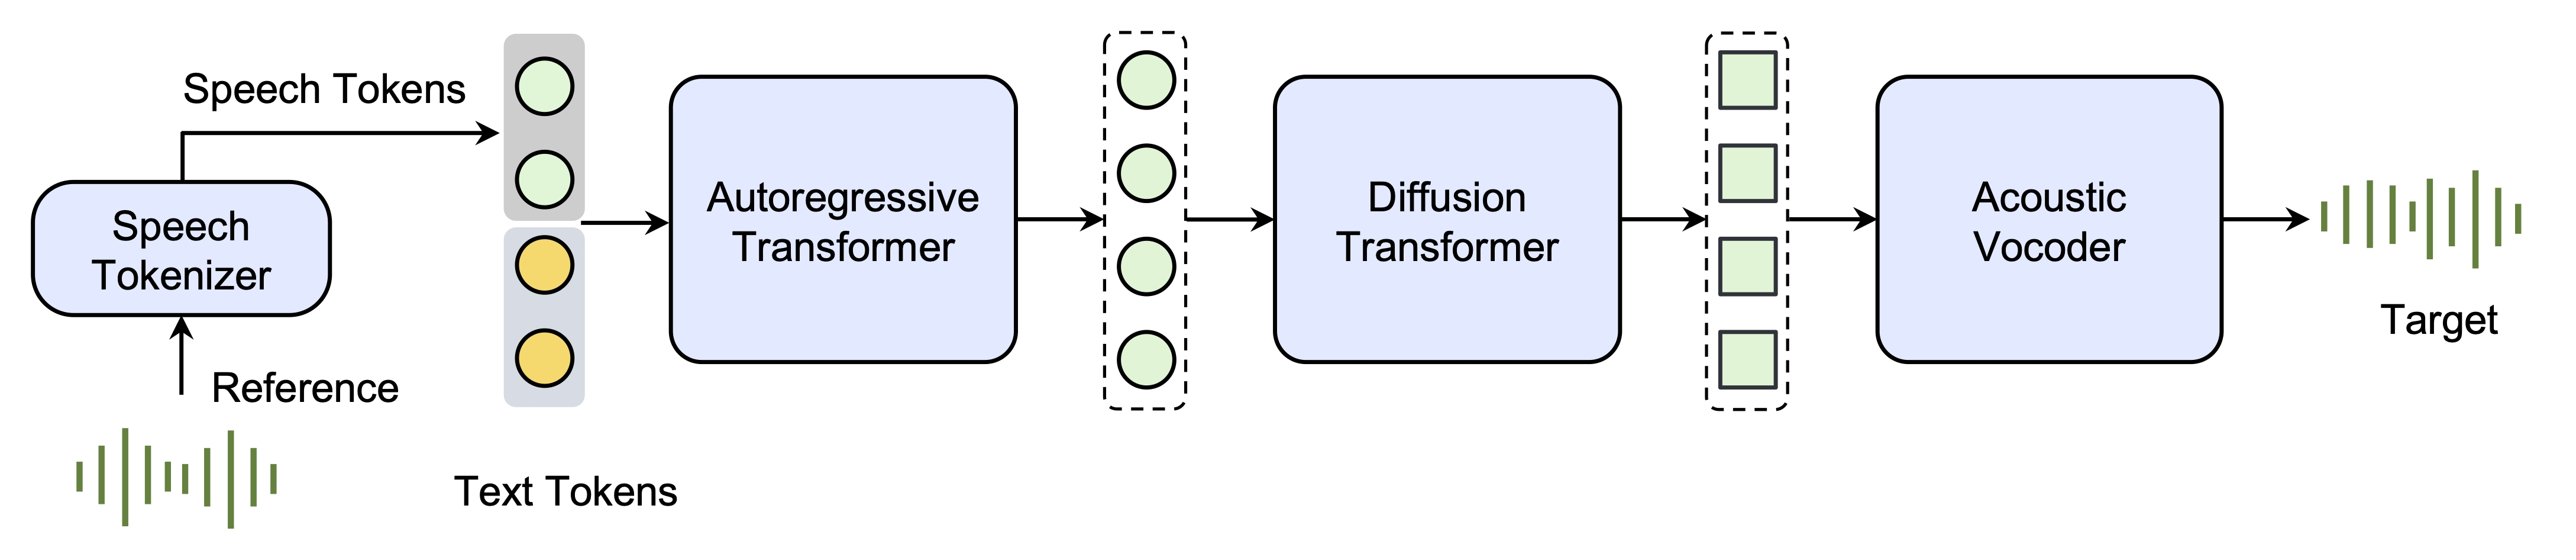
De plus, nous proposons une méthode d'auto-distillation pour la décomposition vocale, ainsi qu'une méthode d'apprentissage par renforcement pour améliorer la robustesse du modèle, la similarité avec le locuteur et la contrôlabilité. Nous présentons également une variante non autorégressive (NAR) du modèle Seed-TTS, nommée Seed-TTS DiT, qui adopte une architecture entièrement basée sur la diffusion. Contrairement aux systèmes TTS NAR précédents, Seed-TTS DiT ne dépend pas d'une estimation préalable de la durée des phonèmes et effectue la génération vocale de manière de bout en bout. Nous démontrons que cette variante atteint des performances comparables à la variante basée sur un modèle de langage, tant dans les évaluations objectives que subjectives, et nous montrons son efficacité dans l'édition vocale.
Article : https://arxiv.org/abs/2406.02430









