
 Asistente de guiones▸
 Apps AI
 Noticias AI
Wanliang Engine: gateway unificado para acceder a casi todas las API de modelos de IA
Wanliang Engine: gateway unificado para acceder a casi todas las API de modelos de IAIntroducción
Qué es Million Engine
Million Engine (万量引擎) es una puerta de enlace agregadora de múltiples modelos orientada a desarrolladores de aplicaciones de ai y Agentes, cuyo objetivo principal es ayudar a los desarrolladores nacionales a resolver los problemas de latencia de red, riesgo de suspensión de cuentas y limitaciones de alta concurrencia que surgen al invocar APIs de modelos de gran tamaño del extranjero.
Características
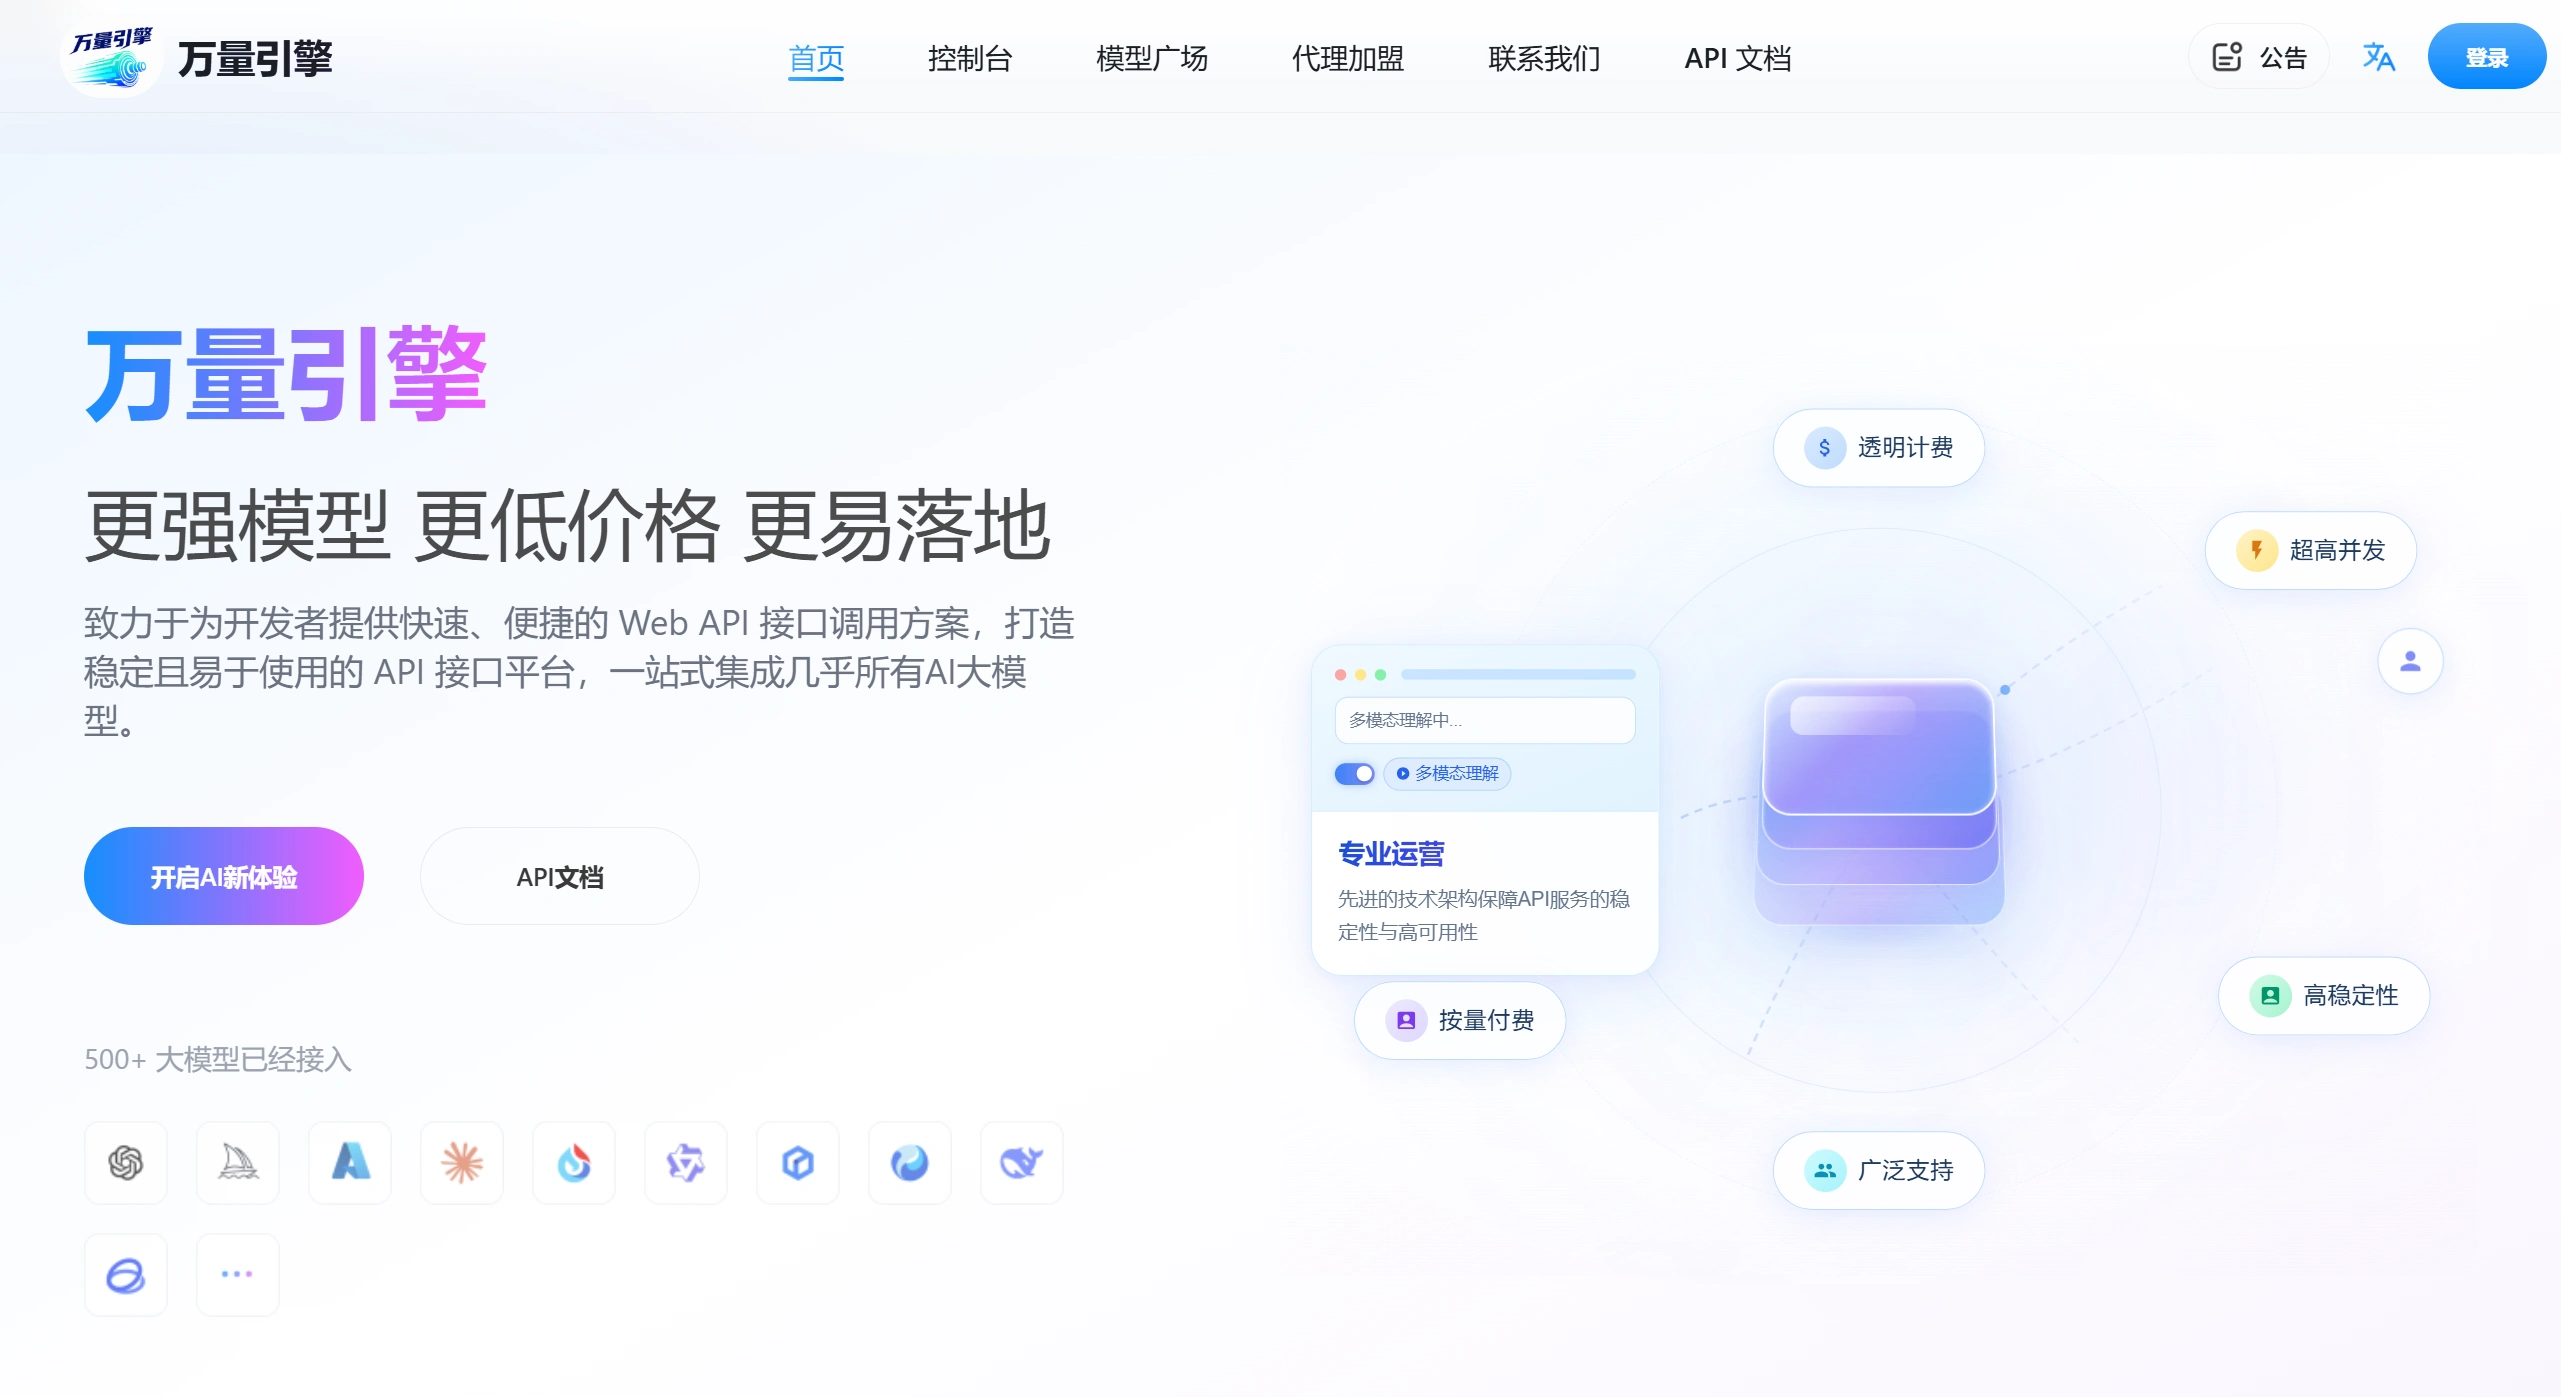
Acceso unificado a múltiples modelos: con una sola API Key puedes invocar más de 500 modelos populares como GPT-4o, Claude 3, Gemini, Gemma 4
Compatible con el SDK de OpenAI: solo cambia el base_url y tus proyectos actuales migran directamente, sin apenas modificar código
Línea dedicada transfronteriza de alta velocidad: utiliza canales de nivel empresarial, con nodos edge desplegados globalmente y una latencia media de unos 0,5 segundos
Estabilidad bajo alta concurrencia: soporta más de 100 QPS sin caídas, con balanceo de carga inteligente y reintentos automáticos, con una tasa de error cercana al 0%
Mecanismo anti-suspensión: mantiene internamente una gran cantidad de API Keys para evitar que una sola cuenta sea limitada o suspendida
Facturación flexible: pago por uso, sin problema de caducidad de paquetes, con precios similares a los oficiales pero más ventajosos
Soporte de funcionalidades completas: salida en streaming, solicitudes por lotes, llamadas a funciones, generación de imágenes con Midjourney, etc.
Escenarios de aplicación
Desarrollo de aplicaciones de IA: creación rápida de robots de chat, asistentes de redacción, herramientas de generación de código, etc.
Integración de IA a nivel empresarial: incorporar IA en sistemas internos, como atención al cliente, procesamiento de documentos, análisis de datos
Negocio de alta concurrencia: escenarios que requieren invocaciones masivas, como análisis de reseñas en e-commerce o generación de contenido por lotes
Aplicaciones de conversación en streaming: desarrollar productos de diálogo con IA en tiempo real para web o móvil
Orquestación colaborativa multimodelo: seleccionar automáticamente el modelo más adecuado según la tarea, por ejemplo, GPT-4o para razonamiento complejo y Claude para textos largos
Ventajas y desventajas de Million Engine
Ventajas:
Velocidad de acceso rápida desde China, con un 70% menos de latencia que un Nginx autoconstruido
Alta estabilidad, con una disponibilidad superior al 99,9%
Integración sencilla, se configura en 3 minutos
Menor coste que las soluciones autoconstruidas, sin necesidad de comprar servidores ni运维
Soporte técnico 7x24 horas
Desventajas:
Dependencia de un servicio de terceros, con cierto riesgo de bloqueo por proveedor
Empresas de escala muy grande pueden necesitar soluciones personalizadas
Algunos modelos especiales tienen nombres de mapeo exclusivos; es mejor consultar la documentación antes de integrarlos
Cómo usar Million Engine
Registro de cuenta: visita millionengine.com, regístrate y obtén tu API Key
Modificar configuración: cambia el base_url del SDK de OpenAI a https://millionengine.com/v1
Cambiar la Key: sustituye la Key original por la proporcionada por Million Engine
Invocar modelos: llama siguiendo el formato estándar de la interfaz de OpenAI
Monitorizar el uso: el panel de control permite ver en tiempo real el consumo de Tokens
Preguntas frecuentes
P: ¿En qué se diferencia de la API oficial?
R: El formato de la interfaz es exactamente el mismo, pero utiliza líneas optimizadas para China, con mejor velocidad y estabilidad.
P: ¿Soporta salida en streaming?
R: Sí, la experiencia es la misma que la oficial.
P: ¿Qué hago si se produce un timeout en la generación de textos largos?
R: Se recomienda configurar el tiempo de espera del SDK entre 60 y 120 segundos.
P: ¿Cómo se factura?
R: Se factura según el consumo real de Tokens, con precios iguales a los oficiales y sin cargos ocultos.
Valoración
Million Engine se posiciona como la base de nivel productivo para aplicaciones de IA, permitiendo a los desarrolladores despreocuparse de la infraestructura y centrarse en el negocio. Para los desarrolladores chinos de IA, resuelve el problema de red al acceder a modelos extranjeros y ofrece estabilidad de nivel empresarial lista para usar. Comparado con proxies autoconstruidos u otras soluciones de reenvío, presenta ventajas evidentes en latencia, estabilidad y control de costes. Es adecuado para diversos escenarios de IA, desde desarrolladores individuales hasta pequeñas y medianas empresas.















