
 Asistente de guiones▸
 Apps AI
 Noticias AI

IndexTTS: modelo TTS de Bilibili basado en XTTS y Tortoise
IndexTTS: modelo TTS de Bilibili basado en XTTS y TortoiseIntroducción
IndexTTS es un modelo de texto a voz desarrollado por Bilibili basado en XTTS y Tortoise, con capacidad TTS de grado industrial de cero disparos. Para escenarios en chino, adopta de forma innovadora un modelado híbrido de caracteres-pinyin, que permite corregir rápidamente errores de pronunciación. Combinando el codificador de condiciones Conformer y el decodificador BigVGAN2, mejora la estabilidad del entrenamiento, la fidelidad del timbre y la calidad del audio de salida.
Funciones principales:
✅ Soporte bilingüe chino-inglés
✅ Corrección de pinyin en chino: introduce pinyin para ajustar la pronunciación de caracteres polifónicos (por ejemplo, "长" puede especificarse como "zhǎng" o "cháng")
✅ Control de pausas mediante puntuación: controla el ritmo de las pausas en la voz a través de los signos de puntuación
✅ Mejora de la calidad de audio: el codificador Conformer extrae características de timbre y el decodificador BigVGAN2 mejora la calidad de generación de formas de onda
✅ Control independiente de emoción y timbre: ajusta por separado la expresión emocional y el timbre del hablante
✅ Control preciso de duración: admite dos modos: configuración mediante marcadores o generación autorregresiva
Aspectos técnicos destacados:
✅ Modelado híbrido en chino: la capa de entrada es compatible con entradas mixtas de texto puro/pinyin, predice automáticamente el pinyin no etiquetado y reduce la tasa de error de palabras
✅ Codificador Conformer: integra mecanismos de convolución y autoatención para reforzar el modelado de la prosodia del timbre
✅ Decodificador BigVGAN2: generador de formas de onda basado en arquitectura GAN, que equilibra la eficiencia computacional y la calidad del audio
Principales ventajas:
✓ Pronunciación precisa de caracteres polifónicos
✓ Ritmo de pausas natural
✓ Calidad de audio de alta fidelidad
✓ Clonación de voz rápida
✓ Soporte bilingüe chino-inglés
Aplicaciones típicas:
El voz sintetizada por IndexTTS es natural y plena en emociones, cercana a la voz humana real, y es ampliamente aplicable en escenarios como asistentes inteligentes | audiolibros | doblaje de vídeos | atención al cliente inteligente | herramientas educativas, entre otros.
Rendimiento
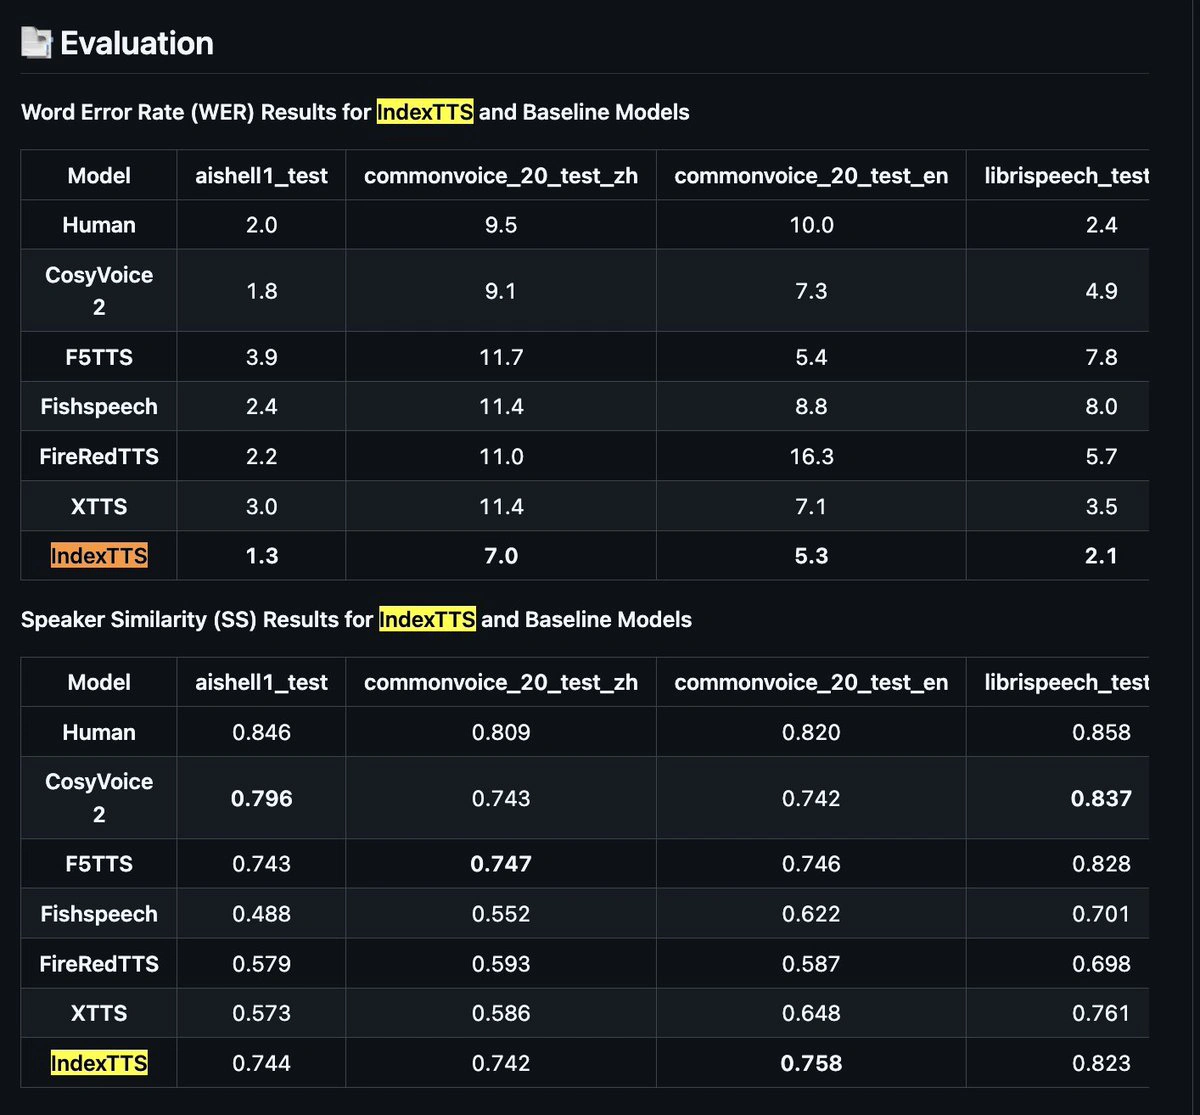
✓ Naturalidad y consistencia: en naturalidad, consistencia de contenido y clonación de voz de cero disparos, IndexTTS muestra mejoras significativas respecto a modelos existentes como XTTS.
✓ Eficiencia de entrenamiento e inferencia: el proceso de entrenamiento es relativamente sencillo, la velocidad de inferencia es mayor y el rendimiento supera al de sistemas TTS open source convencionales como Fish-Speech, CosyVoice2, FireRedTTS y F5-TTS.
✓ Tasa de utilización del codebook: en comparación con la cuantización vectorial (VQ) y la cuantización de Schur finita (FSQ), resuelve el problema del colapso del codebook, con una tasa de utilización cercana al 100 %.
Métodos de despliegue:
Clonar el repositorio de GitHub
Instalar dependencias como PyTorch
Preparar y preprocesar los datos de audio
Entrenar o cargar un modelo preentrenado
Ajustar parámetros para generar archivos de audio
Dirección del proyecto:https://github.com/index-tts/index-tts














