
 Asistente de guiones▸
 Apps AI
 Noticias AI
Step-Video-T2V: modelo avanzado de generación de texto a vídeo
Step-Video-T2V: modelo avanzado de generación de texto a vídeoIntroducción
Step-Video-T2V es un modelo avanzado de texto a vídeo de código abierto desarrollado en colaboración entre Stepfun y Geely Auto. Posee numerosas características destacadas y muestra un gran potencial en el campo de la generación de vídeo.
Aspectos destacados del modelo Step-Video-T2V
Emplea el modelo DiT y el método de entrenamiento de flujo continuo (flow matching), logrando una compresión espacial de 16×16 y una compresión temporal de 8×, lo que mejora enormemente la eficiencia de la generación de vídeo a gran escala.
Cuenta con una enorme cantidad de 30 000 millones de parámetros, capaz de generar vídeos de alta resolución y alta calidad de hasta 544x992.
Admite entradas de instrucciones tanto en chino como en inglés, lo que facilita su uso a usuarios con diferentes idiomas.
Características funcionales de Step-Video-T2V
Parámetros a gran escala: con hasta 30 000 millones de parámetros, el modelo alcanza una capacidad y precisión de generación extremadamente altas, lo que le permite comprender las descripciones de texto con mayor precisión y transformarlas en vídeos de alta calidad.
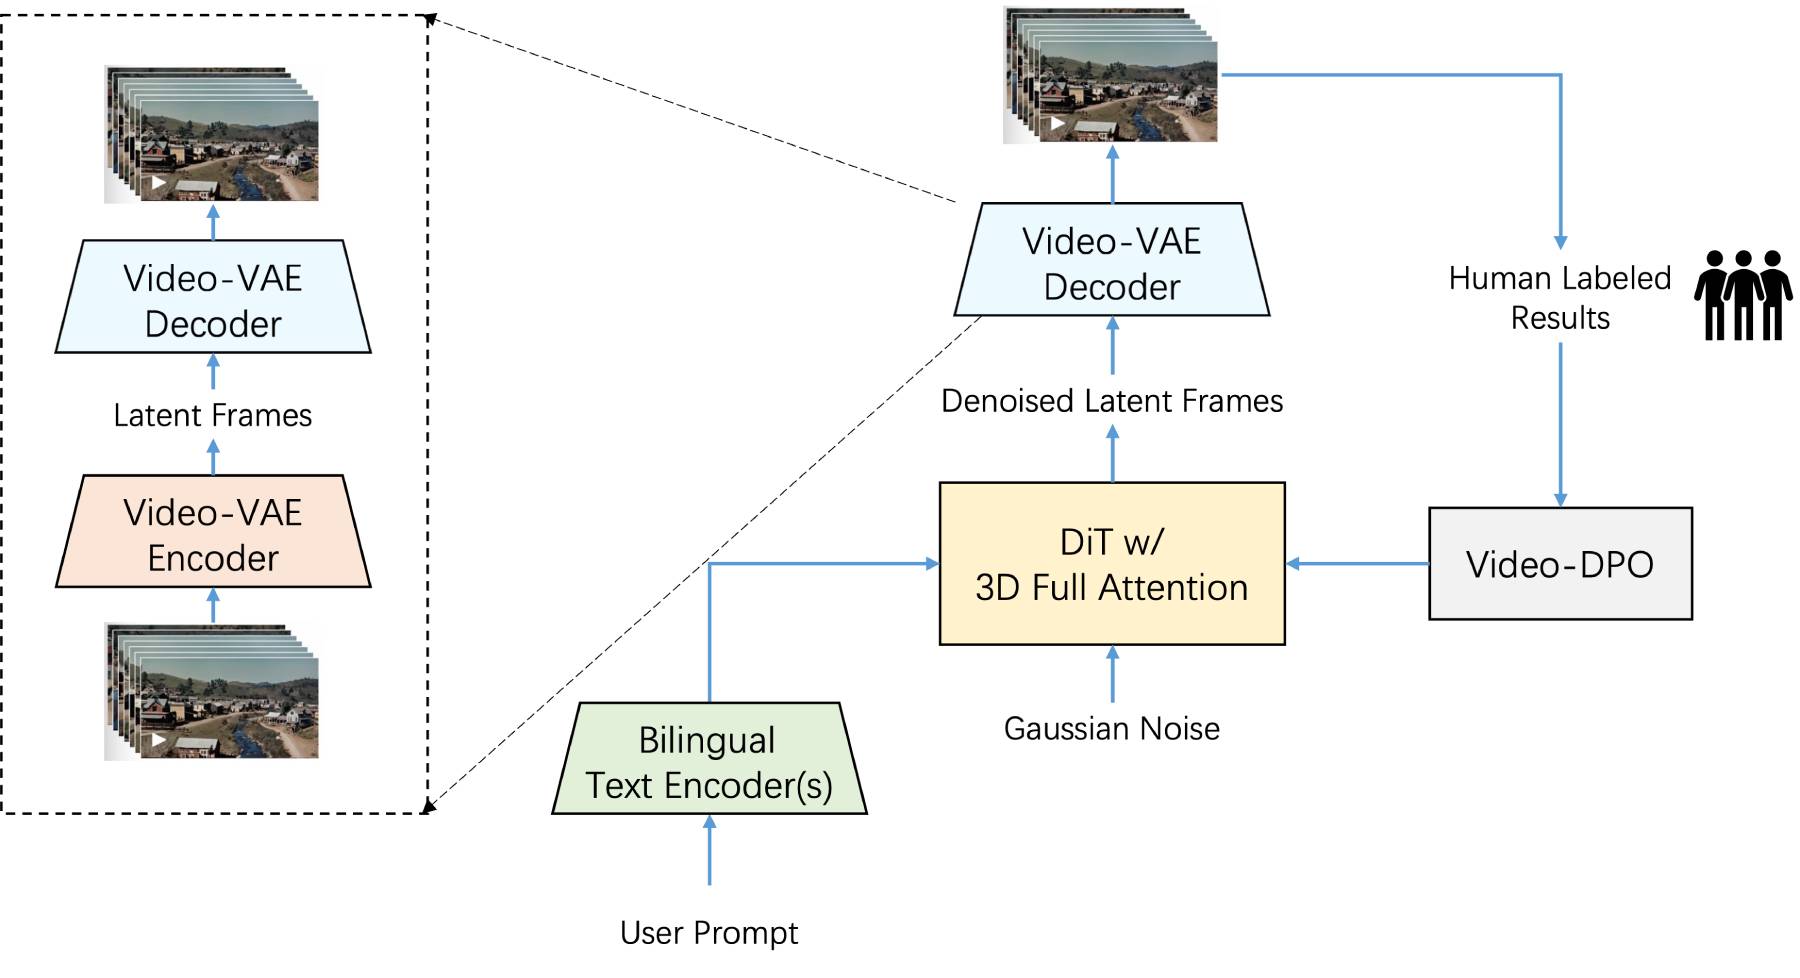
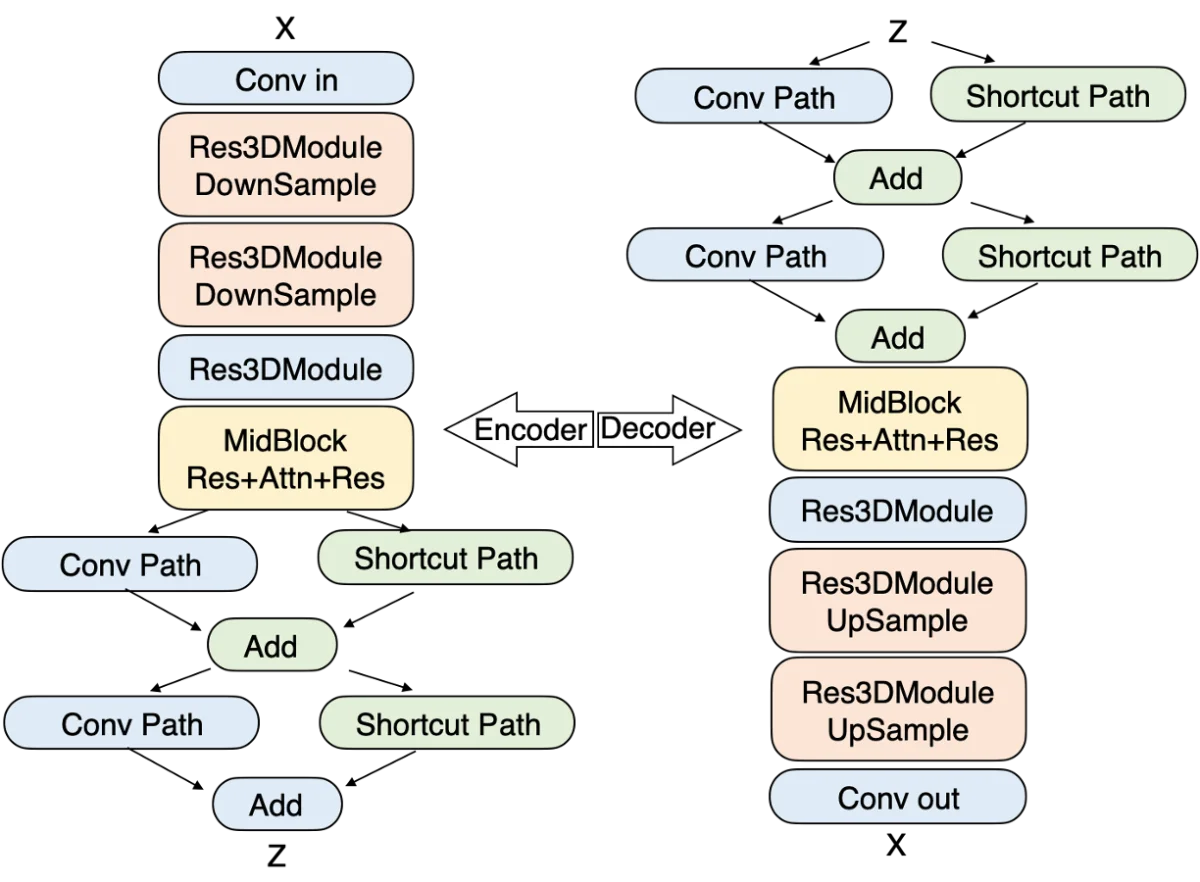
Generación de vídeo eficiente: admite la generación de vídeos de alta calidad de hasta 204 fotogramas (544x992 píxeles), satisfaciendo diversas necesidades creativas. Emplea un autocodificador variacional con compresión profunda (Video-VAE), logrando una compresión espacial de 16×16 y una compresión temporal de 8×, manteniendo la calidad del vídeo y reduciendo eficazmente los costes de entrenamiento e inferencia.
Codificador de texto bilingüe: admite entradas en chino e inglés, capaz de comprender en profundidad y generar contenidos de vídeo que se ajustan a las descripciones textuales, permitiendo que usuarios de distintos idiomas utilicen el modelo cómodamente.
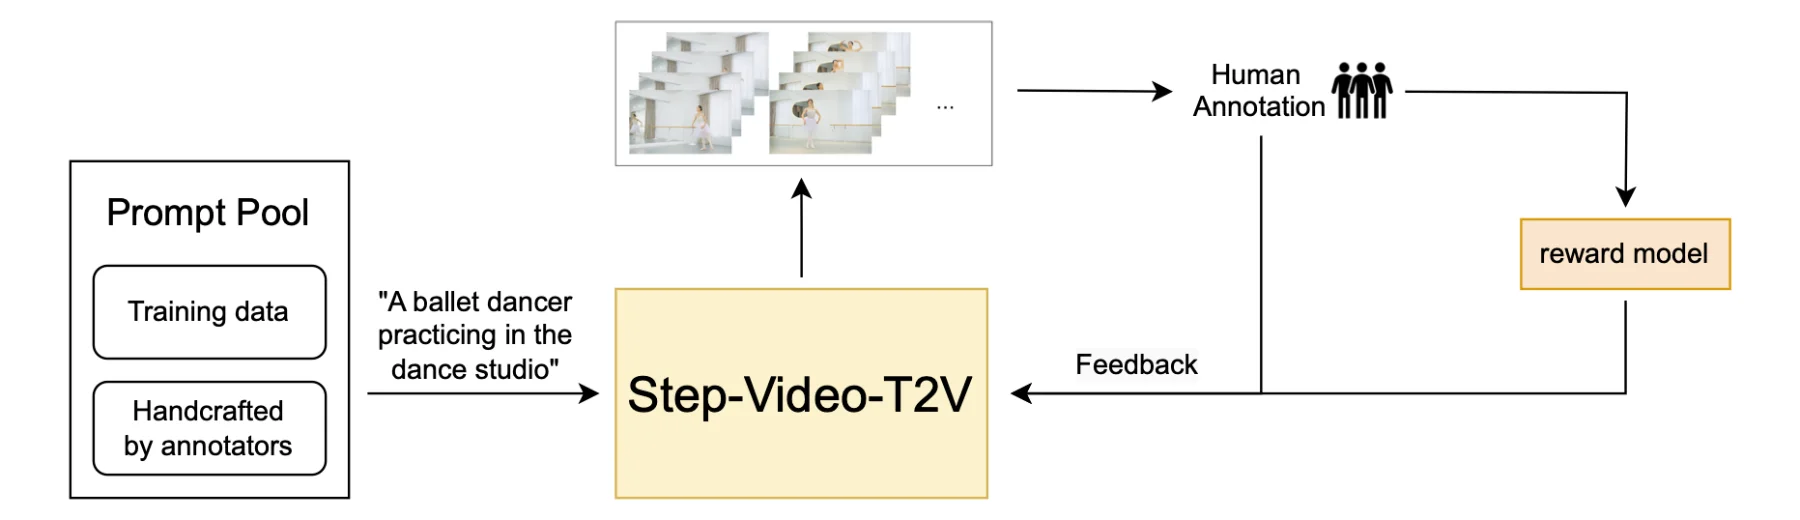
Arquitectura avanzada: utiliza una arquitectura DiT con atención 3D completa, capaz de adaptarse con flexibilidad a cambios de resolución dinámica, garantizando la estabilidad y alta calidad de la generación de vídeo. Incorpora la optimización de preferencias de vídeo (Direct Preference Optimization, DPO) que, mediante un mecanismo de retroalimentación humana, mejora aún más la calidad y suavidad de los vídeos generados, haciendo que se ajusten mejor a las expectativas del usuario.
Fusión multimodal: combina la capacidad de comprensión de tres modalidades (imagen, voz y texto), lo que da como resultado contenidos con detalles más realistas. Por ejemplo, las expresiones de los personajes generados son más vivas, los cambios de luz y sombra más naturales y la representación de objetos en movimiento más fluida y auténtica.
Modos de operación flexibles: ofrece una versión básica (generación en 50 pasos) y una versión Turbo (acelerada por destilación en 15 pasos), para satisfacer las necesidades de rendimiento de diferentes usuarios en distintos escenarios. En la práctica, generar un vídeo de 204 fotogramas requiere aproximadamente 4 GPU con 80 GB de VRAM y tarda unos 12 minutos.
Aplicaciones de Step-Video-T2V
Producción creativa de vídeo: ayuda a los creadores de vídeo a generar escenas complejas y contenidos creativos refinados, siendo especialmente adecuado para la producción de anuncios, creación de vídeos cortos y otros campos.
Producción de animación y cine: en las industrias de la animación y el cine, puede emplearse para generar personajes virtuales de alta calidad, escenas dinámicas y acciones complejas.
Educación y formación: permite crear vídeos didácticos altamente interactivos, haciendo que el proceso de enseñanza sea más vivo e interesante, y aumentando la participación y el aprendizaje de los estudiantes.
Industria del entretenimiento: puede generar automáticamente CG de videojuegos, tráilers de películas y otros contenidos de entretenimiento, ahorrando mucho tiempo y costes de mano de obra.
Difusión cultural: destaca especialmente en la estética de estilo chino, pudiendo generar contenidos como pinturas de tinta y escenas de estilo antiguo, lo que contribuye a la difusión digital de la cultura tradicional y permite que esta adquiera nueva vitalidad en la era moderna.
Cómo utilizar Step-Video-T2V:
1. Instalar dependencias:
Instale las bibliotecas y dependencias de Python necesarias. Normalmente puede hacerlo mediante pip u otro gestor de paquetes.
pip install transformers torch torchvision torchaudio
2. Configurar el entorno:
Configure el entorno hardware necesario para su ejecución; se recomienda disponer de al menos 4 GPU NVIDIA con 80 GB de VRAM.
Descargue y descomprima los archivos de pesos del modelo en el directorio especificado.
3. Cargar el modelo:
Cargue el modelo preentrenado Step-Video-T2V utilizando la biblioteca Hugging Face Transformers.
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "stepfun-ai/Step-Video-T2V"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
4. Generar vídeo:
Prepare las instrucciones de texto y conviértalas a un formato que el modelo pueda utilizar.
Ejecute el script de generación y espere a obtener los resultados.
input_text = "A red-haired woman performing on stage."
inputs = tokenizer(input_text, return_tensors="pt")
# Generate video frames (this is a simplified example; actual implementation may vary)
outputs = model.generate(**inputs, max_length=204)  # Adjust parameters as needed
# Save or display the generated video frames
5. Postprocesado:
Realice el postprocesado de los fotogramas de vídeo generados, como unirlos en un vídeo completo, añadir audio, etc.
Acceso a recursos:
Repositorio de GitHub: https://github.com/stepfun-ai/Step-Video-T2V
Demostración en Hugging Face: https://huggingface.co/stepfun-ai














