
 Asistente de guiones▸
 Apps AI
 Noticias AI
Moshi: Convertidor de voz en tiempo real de código abierto
Moshi: Convertidor de voz en tiempo real de código abiertoIntroducción
Moshi es un modelo Transformer de generación de voz en tiempo real y de múltiples flujos, que admite conversaciones de voz dúplex completo. Sus principales características son la entrada y salida simultánea de voz (dúplex completo), así como la capacidad de manejar escenarios de conversación complejos, incluyendo información no verbal como solapamiento de voces, interrupciones y expresiones emocionales.
Esto significa que puede escuchar y hablar al mismo tiempo, y está diseñado para abordar algunos problemas de los sistemas de diálogo tradicionales, como la latencia, la pérdida de información no verbal (por ejemplo, las emociones) y la estructura rígida de los turnos de conversación.
Comunicación dúplex completo: los sistemas de diálogo tradicionales son por turnos (una persona termina de hablar antes de que la otra empiece). Moshi supera esta limitación y admite la comunicación dúplex completo. Esto significa que Moshi puede generar respuestas de voz mientras el usuario habla, sin las restricciones de los turnos, y puede manejar dinámicas de conversación complejas, como solapamiento de voces, interrupciones y respuestas rápidas.
Procesamiento de múltiples flujos: Moshi logra escuchar y generar voz simultáneamente mediante el procesamiento de múltiples flujos de audio. Esta arquitectura de múltiples flujos le permite manejar de forma flexible las interacciones de voz entre el usuario y el sistema, sin interrumpir el flujo natural de la conversación.
En comparación con los sistemas de diálogo de voz tradicionales, Moshi tiene varias ventajas notables:
Respuesta en tiempo real: la velocidad de respuesta de Moshi es muy rápida, con una latencia de solo 160-200 milisegundos, cercana a la velocidad de reacción en una conversación natural, lo que permite ofrecer una experiencia de diálogo más fluida.
Procesamiento de voz a voz: los sistemas tradicionales suelen depender de un proceso de voz a texto y luego a voz, mientras que Moshi puede procesar directamente la entrada de voz y generar salida de voz, preservando la información no verbal como el tono y la emoción.
Diálogo dúplex completo: Moshi no depende de turnos de diálogo estrictos, sino que puede manejar la voz del usuario y del sistema al mismo tiempo, lo que significa que puede manejar solapamiento de voces e interrupciones, asemejándose más a la forma natural de la conversación humana.
Las principales características de Moshi:
Diálogo de voz en tiempo real: Moshi genera directamente salida de audio a partir de la entrada de audio, en lugar de depender del proceso tradicional de voz a texto y luego a voz. Al procesar directamente los datos de voz, Moshi preserva la información no verbal como el tono, la emoción, el solapamiento de voces y las interrupciones, garantizando una conversación más natural y fluida.
Comunicación dúplex completo: Moshi es capaz de escuchar y hablar al mismo tiempo, lo que significa que puede generar respuestas de voz mientras el usuario habla, sin necesidad de turnos de diálogo estrictos. Puede manejar escenarios de conversación complejos, como solapamiento de voces y retroalimentación ininterrumpida que puede insertarse en cualquier momento (por ejemplo, "mm-hmm" o "entiendo").
Baja latencia: Moshi está diseñado con una latencia muy baja, teóricamente de solo 160 milisegundos, y en la práctica alrededor de 200 milisegundos. Esto significa que Moshi puede responder a la entrada del usuario casi en tiempo real, ofreciendo una experiencia de diálogo más fluida.
Método del monólogo interior: Moshi predice tokens de texto antes de generar la voz, lo que mejora significativamente la calidad y la coherencia lingüística de la voz producida. Esto no solo hace que la voz generada sea más clara, sino que también mejora la capacidad del sistema para el reconocimiento de voz y la conversión de texto a voz en entornos de streaming. Moshi implementa las funciones de reconocimiento de voz (ASR) y conversión de texto a voz (TTS) mediante la introducción de un mecanismo de "monólogo interior", que permite procesar simultáneamente el lenguaje y el audio en un flujo continuo de conversación.
Procesamiento paralelo de múltiples flujos de audio: Moshi es capaz de manejar simultáneamente los flujos de voz del usuario y del sistema. Esta capacidad de procesamiento de múltiples flujos permite a Moshi no solo generar su propia voz, sino también comprender y responder a la voz del usuario en tiempo real.
Manejo de la emoción y la dinámica del habla: al procesar directamente la voz en lugar de texto intermedio, Moshi es capaz de comprender y generar voz cargada de emoción, y de manejar dinámicas de conversación complejas, como la expresión emocional, las variaciones de voz, etc.
Soporte de dinámicas de conversación complejas: Moshi es capaz de manejar las dinámicas complejas de la conversación natural, como interrupciones, entrelazamientos, interjecciones y respuestas. Los sistemas tradicionales dependen de turnos de conversación claros (una persona habla antes de que el otro tome su turno), pero Moshi elimina esta limitación, haciendo que la conversación sea más natural.
Arquitectura del modelo Moshi
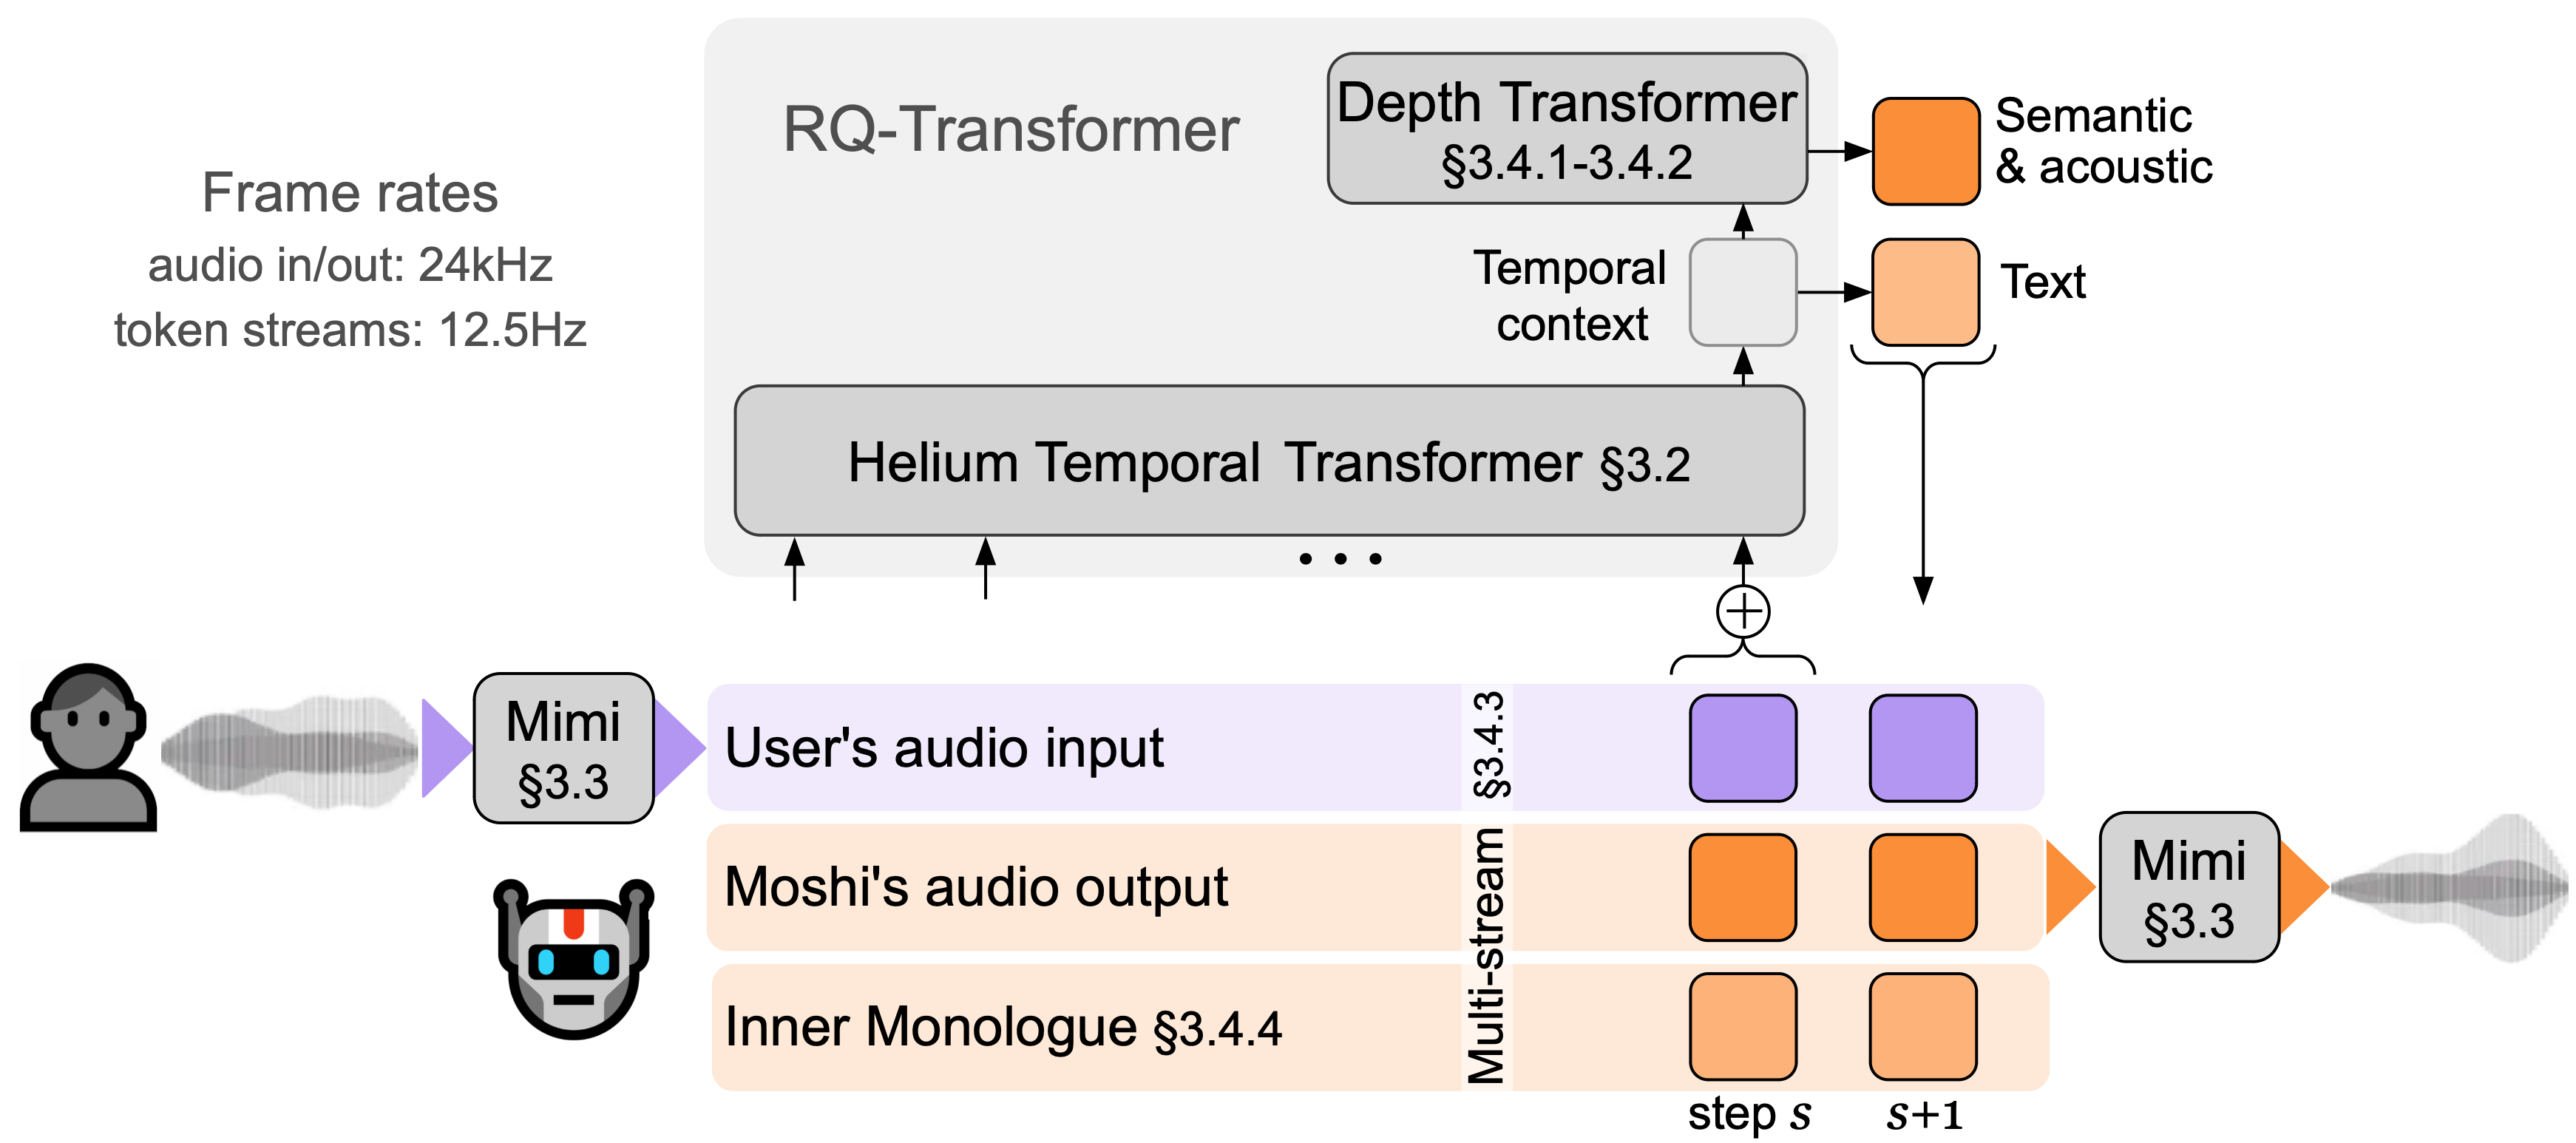
Moshi está compuesto por tres partes principales: Helium, un modelo de lenguaje de 7B entrenado con 2,1 billones de tokens; Mimi, un códec de audio neuronal que modela la información semántica y acústica; y una nueva arquitectura de múltiples flujos que puede modelar por separado el audio del usuario y el de Moshi.
Al trabajar en conjunto, estos módulos permiten un diálogo dúplex completo y fluido, la expresión emocional y el manejo de dinámicas de conversación complejas.
Modelo de lenguaje de texto Helium
Helium es el núcleo de Moshi. Es un modelo de lenguaje de texto basado en la arquitectura Transformer (similar a GPT) con 7 mil millones de parámetros. Helium proporciona a Moshi una sólida capacidad de comprensión y generación de lenguaje, capaz de manejar tareas complejas de razonamiento textual y diálogo.
Sus datos de entrenamiento incluyen 2,1 billones de palabras en inglés, lo que le otorga un amplio conocimiento y capacidad lingüística.
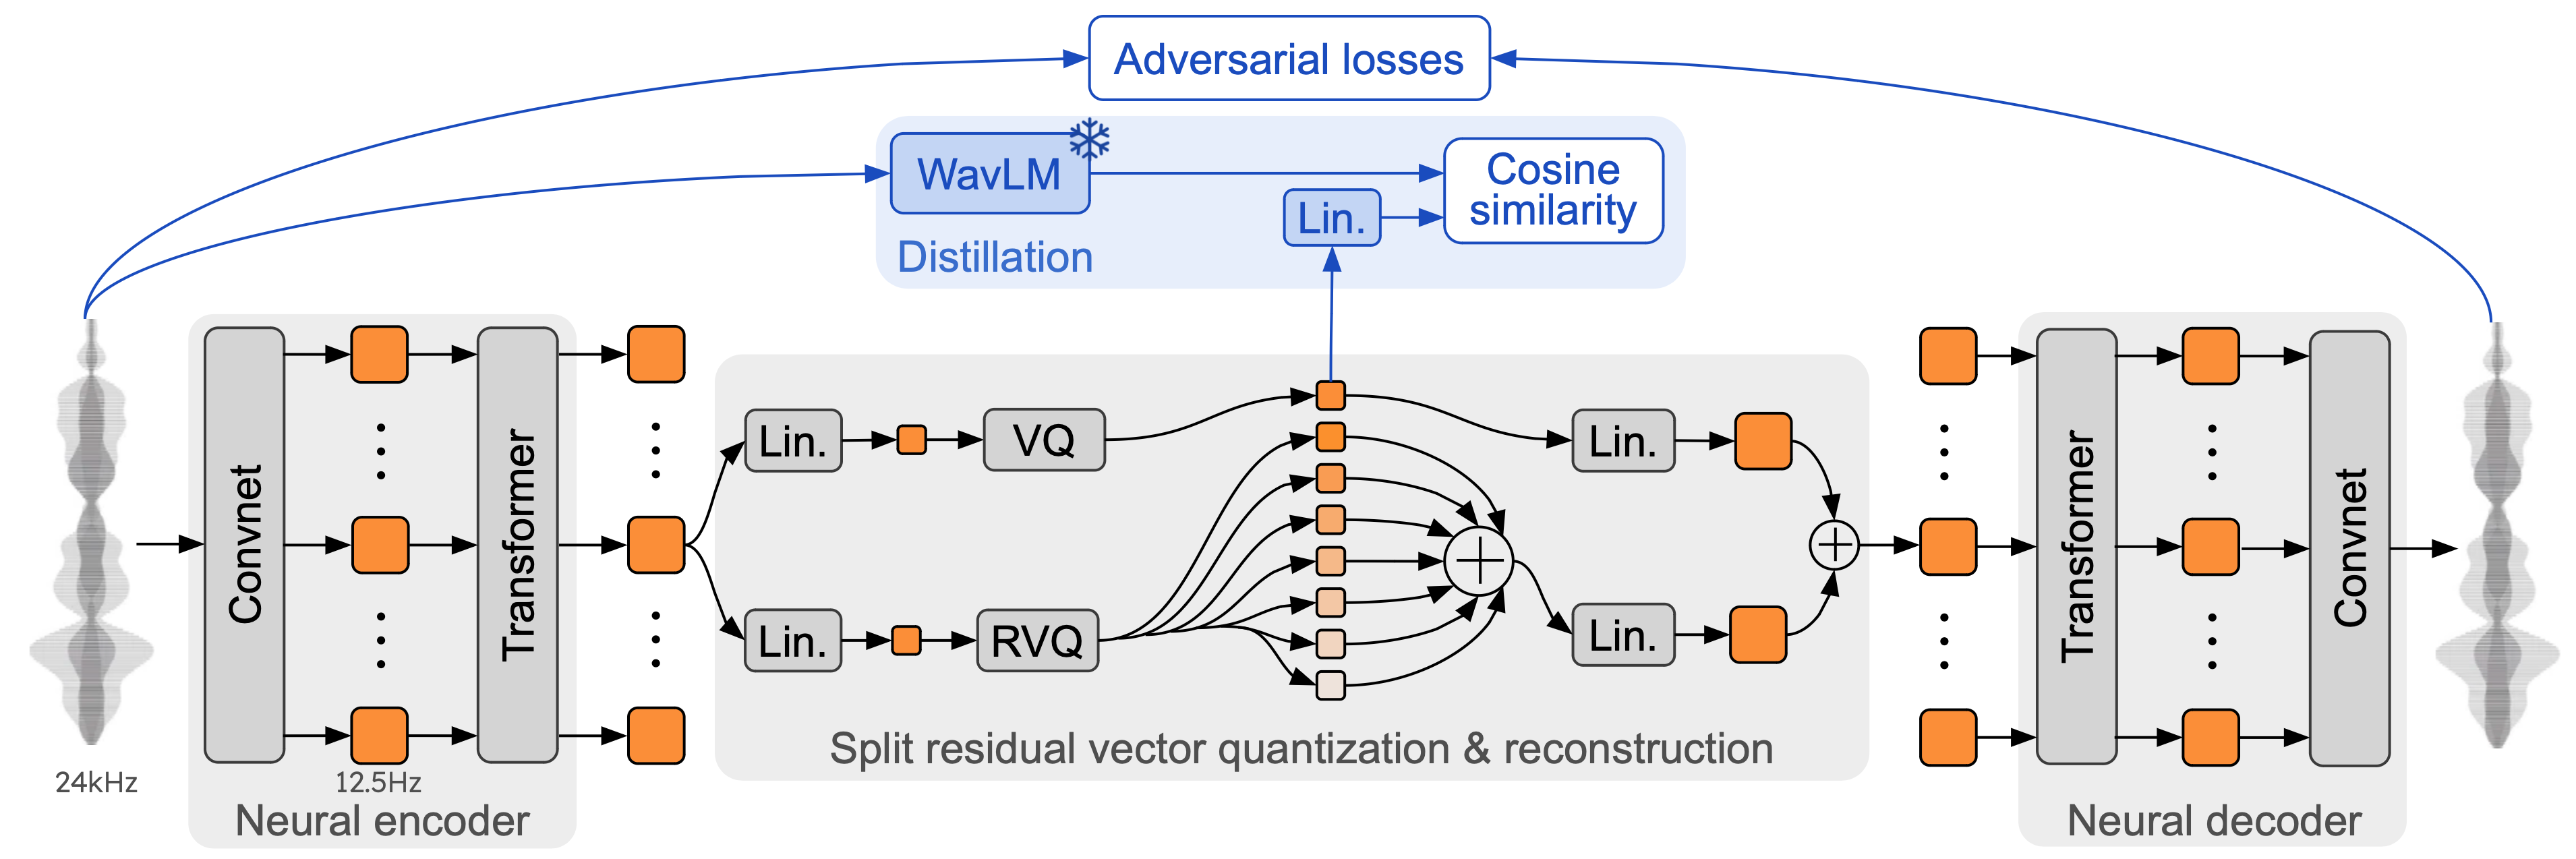
Códec de audio neuronal Mimi:Mimi es el componente de procesamiento de audio de Moshi. Es un códec de audio neuronal encargado de convertir el audio en tokens de voz discretos y capaz de generar de forma inversa salida de voz de alta calidad.
Mimi utiliza la técnica de cuantización vectorial residual (RVQ) para codificar los datos de voz en tokens discretos de voz y semánticos, garantizando una alta fidelidad de voz y la coherencia lingüística.
Al combinar tokens semánticos y acústicos, Mimi no solo puede generar voz natural, sino también manejar contextos de voz complejos e información emocional.
Método del monólogo interior:El método del monólogo interior es la tecnología clave de la generación de voz de Moshi, que permite al modelo predecir tokens de texto sincronizados con el audio antes de generar la voz. Este método no solo mejora la calidad lingüística de la voz generada, sino que también permite a Moshi implementar funciones de reconocimiento de voz y conversión de texto a voz en entornos de streaming.
Generación sincronizada de texto y voz: antes de generar el audio, Moshi genera un flujo de texto correspondiente a su salida de voz. Este flujo de texto sirve como base para la generación de voz, lo que hace que la generación sea más precisa y ayuda a manejar escenarios de conversación complejos.
Compatibilidad con streaming: este método permite a Moshi manejar la voz mientras sigue implementando un reconocimiento de voz eficiente y una conversión de texto a voz (TTS) en entornos de streaming.
La arquitectura del modelo está diseñada para manejar múltiples flujos de audio paralelos y generar voz y texto en tiempo real. Moshi puede generar la voz del sistema mientras procesa la voz del usuario, lo que le permite sostener conversaciones naturales e ininterrumpidas.
Métodos técnicos detallados de Moshi
1. Arquitectura de generación de voz a voz
La innovación principal de Moshi radica en tratar el diálogo de voz como una tarea de generación de voz a voz, en lugar del proceso tradicional de múltiples componentes de voz a texto y luego a voz. Los sistemas de diálogo de voz tradicionales incluyen múltiples módulos independientes como detección de actividad de voz (VAD), reconocimiento de voz (ASR), comprensión del lenguaje natural (NLU), generación de lenguaje natural (NLG) y conversión de texto a voz (TTS).
Moshi genera tokens de voz directamente, lo que permite que la voz no dependa de representaciones intermedias de texto durante el proceso de comprensión y generación, evitando así la pérdida de información (como emociones, tono y sonidos no verbales).
2. Modelo de lenguaje de texto Helium
Moshi se basa en el modelo de lenguaje de texto Helium, un gran modelo de generación de texto con 7B de parámetros. Helium se ha pre-entrenado con 2,1 billones de datos en inglés y posee una sólida capacidad de comprensión, razonamiento y generación de lenguaje. Es la base de la comprensión semántica de Moshi y admite funciones complejas de procesamiento de lenguaje natural, incluyendo diálogo abierto y preguntas y respuestas.
Características principales de Helium:
Arquitectura Transformer autorregresiva: Moshi se basa en Helium, un modelo de lenguaje de texto basado en la arquitectura Transformer. Similar al Transformer clásico, Helium utiliza mecanismos de atención multicapa y métodos de modelado autorregresivo para procesar la entrada de texto y generar la salida. El modelo tiene 7B parámetros, suficiente para soportar el aprendizaje a partir de corpus a gran escala.
Normalización RMS: se utiliza la normalización RMS en los módulos de atención, los módulos de capa intermedia y la capa de salida, lo que mejora la estabilidad del entrenamiento del modelo.
Codificación posicional rotativa (RoPE): se utiliza para manejar ventanas de contexto más largas (4096 tokens), asegurando que el modelo pueda capturar dependencias de largo alcance en la conversación.
FlashAttention eficiente: mediante un cálculo de atención optimizado, la inferencia del modelo con entradas de secuencias largas es más eficiente.
3. Códec de audio neuronal Mimi
Mimi es el códec de audio neuronal para el manejo de la voz en Moshi. Su misión es discretizar señales de voz continuas en tokens de audio. Estos tokens de audio discretos son similares a los tokens de texto y pueden representar información detallada en la voz. Mimi emplea la técnica de cuantización vectorial residual (RVQ) para preservar audio de alta calidad con una tasa de bits baja, admitiendo la generación y el procesamiento de voz en tiempo real.
Tecnologías clave de Mimi:
Cuantización vectorial residual (RVQ): Mimi utiliza cuantización vectorial residual multinivel para discretizar señales de audio complejas en múltiples niveles de tokens de audio. Este método permite codificar eficientemente la información semántica y acústica de la voz en cada paso del tiempo, garantizando al mismo tiempo la calidad de la reconstrucción del audio.
Combinación de tokens semánticos y acústicos: los tokens de audio utilizados por Mimi incluyen información semántica y acústica. Los tokens semánticos preservan el contenido del habla (por ejemplo, las palabras específicas pronunciadas), mientras que los tokens acústicos describen las características de audio de la voz, como el timbre, la emoción y el tono.
Codificación y decodificación en streaming: Mimi admite streaming, lo que permite la generación y el reconocimiento continuo de voz en conversaciones en tiempo real. Esto hace que la velocidad de respuesta de Moshi sea muy cercana a la de una conversación natural.
pan style="text-indent:2em;">4. Arquitectura de RQ-TransformerMoshi adopta una arquitectura de generación jerárquica multitransmisión, que puede procesar múltiples flujos de audio en paralelo. Moshi modela simultáneamente el flujo de voz del usuario y el flujo de voz del propio sistema, logrando una interacción flexible en la conversación y permitiendo dinámicas de diálogo sofisticadas, como la intercalación, las interrupciones y las interjecciones entre los hablantes.
Esta es una arquitectura propuesta previamente para la generación discreta de imágenes, y puede modelar la jerarquía de tokens semánticos y acústicos sin aumentar la longitud de la secuencia de Helium. Esto significa que cada segundo de audio solo necesita pasar 12,5 veces por el modelo backbone de 7B para poder ejecutarse en tiempo real en un MacBook Pro con L4 o M3. Combinado con la latencia de tokens de MusicGen, esto ofrece un rendimiento de vanguardia en el modelado de lenguaje de audio.
Modelado autorregresivo jerárquico: Moshi utiliza RQ-Transformer (Residual Quantizer Transformer) para descomponer los tokens de audio en múltiples niveles y generar audio mediante modelado autorregresivo jerárquico. En concreto, el modelo primero utiliza un Temporal Transformer más grande para procesar la secuencia temporal y, a continuación, un Depth Transformer más pequeño para procesar múltiples subsecuencias en cada paso temporal. Este diseño mejora considerablemente la eficiencia de generar largas secuencias de audio.
Generación de secuencias multimodales: el modelo genera múltiples secuencias simultáneamente (incluyendo texto, tokens semánticos y tokens de audio) y garantiza su alineación temporal precisa mediante un mecanismo de monólogo interno. El contenido generado en cada paso temporal no solo incluye la voz actual, sino también el prefijo de texto correspondiente, lo que hace que el contenido de voz generado sea más lógicamente coherente a nivel semántico.
Architecture of RQ-Transformer
5. Mecanismo de "monólogo interno"
El mecanismo de "monólogo interno" de Moshi es una de sus innovaciones clave en la generación de voz. Mediante este mecanismo, Moshi predice los tokens de texto alineados temporalmente correspondientes antes de generar el audio. Esto no solo mejora la coherencia lingüística de la voz generada, sino que también permite el reconocimiento de voz en tiempo real (ASR) y la conversión de texto a voz (TTS).
Características del mecanismo de "monólogo interno":
Generación alineada de texto y audio: Moshi predice primero el texto y luego genera el audio, lo que hace que la voz generada sea más precisa y fluida en gramática y contenido.
Mecanismo de retardo: al introducir un retardo entre el texto y el audio, Moshi puede realizar las tareas de ASR y TTS por separado. Por ejemplo, si primero se genera el texto y luego el audio, el modelo está en modo TTS; de lo contrario, está en modo ASR. Moshi puede cambiar sin problemas entre estos dos modos, garantizando que el modelo pueda tanto generar como reconocer voz.
Moshi: Delay mechanism
Moshi: TTS mode
6. Modelado multitransmisión
La arquitectura de Moshi permite procesar múltiples flujos de audio simultáneamente, supervisando tanto la voz del usuario como generando la voz del propio sistema. Durante la conversación, Moshi puede manejar dinámicamente las partes de audio superpuestas (por ejemplo, interrupciones, intercalaciones) sin necesidad de delimitar previamente los turnos de los hablantes. Esta tecnología hace que las conversaciones sean más naturales.
Generación sincronizada de tokens semánticos y de sonido: Moshi utiliza un mecanismo paralelo de generación de tokens semánticos y de audio, y optimiza las dependencias entre estos tokens mediante la introducción de retardos temporales. Mediante el modelado preciso de los flujos de audio del usuario y del sistema, Moshi puede manejar con flexibilidad escenarios de conversación complejos.
Procesamiento de audio de doble flujo: Moshi procesa simultáneamente los flujos de voz del usuario y del sistema, y logra conversaciones full-duplex mediante el modelado paralelo de dos flujos de audio autorregresivos. Este diseño permite al modelo manejar voces superpuestas e interrupciones en conversaciones naturales.
Alineación retardada de semántica y audio: al introducir un retardo entre los tokens semánticos y los tokens de audio, se garantiza que el contenido de voz generado sea coherente y eficiente. El retardo puede ser de 1 a 2 fotogramas, dependiendo de la dinámica de la conversación.
Moshi: Multi-stream modeling
7. Entrenamiento y ajuste fino del modelo
Preentrenamiento a gran escala: el modelo de lenguaje de texto de Moshi (Helium), preentrenado con más de 2,1 billones de tokens en inglés, posee una rica capacidad de comprensión y generación de lenguaje. El modelo se entrena con grandes volúmenes de datos de texto y voz, y puede manejar diversos escenarios de conversación complejos.
Entrenamiento por fases no supervisado y supervisado: Moshi primero se preentrena con datos de voz no supervisados a gran escala, luego se postentrena con datos multitransmisión que contienen diálogos naturales y, finalmente, se ajusta mediante instrucciones para mejorar su rendimiento en conversaciones reales.
Preentrenamiento de Helium: primero se preentrena el modelo de lenguaje de texto Helium en un gran conjunto de datos textuales para mejorar su capacidad de comprensión e inferencia lingüística.
Preentrenamiento de Moshi: se entrena el modelo de audio multitransmisión en un conjunto de datos de audio no etiquetados para aprender a manejar la generación de voz y la comprensión semántica.
Ajuste fino multitransmisión: se ajusta el modelo utilizando el conjunto de datos Fisher (que contiene datos de conversaciones de voz de dos vías) para mejorar su capacidad de procesar entradas de voz multitransmisión.
Ajuste por instrucciones: por último, se utiliza un ajuste fino con datos de diálogos generados por instrucciones para mejorar el rendimiento del modelo en escenarios de conversación natural.
Aumento de datos: durante el entrenamiento, Moshi utiliza técnicas de aumento de datos, como añadir ruido de fondo y simular ecos del usuario, para que el modelo pueda rendir de forma estable en diferentes entornos de voz y aumentar su robustez.
Evaluación del rendimiento de Moshi
1. Calidad y coherencia de la generación de voz
Claridad de la voz: Moshi destaca en la generación de voz; los experimentos muestran que puede generar voz de alta calidad y fácil de entender. Puede mantener la coherencia de la voz durante el proceso de generación, especialmente en diálogos largos, lo cual es un indicador de rendimiento importante para los modelos de conversación en contextos complejos.
Naturalidad y coherencia de la voz: mediante el uso del códec de audio neuronal Mimi, Moshi puede generar voz de alta fidelidad y mantener la coherencia de la voz del sistema. Además, el modelo puede generar tonos emocionales adecuados según el contexto de la conversación, lo que aumenta la naturalidad de la experiencia del usuario.
2. Rendimiento de respuesta en tiempo real
Baja latencia: la latencia teórica de Moshi es de 160 milisegundos, y en pruebas reales ronda los 200 milisegundos. Esto significa que Moshi puede responder a la entrada del usuario casi en tiempo real, mejorando significativamente la fluidez de la interacción y la experiencia conversacional del usuario.
Capacidad de comunicación full-duplex: Moshi demostró en las pruebas su capacidad para recibir y generar voz simultáneamente. Esta función full-duplex le permite manejar voces superpuestas e interrupciones en la conversación, mostrando una velocidad de respuesta cercana a la de la conversación humana natural.
3. Reconocimiento de voz y comprensión del diálogo
Reconocimiento automático de voz (ASR): mediante el método del monólogo interno, Moshi combina los flujos de texto y voz, lo que mejora significativamente la precisión del reconocimiento de voz. El modelo no solo captura la entrada de voz del usuario, sino que también mejora la precisión de la respuesta del sistema prediciendo primero la generación de texto.
Capacidad de comprensión e inferencia del diálogo: Moshi utiliza el modelo de lenguaje Helium para la comprensión e inferencia de texto, lo que le permite rendir bien en el manejo de problemas complejos, diálogos abiertos y preguntas de conocimiento. Los resultados muestran que Moshi puede comprender eficazmente el contexto y proporcionar respuestas razonables.
4. Robustez del procesamiento de voz multitransmisión
Manejo de voces superpuestas: Moshi puede manejar escenarios de conversación complejos en la evaluación, como diálogos con múltiples flujos de voz superpuestos. Esto es muy importante para el procesamiento multitarea en aplicaciones reales, ya que las conversaciones naturales suelen implicar interrupciones y voces superpuestas.
Manejo de diálogos en múltiples contextos: Moshi se entrena con múltiples flujos de datos y puede rendir bien en diferentes escenarios de conversación, ya sea el flujo de voz de un único usuario o conversaciones simultáneas con varios usuarios.
5. Preguntas y respuestas y adquisición de conocimiento
Moshi supera a otros sistemas de diálogo por voz actuales en tareas de preguntas y respuestas y adquisición de conocimiento. Gracias a su sólida capacidad de comprensión de texto y a la generación de voz en tiempo real, Moshi puede manejar preguntas y respuestas de varias turnos, extrayendo y respondiendo con precisión a las preguntas del usuario.
Inferencia lingüística y preguntas de sentido común: el modelo es capaz de manejar tareas de inferencia complejas y se desenvuelve bien en diversas evaluaciones estándar del procesamiento del lenguaje natural (NLP), como preguntas de sentido común, comprensión lectora y preguntas abiertas.
6. Generación de emoción y personalización de la voz
Generación de voz emocional: Moshi demostró en la evaluación su capacidad para generar voz con carga emocional. Es capaz de producir voz con diferentes emociones, como enfado, alegría o tristeza, según el contexto del diálogo.
Estilo de voz personalizado: mediante el ajuste por instrucciones durante el entrenamiento, Moshi puede generar voz con diferentes estilos o personajes específicos según las necesidades del usuario. Esta capacidad de personalización le permite rendir de forma más diversa en escenarios de conversación específicos.
7. Seguridad y fiabilidad
Evaluación de la seguridad en la conversación: Moshi muestra una buena seguridad al manejar conversaciones que contienen contenido sensible o inapropiado. Es capaz de identificar y evitar eficazmente la generación de contenido inapropiado, garantizando la seguridad y la ética de la conversación.
Robustez y adaptación a entornos ruidosos: en evaluaciones con ruido y entornos complejos, Moshi mostró una buena robustez. Mediante técnicas de aumento de datos (como la adición de ruido y el procesamiento de ecos), el modelo puede hacer frente a diferentes entornos de voz y garantizar una salida de alta calidad en entornos ruidosos.
Octavo. Resultados de pruebas integrales
Las pruebas de rendimiento integrales de Moshi muestran que alcanza resultados líderes en generación de voz, comprensión del diálogo, respuesta en tiempo real y manejo de conversaciones complejas. En particular, Moshi supera con creces a los sistemas de diálogo tradicionales en el manejo de conversaciones superpuestas, interrupciones de voz y generación emocional.
Informe técnico: https://kyutai.org/Moshi.pdf
GitHub: https://github.com/kyutai-labs/moshi
Descarga del modelo: https ://huggingface.co/collections/kyutai/moshi-v01-release-66eaeaf3302bef6bd9ad7acd
Pruébalo en línea: https://moshi.chat/
Noticias relacionadas:














