
 Asistente de guiones▸
 Apps AI
 Noticias AI
YOLO-World: detección de objetos en tiempo real con vocabulario abierto
YOLO-World: detección de objetos en tiempo real con vocabulario abiertoIntroducción
YOLO-World, una herramienta de detección de objetos en tiempo real desarrollada por el laboratorio de ia de Tencent, es capaz de identificar y localizar automáticamente diversos objetos en imágenes. YOLO-World supera a muchos de los métodos más avanzados tanto en velocidad como en precisión.
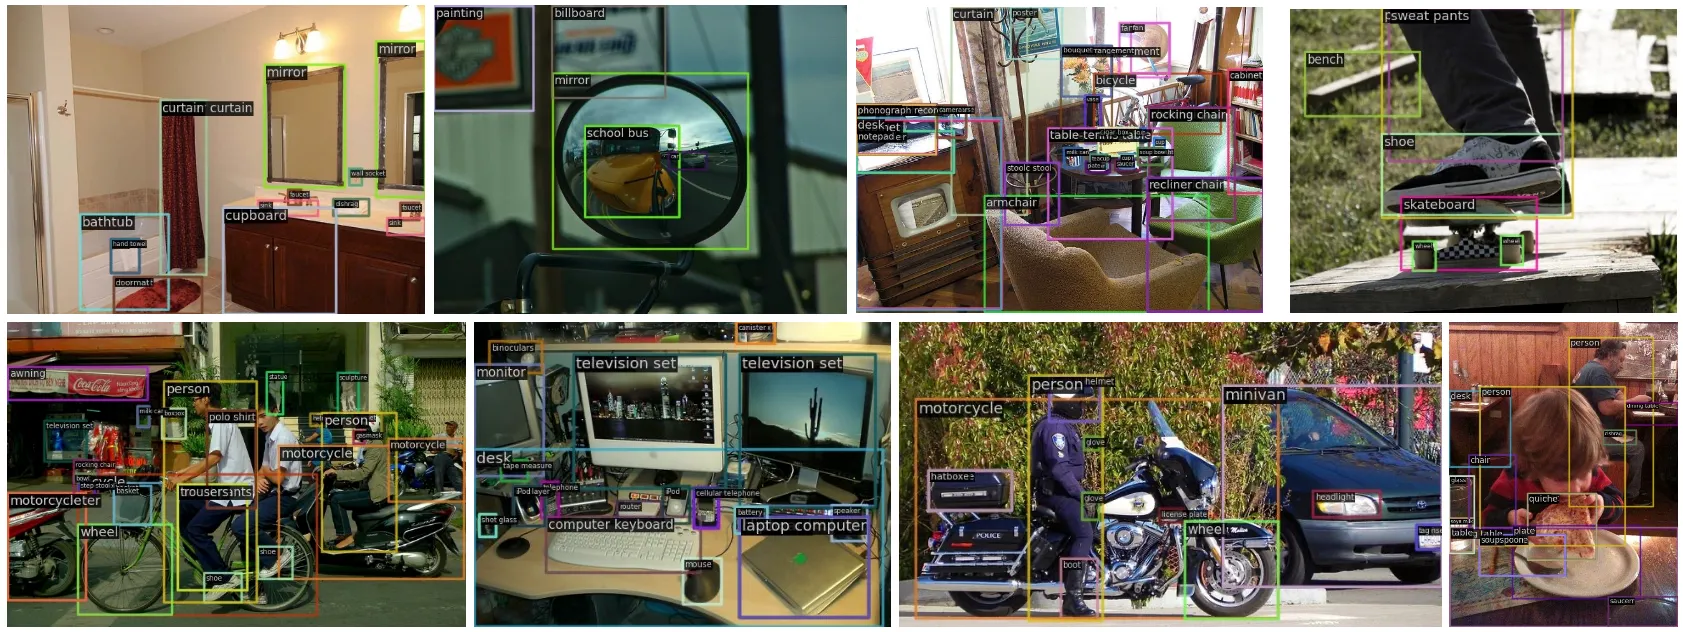
YOLO-World es el detector YOLO de próxima generación, diseñado para la detección de objetos en vocabulario abierto en tiempo real. YOLO-World ha sido preentrenado con conjuntos de datos visuales-lingüísticos a gran escala (incluidos Objects365, GQA, Flickr30K y CC3M), lo que le otorga una potente capacidad de detección en vocabulario abierto sin ejemplos previos y de localización de imágenes, permitiendo la detección de objetos en tiempo real sin necesidad de entrenamiento. Incluso con objetos que no ha visto antes, YOLO-World es adecuado para la detección de objetos y la segmentación de instancias en vocabulario abierto.
Características y funcionalidades de YOLO-World:
1. Aprendizaje a gran escala: YOLO-World adquiere amplios conocimientos visuales y lingüísticos al aprender de una gran cantidad de imágenes y sus descripciones correspondientes (como nombres de objetos), lo que le permite identificar una amplia variedad de objetos.
El proyecto se ha preentrenado con conjuntos de datos visuales-lingüísticos a gran escala, incluyendo Objects365, GQA, Flickr30K y CC3M, lo que otorga a YOLO-World una potente capacidad de detección en vocabulario abierto sin ejemplos previos y de localización dentro de las imágenes.
2. Rápido y preciso: YOLO-World alcanza 35.4 AP en la evaluación sin ejemplos previos en el conjunto de datos LVIS, con una velocidad de procesamiento de 52.0 FPS en una V100, superando a muchos métodos de última generación tanto en velocidad como en precisión. Mantiene una alta precisión incluso en imágenes con escenas complejas. YOLO-World afirma ser 20 veces más rápido que GroundingDINO.
3. Detección sin ejemplos previos: Lo más impresionante es que, incluso con objetos que YOLO-World no ha visto antes, puede identificar y localizar con éxito estos nuevos objetos basándose en el aprendizaje y la comprensión previos, utilizando pistas e información contextual de la imagen. Esto significa que no necesitamos entrenarlo para que detecte nuevas clases de objetos. Basta con proporcionar el nombre de la clase como texto de entrada, y el modelo devolverá los cuadros delimitadores de esos objetos (si existen).
4. Comprensión de objetos: YOLO-World no solo se basa en información visual, sino que también combina información lingüística. Entiende las descripciones en lenguaje humano, lo que le permite identificar objetos incluso si no los ha visto directamente antes.
5. En comparación con los métodos existentes de detección en vocabulario abierto, el modelo YOLO-World es al menos 20 veces más rápido. Puede procesar aproximadamente 52 fotogramas por segundo.
6. Establece nuevos estándares de vanguardia en el conjunto de datos de detección de objetos LVIS.














