
 Asistente de guiones▸
 Apps AI
 Noticias AI
¿Cuál es la diferencia entre Llama 4 Scout y Maverick?
小编 ·

¿Cuál es la diferencia entre Llama 4 Scout y Maverick?
El 5 de abril de 2025, Meta presentó la última generación de modelos de ia de código abierto, Llama 4, que incluye Llama 4 Scout y Llama 4 Maverick. Ambos modelos de IA son los primeros modelos multimodales que adoptan una arquitectura de Mezcla de Expertos (MoE), ¿cuáles son sus diferencias?
Principales diferencias entre Llama 4 Scout y Llama 4 Maverick:
Llama 4 Scout
Escala de parámetros: 17 mil millones de parámetros activos, 16 modelos "expertos", con un total de 109 mil millones de parámetros.
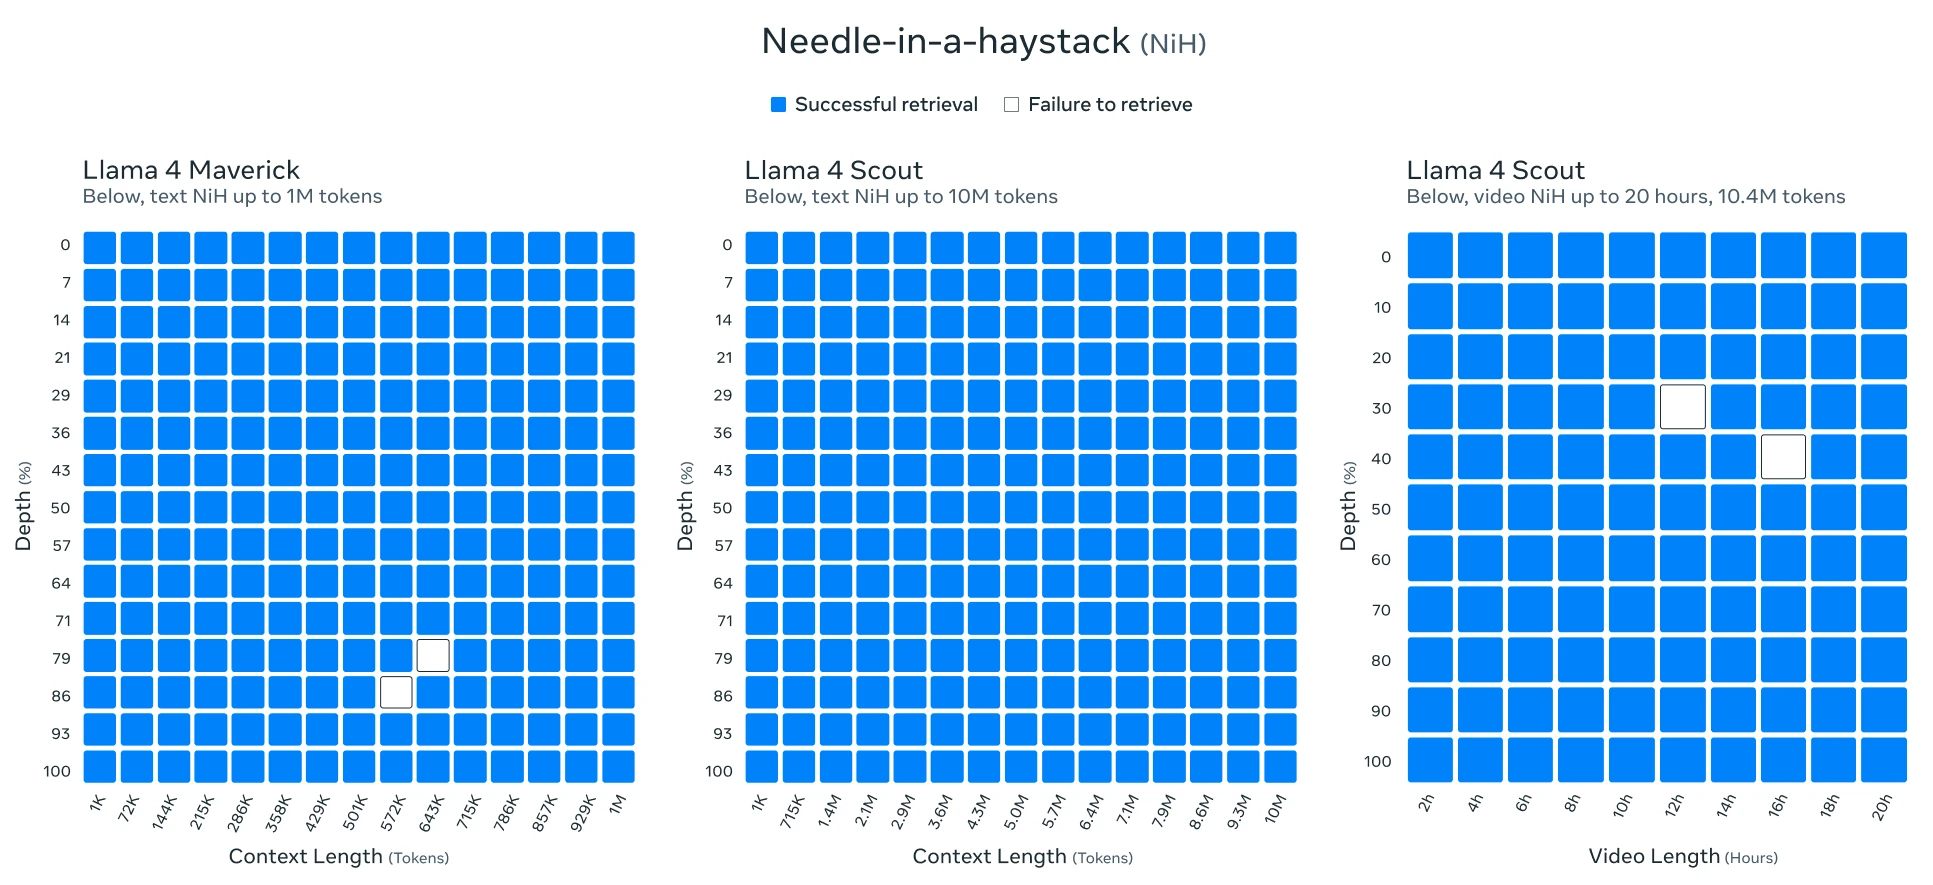
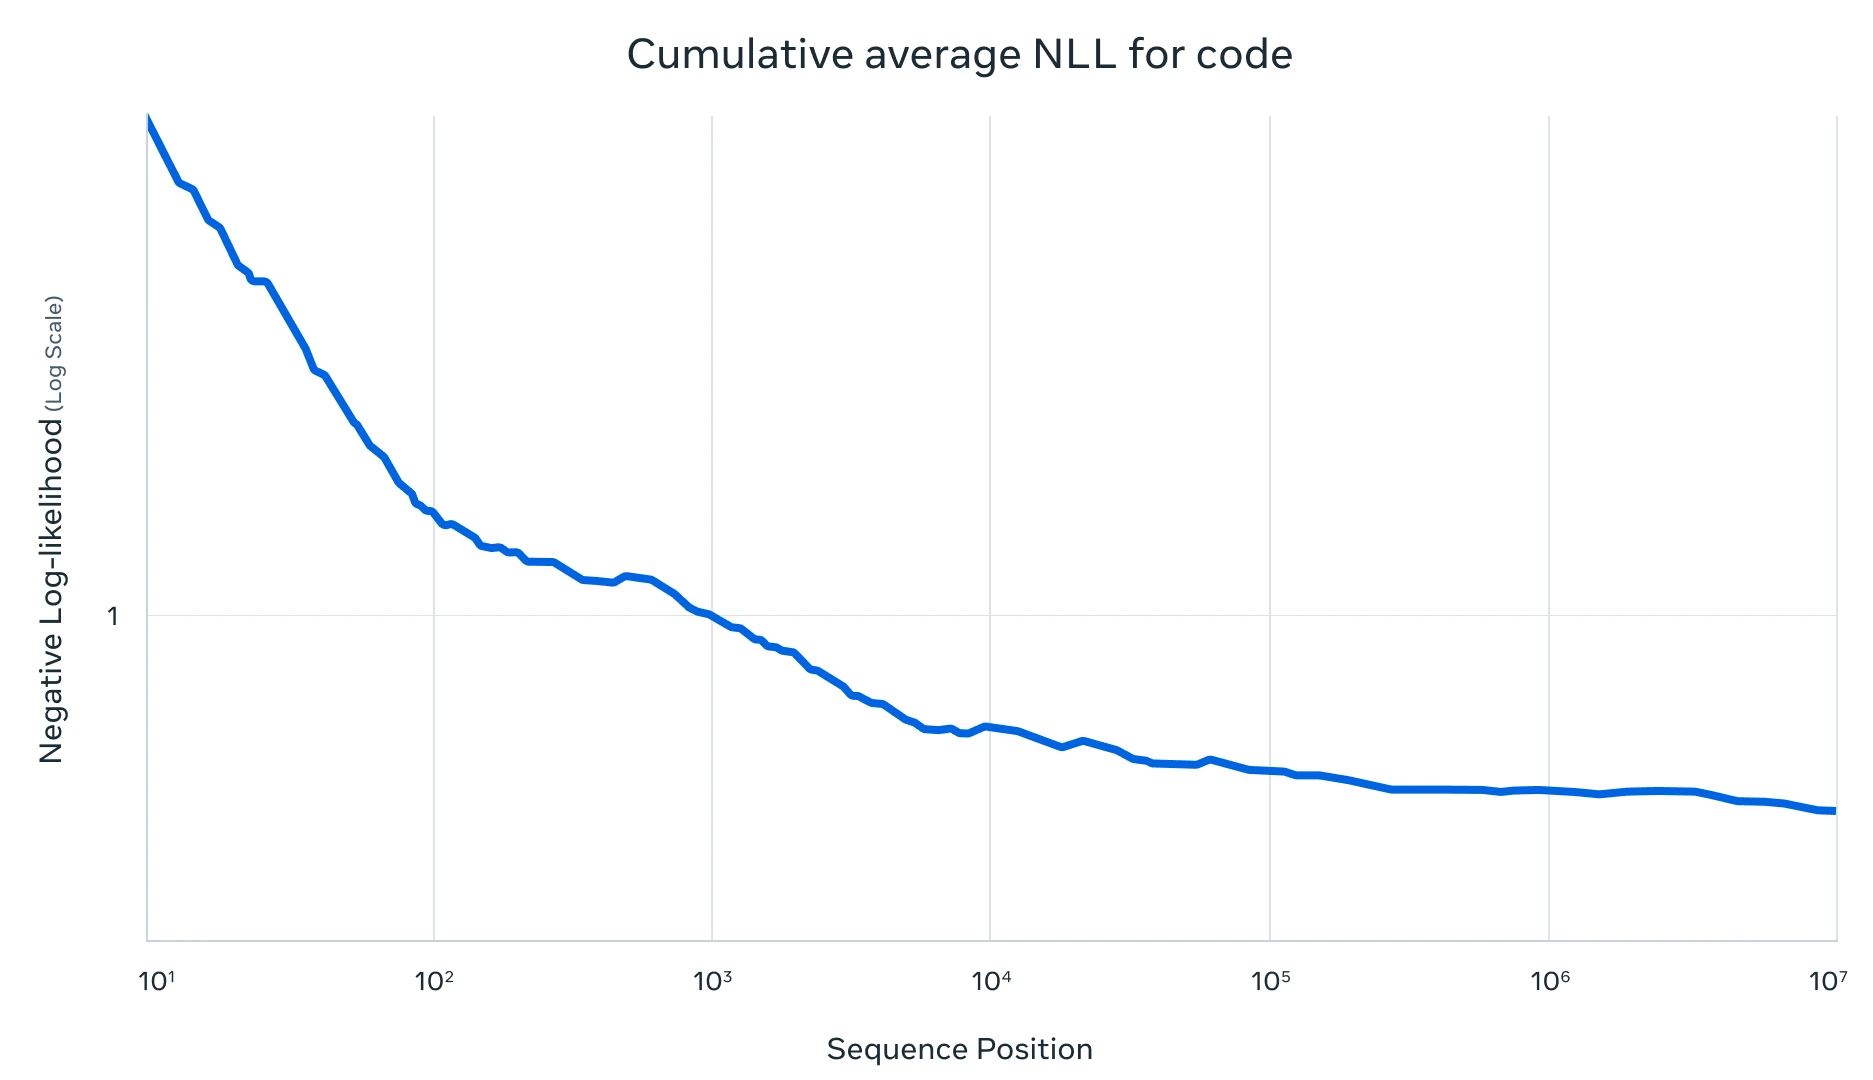
Ventana de contexto: admite una ventana de contexto de hasta 10 millones de tokens, lo que lo hace destacar en el procesamiento de documentos extensos.
Casos de uso: destaca en el resumen de documentos y el razonamiento basado en grandes bases de código, ideal para escenarios que requieren razonamiento eficiente y procesamiento de textos largos.
Requisitos de hardware: puede ejecutarse en una sola GPU NVIDIA H100, y tras la cuantización Int4, los requisitos de recursos son menores.
Llama 4 Maverick
Escala de parámetros: 17 mil millones de parámetros activos, 128 modelos "expertos", con un total de hasta 400 mil millones de parámetros.
Ventana de contexto: admite una ventana de contexto de 1 millón de tokens.
Casos de uso: supera a modelos como el GPT-4o de OpenAI y el Gemini 2.0 de Google en escritura creativa, generación de código, traducción, razonamiento, resumen de contextos de textos largos y pruebas de referencia de imágenes.
Requisitos de hardware: necesita ejecutarse en un host NVIDIA H100 DGX o un dispositivo con rendimiento equivalente.
Comparación entre ambos
Rendimiento: Maverick presenta un rendimiento superior en tareas multimodales y capacidades de razonamiento, mientras que Scout destaca en el procesamiento de textos largos y el resumen de documentos.
Requisitos de recursos: Scout es más adecuado para escenarios con recursos limitados, ya que puede ejecutarse en una sola GPU; Maverick requiere una configuración de hardware más alta.
Casos de uso: Scout es ideal para escenarios que requieren procesar grandes volúmenes de texto, como el procesamiento de documentos y el razonamiento sobre código; Maverick es más adecuado para tareas que requieren interacción multimodal y razonamiento complejo, como la escritura creativa y el procesamiento de imágenes.
Coste de inferencia
Llama 4 Scout: debido a su menor escala de modelo y a técnicas de cuantificación eficientes, el coste de inferencia es relativamente bajo, lo que lo hace adecuado para aplicaciones que requieren una respuesta rápida y un bajo consumo de recursos.
Llama 4 Maverick: aunque su número total de parámetros es mayor, gracias a la arquitectura de Mezcla de Expertos, su coste de inferencia también se ha optimizado. Meta estima que el coste de inferencia de Llama 4 Maverick oscila entre 0,19 y 0,49 dólares por cada millón de tokens (con una proporción de entrada y salida de 3:1), lo que lo hace mucho más económico que modelos propietarios como GPT-4o.
Llama 4 Scout es más adecuado para escenarios que requieren procesar textos largos y cuentan con recursos limitados, mientras que Llama 4 Maverick destaca por su capacidad de razonamiento y generación de código, siendo ideal para aplicaciones que requieren alto rendimiento y procesamiento multimodal. Ambos aprovechan eficientemente los recursos gracias a la arquitectura de Mezcla de Expertos, pero los requisitos de recursos y costes específicos dependen de tu propio caso de uso y hardware.









