
 Asistente de guiones▸
 Apps AI
 Noticias AI
Llama 4: primeros modelos de IA multimodal con arquitectura Mixture-of-Experts
小编 ·

Llama 4: primeros modelos de IA multimodal con arquitectura Mixture-of-Experts
¿Qué es Llama 4?
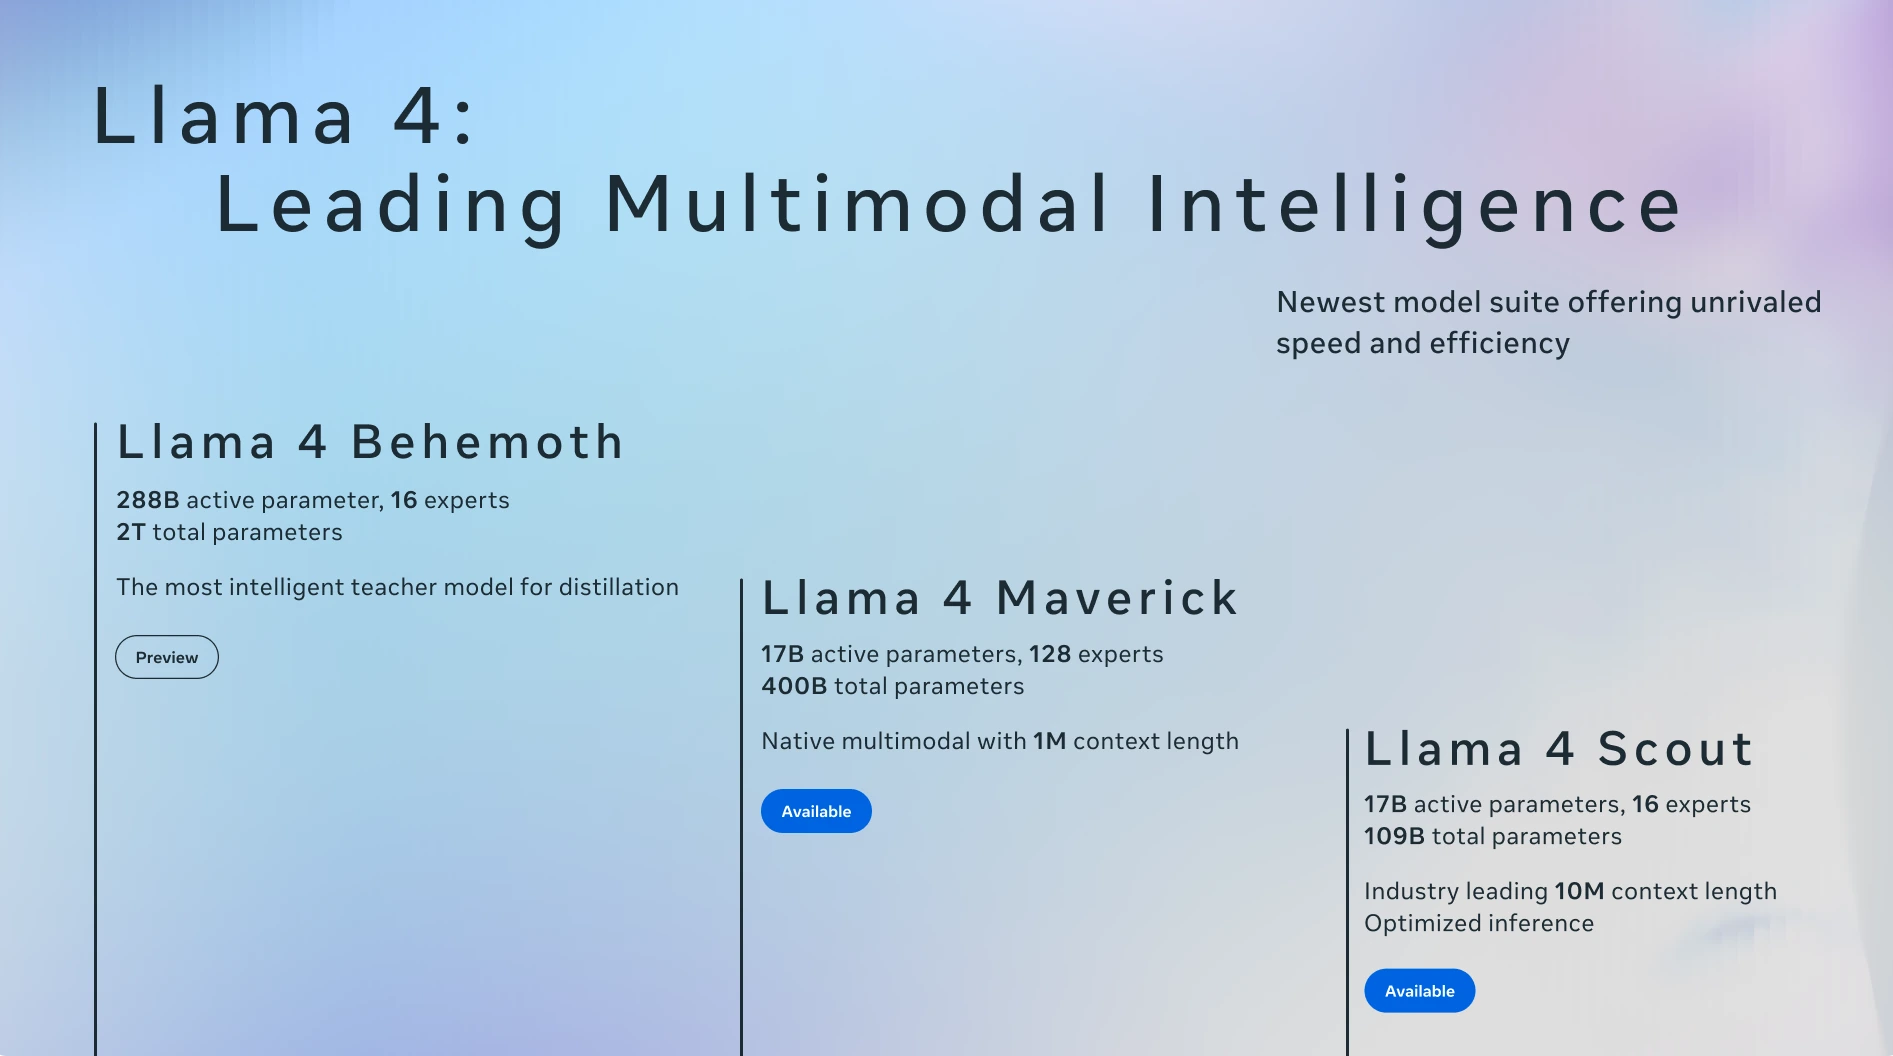
Llama 4 es la última generación de modelos de IA de código abierto publicada por Meta el 5 de abril de 2025. Incluye Llama 4 Scout y Llama 4 Maverick, los cuales son los primeros modelos de IA multimodales que adoptan una arquitectura de mezcla de expertos (MoE). Scout cuenta con 17.000 millones de parámetros activos, 16 modelos "expertos" y un total de 109.000 millones de parámetros, mientras que Maverick también tiene 17.000 millones de parámetros activos, pero está equipado con 128 modelos "expertos" y un total de 400.000 millones de parámetros. Además, hay una versión aún más potente en desarrollo, Llama 4 Behemoth, que tiene 288.000 millones de parámetros activos, 16 modelos "expertos" y un total cercano a 2 billones de parámetros. Estos modelos están entrenados con grandes cantidades de datos de texto, imágenes y vídeos sin etiquetar, y poseen capacidades de comprensión visual.
Serie de modelos Llama 4
Llama 4 Scout
Tamaño de los parámetros: 17.000 millones de parámetros activos, 16 expertos
Requisitos de hardware: puede ejecutarse en una sola GPU NVIDIA H100
Ventana de contexto: admite una ventana de contexto ultralarga de hasta 10 millones de tokens
Ventajas de rendimiento: supera a Gemma 3, Gemini 2.0 Flash-Lite y Mistral 3.1
Llama 4 Maverick
Tamaño de los parámetros: 17.000 millones de parámetros activos, 128 expertos, con un total de 400.000 millones de parámetros
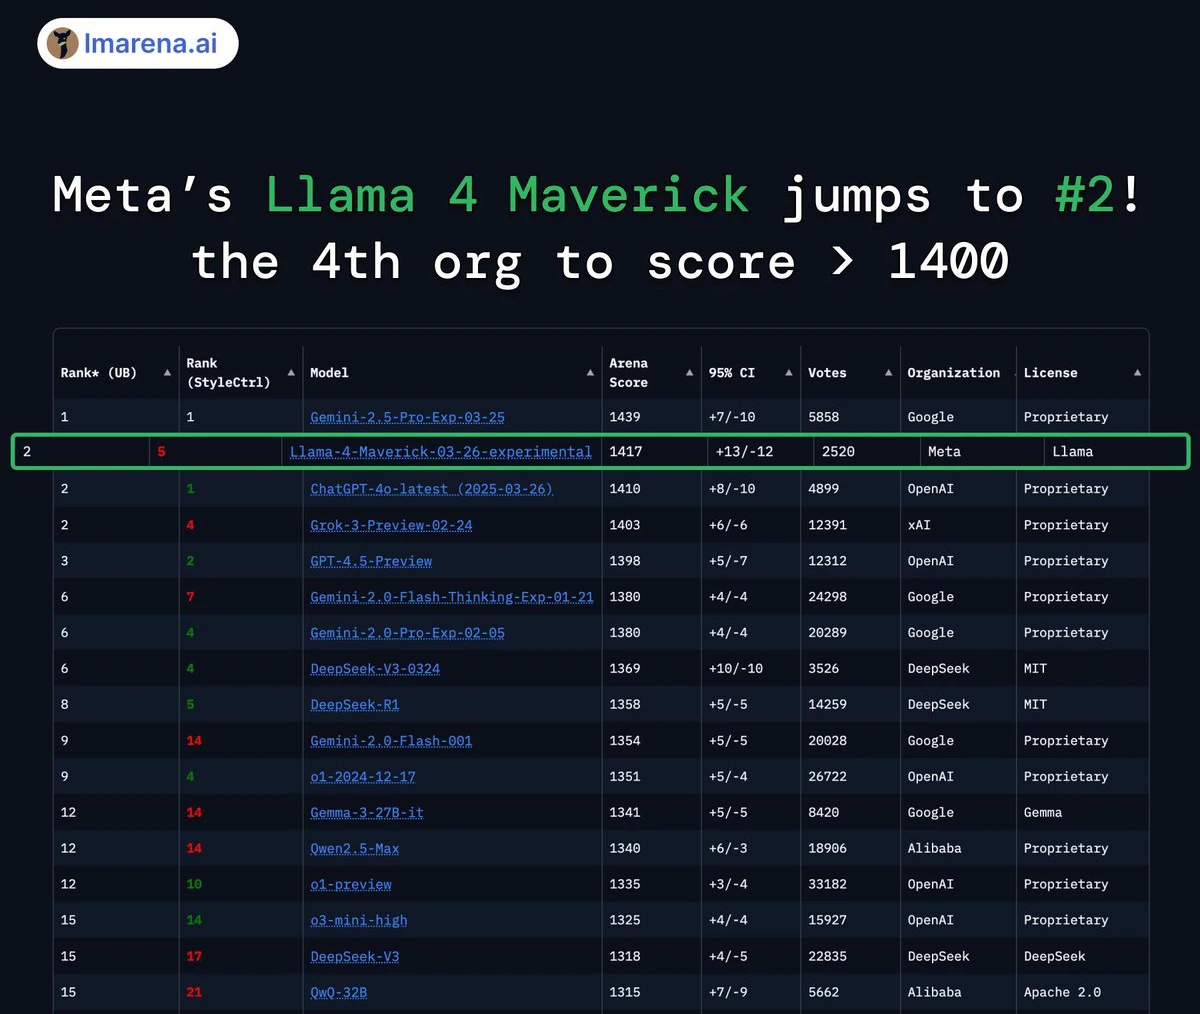
Ventajas de rendimiento: rendimiento excepcional en tareas multimodales, superando a GPT-4o y Gemini 2.0 Flash
Capacidad de razonamiento: capacidades de razonamiento y programación comparables a las de DeepSeek v3, pero con menos de la mitad de parámetros activos
Llama 4 Behemoth (versión preliminar)
Tamaño de los parámetros: 288.000 millones de parámetros activos, 16 expertos, con un total cercano a 2 billones de parámetros
Ventajas de rendimiento: en varias pruebas de referencia STEM, su rendimiento supera al de GPT-4.5, Claude Sonnet 3.7 y Gemini 2.0 Pro
Posicionamiento: se utiliza como modelo docente para destilar otros modelos Llama 4; actualmente sigue en entrenamiento
Características de Llama 4
Capacidad multimodal: Llama 4 es un modelo grande multimodal capaz de procesar e integrar diferentes tipos de datos como texto, vídeo, imágenes y audio, y de convertir contenido entre estos formatos. Por ejemplo, Llama 4 Scout puede analizar el contenido de imágenes en entornos complejos.
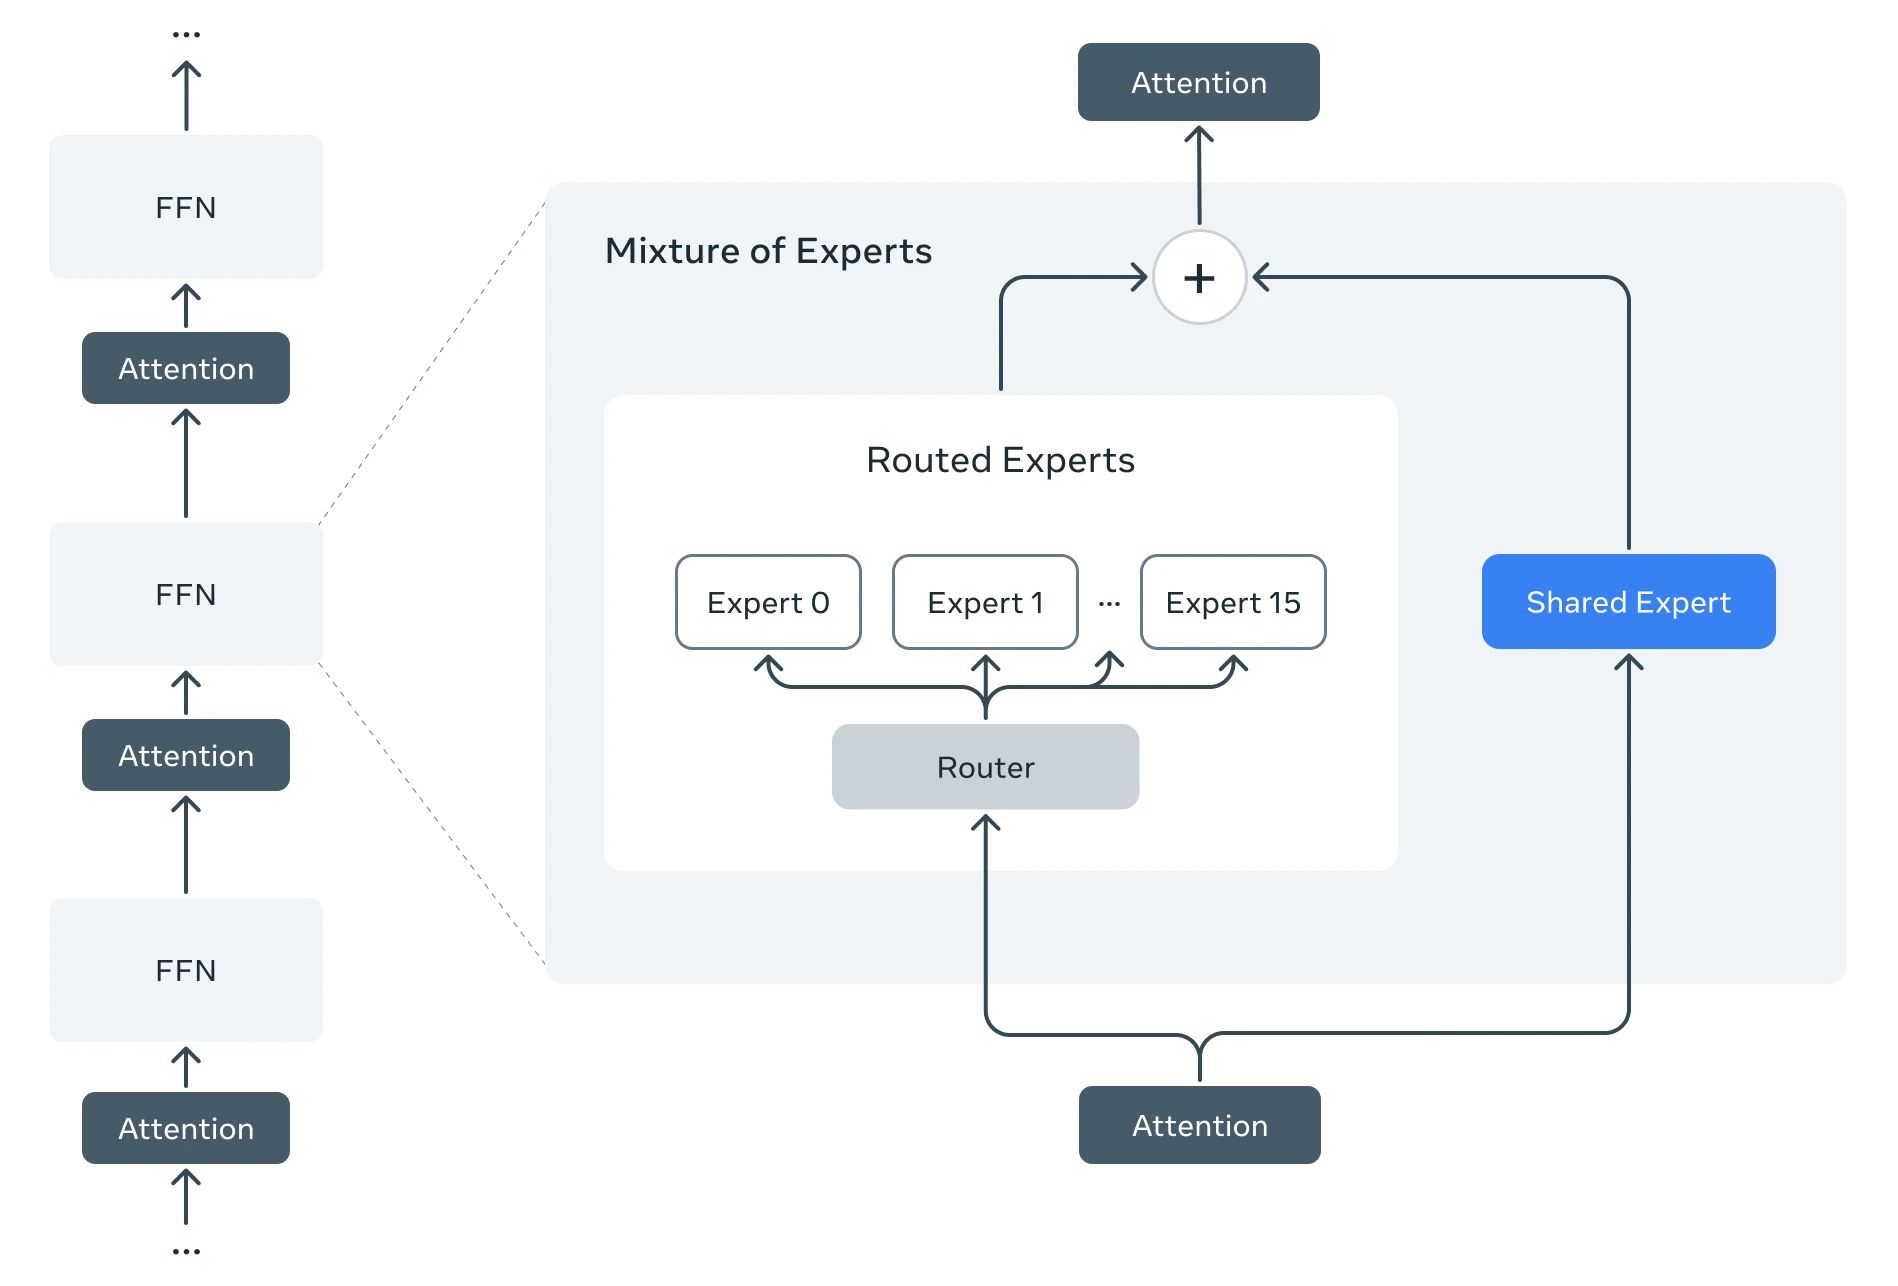
Arquitectura de mezcla de expertos: esta es una de las características principales de Llama 4. Esta arquitectura divide el modelo en varios submodelos "expertos" especializados en tareas concretas, lo que mejora la eficiencia tanto en el entrenamiento como al responder a las consultas de los usuarios. Por ejemplo, el modelo Llama 4 Maverick tiene un total de 400.000 millones de parámetros, pero solo 17.000 millones están activos durante el cálculo real.
Capacidad de procesamiento de contexto largo: la ventana de contexto de Llama 4 Scout puede alcanzar los 10 millones de tokens, lo que le permite rendir especialmente bien al manejar documentos extensos.
Funciones de voz: Llama 4 incorpora procesamiento nativo de voz, capaz de manejar información de voz directamente, sin necesidad de convertir primero la voz a texto para introducirla en el modelo y luego volver a convertir el texto en voz. Esto mejora enormemente la eficiencia y la fluidez de la interacción por voz.
Aplicaciones
Atención al cliente: las empresas pueden utilizar este modelo de IA multimodal para analizar rápidamente las preguntas de los usuarios y ofrecer respuestas más precisas y eficientes.
Ámbito educativo: los asistentes inteligentes de enseñanza pueden explicar conceptos complejos comprendiendo las preguntas de los estudiantes y complementándolas con imágenes, mejorando enormemente el aprendizaje.
Reuniones virtuales: en reuniones virtuales, Llama 4 puede actuar como asistente, ayudando a los usuarios con la traducción en tiempo real, tomando notas de los puntos clave e incluso simulando las intervenciones de los participantes, mejorando la eficiencia en la comunicación.
Control de dispositivos inteligentes: mediante comandos de voz, los usuarios pueden completar fácilmente tareas como redactar textos, enviar mensajes y controlar dispositivos del hogar inteligente.
Áreas con alta densidad de información: la capacidad de procesamiento de contexto largo de Llama 4 lo hace muy útil en campos con alta densidad de información como la medicina, la ciencia, la ingeniería, las matemáticas y la literatura.
Características técnicas de Llama 4
Tamaño del modelo y cantidad de parámetros: Llama 4 Scout cuenta con 17.000 millones de parámetros activos, 16 modelos "expertos" y un total de 109.000 millones de parámetros; Llama 4 Maverick también tiene 17.000 millones de parámetros activos, pero está equipado con 128 modelos "expertos" y un total de 400.000 millones de parámetros; Llama 4 Behemoth, por su parte, tiene 288.000 millones de parámetros activos y un total de 2 billones de parámetros.
Datos de entrenamiento y diversidad: todos los modelos se han entrenado con grandes cantidades de datos de texto, imágenes y vídeos sin etiquetar para obtener amplias capacidades de comprensión visual.
Optimización de la arquitectura: se ha adoptado una arquitectura de mezcla de expertos que, al descomponer las tareas de procesamiento de datos en subtareas y asignarlas a modelos "expertos" más pequeños, logra una mayor eficiencia operativa.
Eficiencia de inferencia: se ha mejorado la eficiencia de inferencia reduciendo el coste y la latencia de funcionamiento del modelo. Por ejemplo, Llama 4 Maverick puede ejecutarse en un único host NVIDIA H100 DGX.
Meta estima que el coste de inferencia de Llama 4 Maverick es de entre 0,19 y 0,49 dólares por cada millón de tokens (con una proporción de entrada y salida de 3:1), lo que lo hace mucho más económico que modelos propietarios como GPT-4o.
Lectura detallada:https://ai.meta.com/blog/llama-4-multimodal-intelligence/
Descarga del modelo:https://www.llama.com/llama-downloads/?utm_source=llama-home-hero&utm_medium=llama-referral&utm_campaign=llama-utm&utm_offering=llama-downloads&utm_product=llama









