
 Asistente de guiones▸
 Apps AI
 Noticias AI
MoshiVis: un modelo visión-voz que escucha, ve y conversa sobre imágenes con voz fluida
小编 ·

MoshiVis: un modelo visión-voz que escucha, ve y conversa sobre imágenes con voz fluida
¿Qué es MoshiVis?
MoshiVis es un modelo de voz visual desarrollado sobre la base de Moshi, que mantiene la baja latencia y la capacidad de conversación natural de Moshi, y es capaz de discutir el contenido de imágenes en un estilo de conversación natural. Admite conversaciones de múltiples turnos, puede describir el contenido textual de las imágenes y responder preguntas relacionadas con ellas.
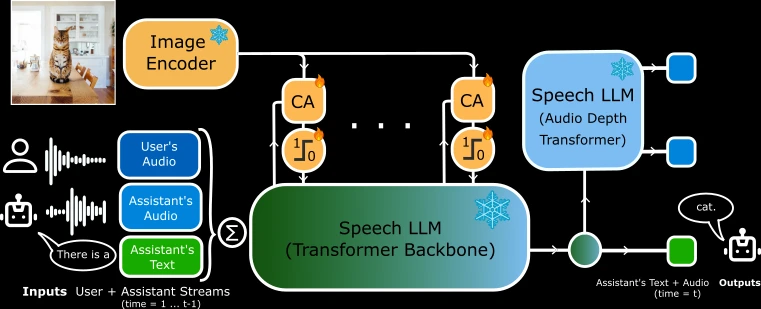
Integra la información visual en el flujo de voz mediante un mecanismo de atención cruzada, manteniendo al mismo tiempo una baja latencia y un bajo consumo de memoria. MoshiVis ofrece compatibilidad con múltiples backends (como PyTorch, Rust y MLX) y ha publicado modelos preentrenados y un conjunto de datos sintético de diálogos visuales, siendo adecuado para escenarios de interacción por voz en tiempo real.
Funciones principales de MoshiVis
Combinación de visión y voz: MoshiVis añade capacidad de comprensión visual sobre la base de Moshi, permitiendo integrar la información de las imágenes en la conversación por voz. Mediante la ampliación de la arquitectura Transformer principal, introduce un mecanismo de atención cruzada que inyecta la información visual en el flujo de voz.
Baja latencia y bajo consumo de memoria: para mantener una baja latencia y reducir el uso de memoria, los pesos de proyección de atención cruzada de MoshiVis se comparten entre capas y se ajustan mediante un mecanismo de compuerta que regula el flujo de entrada visual.
Estilo de conversación natural: el modelo conserva el estilo de conversación natural original de Moshi mientras incorpora la capacidad visual.
Arquitectura técnica de MoshiVis
Modelo base: basado en Moshi, un modelo base de voz-texto con 7B de parámetros.
Codificador visual: utiliza un codificador visual preentrenado y congelado de 400M de la familia PaliGemma2.
Parámetros del adaptador: se añaden aproximadamente 206M de parámetros de adaptador sobre Moshi, dedicados al procesamiento de la información visual.
Mecanismo de atención cruzada: inyecta la información visual en el flujo de voz mediante módulos de atención cruzada, regulando al mismo tiempo la influencia de la entrada visual a través de un mecanismo de compuerta.
Lanzamiento del modelo MoshiVis
Variantes del modelo: se ha publicado el modelo MoshiVis basado en Moshika (voz femenina), que incluye los pesos completos del modelo: el codec de voz, el tokenizador de texto, el codificador de imágenes y el modelo base Moshi.
Soporte de backends: se proporcionan tres opciones de backend, incluyendo PyTorch, Rust y MLX, compatibles con distintos formatos de cuantización (como BF16, Q8_0, etc.).
Licencia: los pesos del modelo (excluido el codificador visual) se publican bajo la licencia CC-BY 4.0, mientras que el codificador visual se publica bajo la licencia Gemma.
Cómo utilizar MoshiVis
Frontend WebUI: se ofrece un frontend WebUI que soporta cancelación de eco para mejorar el rendimiento del modelo. Los usuarios pueden utilizarlo a través de la versión estática precompilada o compilando el código fuente por su cuenta.
Ejecución del backend:
PyTorch: requiere aproximadamente 24 GB de memoria GPU y no soporta cuantización.
Rust: soporta aceleración por GPU y requiere la cadena de herramientas de Rust y CUDA (o Metal en macOS).
MLX: soporta los formatos bfloat16 y cuantización (q4, q8).
Comandos de ejecución: se proporcionan comandos detallados de ejecución, y los usuarios pueden elegir el backend y el formato de cuantización según sus necesidades.
Enlaces relacionados:
Repositorio en GitHub:https://github.com/kyutai-labs/moshivis
Modelo en HuggingFace:https://huggingface.co/collections/kyutai/moshivis-v01-67cef4acae6a5d75d6d6c883
Artículo:https://arxiv.org/abs/2503.15633









