
 Asistente de guiones▸
 Apps AI
 Noticias AI
Umi-OCR: herramienta OCR offline, gratuita, de código abierto y por lotes
小编 ·

Umi-OCR: herramienta OCR offline, gratuita, de código abierto y por lotes
¿Qué es Umi-OCR?
Umi-OCR es una herramienta de OCR offline, gratuita y de código abierto, desarrollada sobre el framework PaddleOCR de Baidu. Permite la captura de pantalla/importación por lotes de imágenes, reconocimiento de documentos PDF, eliminación de marcas de agua/encabezados y pies de página, escaneo/generación de códigos QR, e incluye bibliotecas multilingües. Ofrece alta precisión de reconocimiento, ejecución offline, soporte multilingüe y procesamiento por lotes eficiente.
Características de Umi-OCR
Ejecución offline: funciona completamente sin conexión, sin necesidad de red, protegiendo la privacidad del usuario.
Soporte multilingüe: incorpora bibliotecas de múltiples idiomas y admite el reconocimiento de textos en numerosos idiomas.
Múltiples funciones de reconocimiento:
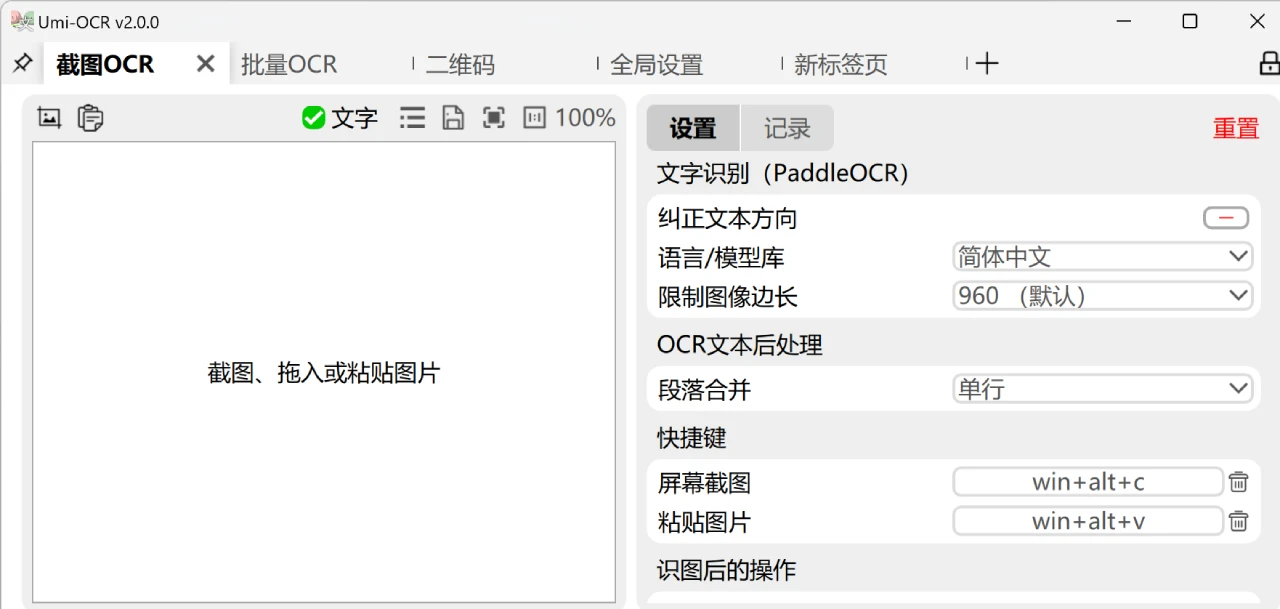
OCR por captura: permite realizar el reconocimiento de texto a partir de capturas de pantalla o imágenes pegadas.
OCR por lotes: posibilita la importación masiva de imágenes para reconocimiento de texto, compatible con múltiples formatos de imagen.
Reconocimiento de PDF: permite extraer texto de documentos PDF y excluir encabezados, pies de página, etc.
Reconocimiento de códigos QR: admite el escaneo y la generación de códigos QR.
Reconocimiento de fórmulas: soporta el reconocimiento de fórmulas matemáticas (en fase de prueba).
Postprocesamiento de texto: permite dar formato y limpiar los resultados del reconocimiento, eliminando texto no deseado.
Invocación flexible: admite llamadas mediante línea de comandos e interfaz HTTP, facilitando la integración para desarrolladores.
Características técnicas de Umi-OCR
Reconocimiento de alta precisión: incorpora múltiples modelos lingüísticos y admite chino simplificado/tradicional, inglés, japonés, coreano y los principales idiomas europeos, además de reconocer textos con maquetación mixta.
Análisis de maquetaciones complejas: identifica con precisión textos en vertical, tablas y fórmulas matemáticas sencillas.
Optimización de imágenes de baja calidad: aplica un preprocesamiento a imágenes borrosas, inclinadas o con poca luz para mejorar la precisión del reconocimiento.
Procesamiento por lotes eficiente y salida flexible: permite arrastrar carpetas o importar imágenes de forma masiva para completar el reconocimiento OCR de cientos de archivos con un solo clic.
Escenarios de uso de Umi-OCR
Entorno de oficina: extrae rápidamente texto de PDF escaneados e informes en imágenes para convertirlos en documentos editables.
Investigación académica: reconoce textos en idiomas extranjeros y materiales antiguos, ayudando en la traducción y las citas.
Procesamiento multimedia: ofrece soporte de extracción de texto para capturas de vídeo, traducción de cómics y subtítulos de juegos.
Flujos automatizados: se integra en otras cadenas de herramientas mediante la interfaz de línea de comandos, permitiendo automatizar el OCR por lotes.
Descarga y uso de Umi-OCR
Enlaces de descarga:
Lanzou Cloud (recomendado en China, sin registro y sin límite de velocidad):https://hiroi-sora.lanzoul.com/s/umi-ocr
GitHub Release:https://github.com/hiroi-sora/Umi-OCR/releases/tag/v2.1.4
Instalación: listo para usar tras descomprimir, no requiere instalación. Compatible con Windows 7 x64 y Linux x64.
Instalación por línea de comandos: mediante Scoop (Windows):
scoop install extras/umi-ocr
Planes futuros
Reestructurar el mecanismo de plugins subyacente.
Añadir plugins de API de OCR online.
Implementar un plugin independiente de reconocimiento de fórmulas matemáticas.
Ofrecer soporte para traducción de imágenes y traducción offline.
Compatibilidad con macOS y más distribuciones de Linux.
Hace un par de días presentamos también olmOCR, que también es una buena opción si lo que necesitas es, sobre todo, convertir PDF.









