
 Asistente de guiones▸
 Apps AI
 Noticias AI
olmOCR: potente herramienta OCR de código abierto para convertir PDF y documentos con alta precisión
小编 ·

olmOCR: potente herramienta OCR de código abierto para convertir PDF y documentos con alta precisión
¿Qué es OLMOCR?
OLMOCR es una herramienta de código abierto capaz de convertir archivos PDF a texto con alta precisión. La conversión preserva el orden de lectura del documento y admite el reconocimiento de tablas, ecuaciones y contenido manuscrito, además de contar con capacidad de procesamiento de documentos de alto rendimiento, conversión de texto que conserva el orden natural de lectura y alta precisión para reducir las alucinaciones.
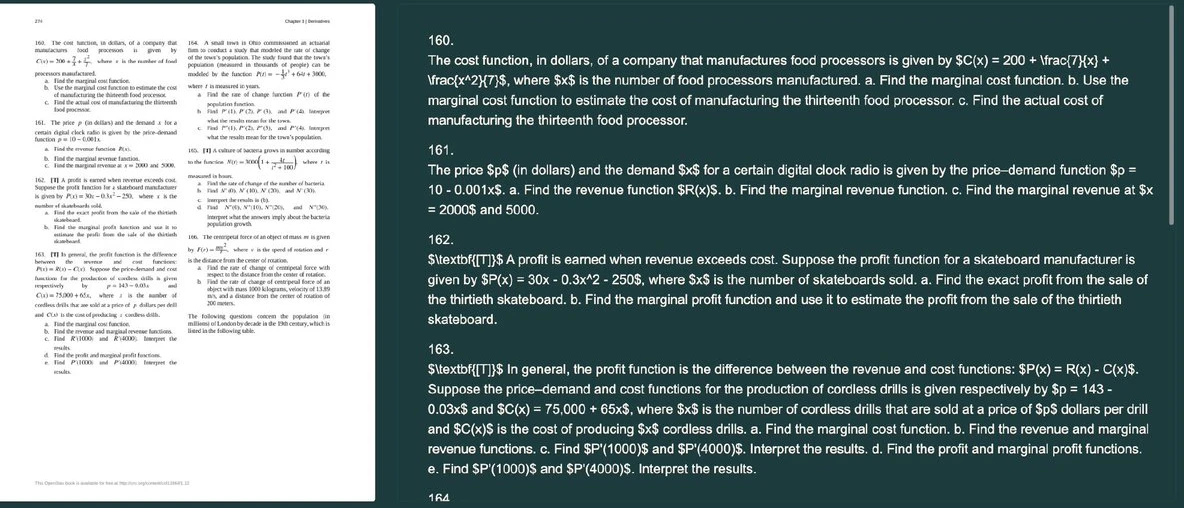
Funciones y características de olmOCR
Alta precisión: OLMOCR ofrece tecnología OCR avanzada, garantizando la máxima conservación de la precisión del contenido durante el proceso de conversión.
Soporte de múltiples formatos: esta herramienta puede procesar diferentes tipos de PDF, incluidos documentos con formatos complejos.
Kit de desarrollo: además de las funciones básicas de OCR, OLMOCR incluye un conjunto de herramientas para linealizar PDF, lo que facilita la generación de conjuntos de datos aptos para el entrenamiento de modelos de lenguaje de IA.
Casos de uso de olmOCR
Puede utilizarse para digitalizar imágenes de documentos en papel a texto, facilitando la gestión documental.
Las funciones integradas ayudan a los usuarios a extraer datos clave, como el contenido de tablas, para su posterior análisis y uso.
Adecuado para empresas e instituciones de investigación que necesitan procesar grandes volúmenes de documentos.
Puede aplicarse en el ámbito educativo para digitalizar materiales de exámenes y convertir notas manuscritas.
El sector médico puede aprovechar esta herramienta para procesar historiales clínicos y formularios escaneados.
El ámbito legal puede utilizarla para gestionar y recuperar documentos jurídicos de forma eficiente.
Ideal para proyectos de investigación histórica que requieran digitalizar y archivar documentos en papel.
Ventajas de olmOCR
Reconocimiento de alta precisión: capaz de identificar estructuras complejas (como tablas, ecuaciones, etc.).
Rentable: el coste de conversión es de solo 190 dólares por cada millón de páginas PDF.
Capacidad de procesamiento a gran escala: permite la conversión masiva y por lotes de archivos.
Compatibilidad con múltiples hardware: puede adaptarse a diferentes configuraciones de hardware para su ejecución.
Conjunto completo de componentes: ofrece pesos del modelo, datos y código de entrenamiento, para que los usuarios puedan elegir con flexibilidad.
Preguntas frecuentes sobre olmOCR
P: ¿Admite el reconocimiento de texto manuscrito?
R: Sí, olmOCR puede reconocer texto manuscrito.
P: ¿Existe algún límite para el procesamiento por lotes?
R: olmOCR admite el procesamiento por lotes a gran escala y se adapta con flexibilidad a distintos entornos de hardware.
P: ¿Ofrece una versión de prueba gratuita?
R: La documentación general y todos los componentes son de código abierto y están disponibles en GitHub.
P: ¿Cuál es el tiempo medio de procesamiento por página de PDF?
R: El tiempo concreto depende de la configuración del hardware, pero en general el coste de funcionamiento es muy bajo.
P: ¿Qué idiomas se admiten?
R: olmOCR admite varios idiomas, incluyendo contenidos con estructuras complejas.
Demo en línea:visite olmocr.allenai.org
Repositorio de GitHub:https://github.com/allenai/olmocr









