
 Asistente de guiones▸
 Apps AI
 Noticias AI
Janus-Pro vs. JanusFlow: ¿cuáles son sus diferencias y similitudes?
小编 ·

Janus-Pro vs. JanusFlow: ¿cuáles son sus diferencias y similitudes?
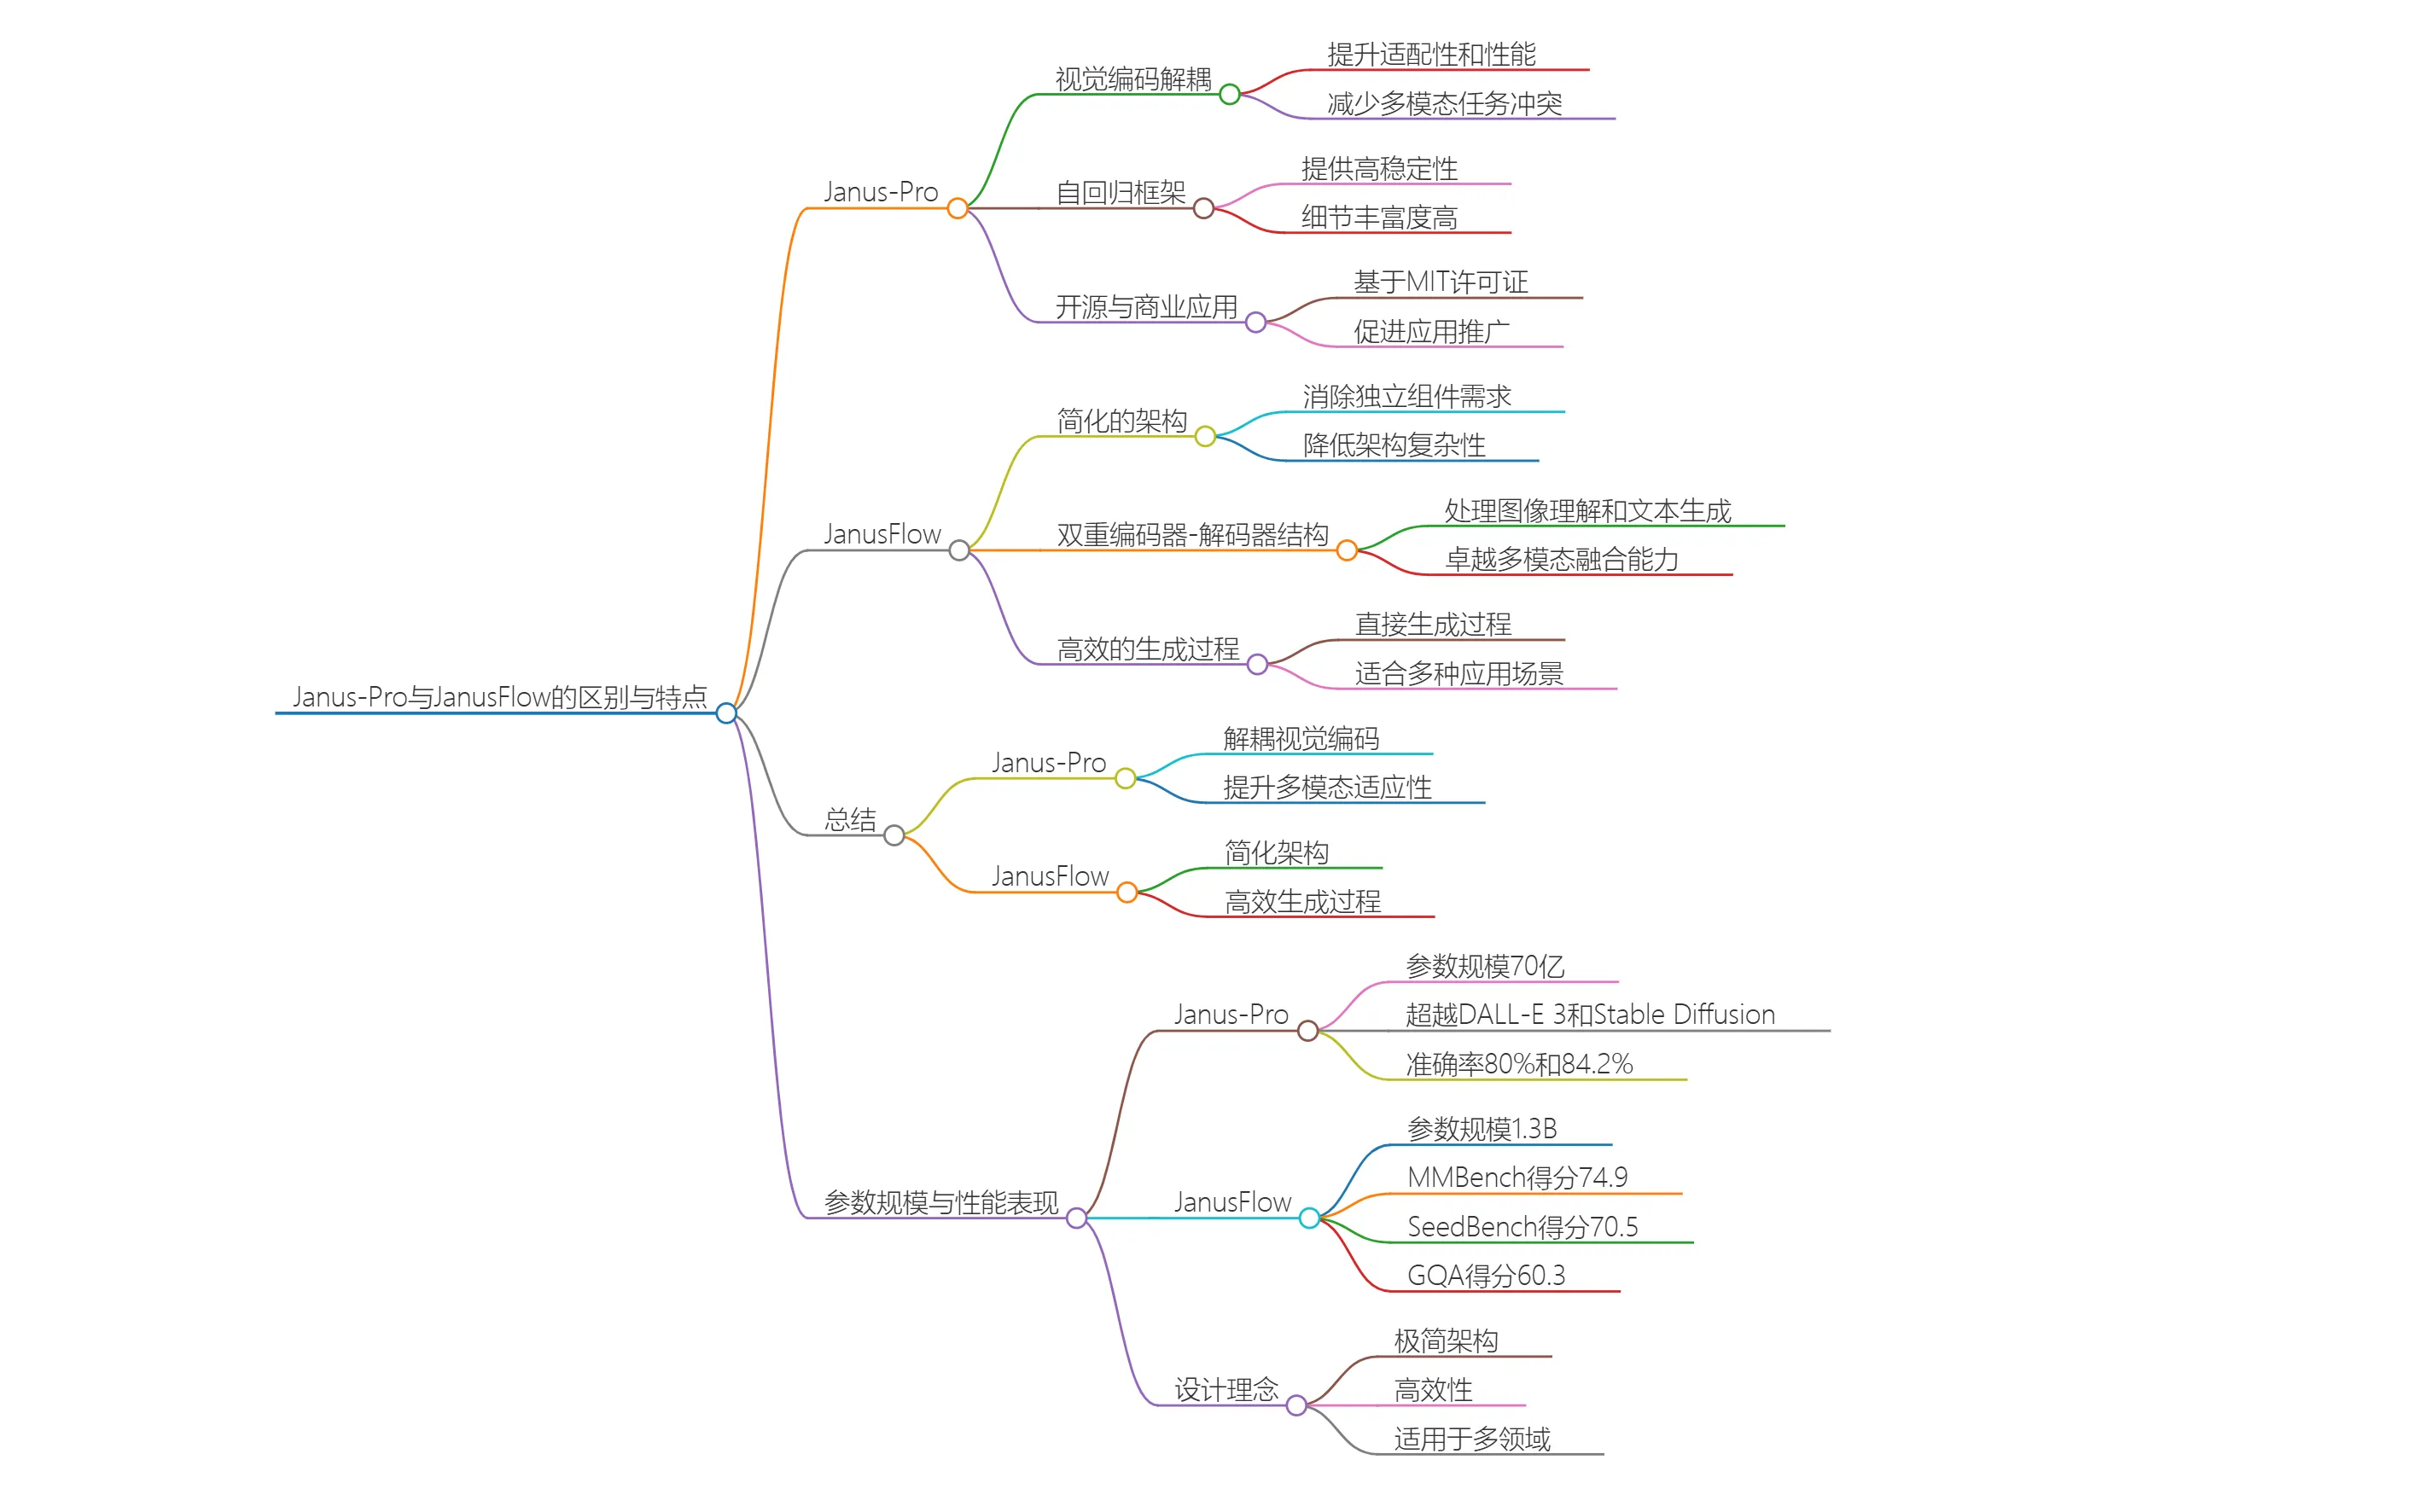
Janus-Pro y JanusFlow son dos modelos multimodales de DeepSeek , aunque ambos se centran en tareas de comprensión y generación de imágenes, presentan diferencias bastante evidentes en cuanto a arquitectura técnica, filosofía de diseño y escenarios de aplicación. A continuación te presentamos sus diferencias:
1. Arquitectura técnica
Janus-Pro:
Adopta una tecnología de codificación visual desacoplada, dividiendo el proceso de codificación visual en rutas independientes para gestionar por separado las tareas de comprensión y generación multimodal, lo que resuelve el conflicto funcional del codificador visual en ambos tipos de tareas en los modelos tradicionales.
Se basa en una arquitectura Transformer unificada, lo que simplifica el diseño del modelo y mejora la capacidad de escalado.
Utiliza SigLIP-L como codificador visual, admite entradas de imagen con resolución de 384x384 y emplea LlamaGen Tokenizer para la generación de imágenes.
JanusFlow:
Fusiona el flujo generativo (Rectified Flow) con un modelo de lenguaje autorregresivo, logrando un marco multimodal minimalista pero potente que permite generar imágenes de alta calidad sin complejas modificaciones.
También utiliza SigLIP-L como codificador visual y se basa en SDXL-VAE para la generación de imágenes, ofreciendo mayor nivel de detalle.
2. Filosofía de diseño
Janus-Pro:
Hace hincapié en la flexibilidad y la eficiencia. Mediante la codificación visual desacoplada, mejora la adaptabilidad del modelo en distintas tareas, siendo adecuado para escenarios multimodales como respuesta a preguntas visuales y anotación de imágenes.
Su objetivo es convertirse en un marco multimodal unificado, capaz tanto de comprender el contenido de las imágenes como de generar imágenes de alta calidad.
JanusFlow:
Prioriza una arquitectura minimalista y una alta escalabilidad. Al fusionar el flujo generativo con el modelo de lenguaje, simplifica el proceso de modelado multimodal, lo que lo hace adecuado para aplicaciones a gran escala.
Está pensado para ofrecer a investigadores y desarrolladores una solución multimodal eficiente y flexible que soporte la ampliación a múltiples tareas.
3. Rendimiento
Janus-Pro:
En los benchmarks GenEval y DPG-Bench, Janus-Pro-7B alcanza una precisión del 80% y del 84,2% respectivamente, superando a DALL-E 3 de OpenAI y a Stable Diffusion47.
Ofrece un rendimiento excelente en tareas de comprensión multimodal, igualando o incluso superando a modelos específicos para cada tarea.
JanusFlow:
Muestra un rendimiento destacado en tareas de generación de imágenes, con una alta calidad de generación y adaptado a una resolución de 384x384.
En tareas de comprensión como respuesta a preguntas visuales y anotación de imágenes, su rendimiento es comparable o incluso superior al de los modelos específicos.
4. Escenarios de aplicación
Janus-Pro:
Es adecuado para escenarios que requieren generación de imágenes de alta calidad y comprensión multimodal, como diseño publicitario, desarrollo de videojuegos y creación artística.
Resulta apropiado para usuarios que necesitan una adaptación flexible a múltiples tareas, como investigadores y desarrolladores empresariales.
JanusFlow:
Es más adecuado para aplicaciones a gran escala y ampliación a múltiples tareas, como asistentes inteligentes y realidad virtual, escenarios que requieren generación y comprensión eficientes.
Gracias a su arquitectura minimalista, es ideal para usuarios con recursos limitados que necesitan modelos de alto rendimiento.
5. Código abierto e implementación
Ambos modelos son de código abierto y se rigen por la licencia MIT. Los desarrolladores pueden acceder al código y a los pesos del modelo a través de GitHub.
Janus-Pro y JanusFlow tienen enfoques distintos en cuanto a arquitectura técnica, filosofía de diseño y escenarios de aplicación:
Janus-Pro, mediante la codificación visual desacoplada y una arquitectura Transformer unificada, logra una comprensión y generación multimodal eficiente, siendo adecuado para escenarios que requieren generación de imágenes de alta calidad y adaptación flexible a distintas tareas.
Por su parte, JanusFlow, gracias a la fusión del flujo generativo con el modelo de lenguaje, ofrece un marco multimodal minimalista pero potente, ideal para aplicaciones a gran escala y ampliación a múltiples tareas.
La publicación de ambos modelos supone nuevos avances en el campo de la IA multimodal. Los usuarios pueden elegir el modelo más adecuado para su implementación y aplicación según sus necesidades específicas.









