
 Asistente de guiones▸
 Apps AI
 Noticias AI
Seed-ASR: modelo de reconocimiento automático de voz de ByteDance

Seed-ASR: modelo de reconocimiento automático de voz de ByteDance
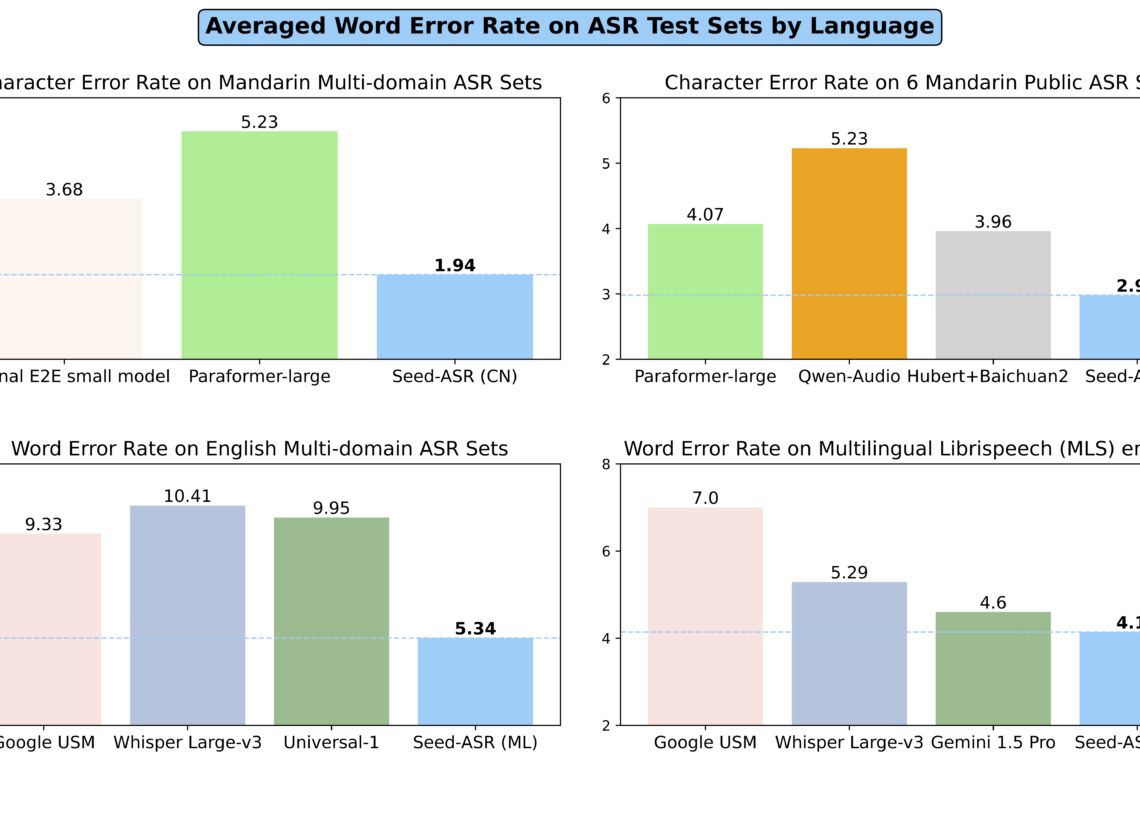
Seed-ASR, 字节跳动 modelo de reconocimiento automático de voz, capaz de convertir diversas voces en información de texto. A diferencia de los TTS tradicionales orientados a una sola tarea, Seed-TTS puede modelar una amplia variedad de voces y permite su manipulación simultánea desde múltiples dimensiones, reconociendo diferentes idiomas, dialectos, acentos e incluso imperfecciones en la voz como palabras tragadas.Seed-ASR ha sido entrenado con más de 20 millones de horas de datos de voz y cerca de 900 000 horas de datos ASR emparejados.No solo admite mandarín, sino que también reconoce 13 dialectos chinos, 7 idiomas extranjeros y diversos acentos del inglés.
Seed-ASR cuenta con una sólida capacidad de conciencia contextual, lo que le permite reconocer el contenido de voz en contextos específicos. Por ejemplo, el modelo puede aprovechar conversaciones históricas o actas de reuniones para reconocer con mayor precisión nombres de personas, lugares u otras palabras clave contextualmente relevantes en la voz actual.
Seed-ASR ofrece una gran escalabilidad. Esto significa que no se trata únicamente de un sistema fijo, sino de una plataforma que se puede personalizar según necesidades concretas. Por ejemplo, si deseas que se especialice en reconocer terminología médica o en entender un acento particular, se puede lograr mediante ajuste fino.
La tecnología más esencial de Seed-ASR es la integración de modelos de lenguaje de gran tamaño en el reconocimiento de voz, lo que aporta a Seed-ASR capacidad de comprensión contextual. Esto no consiste simplemente en unir dos sistemas, sino que cambia fundamentalmente la forma de procesar la voz. Es como dotar al sistema de reconocimiento de voz de un supercerebro que no solo escucha, sino que también piensa.
Aspectos tecnológicos destacados de Seed-ASR:
Reconocimiento de alta precisión: procesa entradas de voz complejas mediante un modelo con miles de millones de parámetros, logrando una识别 de alta precisión.
Modelo de gran capacidad: utiliza un modelo de lenguaje de gran tamaño, lo que mejora la precisión del reconocimiento de voz y la capacidad de comprensión contextual; es como si una "supercomputadora" te ayudara a transcribir tus notas, algo verdaderamente impresionante.
Soporte multilingüe: incluye mandarín, 13 dialectos chinos y múltiples idiomas extranjeros, con planes de ampliarse a más de 40 idiomas.
Conciencia contextual: capaz de combinar información contextual para mejorar la precisión del reconocimiento, como cuando conversas con un amigo y entiende lo que han dicho antes, utilizando esa información para comprender mejor lo que dices ahora.
Método de entrenamiento por etapas: incluye aprendizaje autosupervisado, ajuste fino supervisado, ajuste fino contextual y aprendizaje por refuerzo, fortaleciendo progresivamente las capacidades del modelo.
Escenarios de aplicación de Seed-ASR:
Interacción hombre-máquina: ofrece un canal de entrada de voz, convirtiendo la voz en texto en tiempo real como entrada, con el fin de lograr una interacción rápida y cómoda con dispositivos, hardware y aplicaciones.
Moderación de contenido: convierte grabaciones en texto y analiza dicho texto mediante reglas de control de calidad, detectando a tiempo contenido infractor y tomando medidas para intervenir.
Transcripción de reuniones y entrevistas: convierte el audio de reuniones y entrevistas en texto en tiempo real o de forma asíncrona, segmentando automáticamente las partes con voz para reconocer, reduciendo costos y aumentando la eficiencia.
Subtítulos de audio y vídeo: admite la conversión automática de la voz y letras en audio y vídeo en texto, generando subtítulos correspondientes al audio y vídeo con un solo clic.
Seed-ASR ya se ha implementado en la aplicación Doubao, donde los usuarios lo han empleado en escenarios como conversaciones en inglés, compañeros de chat virtuales y réplica de la voz de familiares y amigos. Orientado a más clientes empresariales, Seed-ASR, respaldado por Volcengine, también tiene aplicaciones en interacción por voz, moderación de contenido, transcripción de reuniones y entrevistas, y subtítulos de audio y vídeo.
Hasta la fecha, el equipo del modelo Doubao en la dirección de voz ha publicado múltiples成果 técnicos como Seed-TTS y Seed-ASR.
Sitio web oficial de Seed-ASR:https://bytedancespeech.github.io/seedasr_tech_report/









