
 Asistente de guiones▸
 Apps AI
 Noticias AI
Seed-TTS: modelo de texto a voz de alta calidad desarrollado por ByteDance
小编 ·

Seed-TTS: modelo de texto a voz de alta calidad desarrollado por ByteDance
Recientemente, el campo de los TTS ha experimentado un gran avance. Justo después de que se publicara como código abierto chatTTS, Byte lanzó seed-tts, con resultados excelentes.
Seed-TTS es un modelo de texto a voz (TTS) de alta calidad desarrollado por ByteDance. El modelo Seed-TTS es capaz de generar voz casi indistinguible de la voz humana.
Como modelo base para la generación de voz, Seed-TTS destaca en el aprendizaje en contexto de voz, y su rendimiento en similitud y naturalidad del hablante coincide con el de la voz humana real tanto en evaluaciones objetivas como subjetivas.
Seed-TTS, sin necesidad de entrenamiento, solo necesita un breve fragmento de voz para clonar y generar una voz muy natural y expresiva, capaz de realizar tareas como leer novelas o doblaje.
Seed-TTS también ofrece capacidades avanzadas de control sobre diversas propiedades de la voz, incluyendo, entre otras, emoción, entonación, estilo de habla, etc., y permite editar la voz generada mediante la edición del texto.
Seed-TTS puede modificar el contenido del audio manteniendo不变 el timbre, el tono y la emoción.
Seed-TTS permite ajustar la velocidad del habla, controlando libremente la velocidad del audio.
Seed-TTS ofrece un control excepcional sobre diversas propiedades de la voz (como la emoción) y es capaz de generar voces altamente expresivas y diversificadas para hablantes en entornos reales.
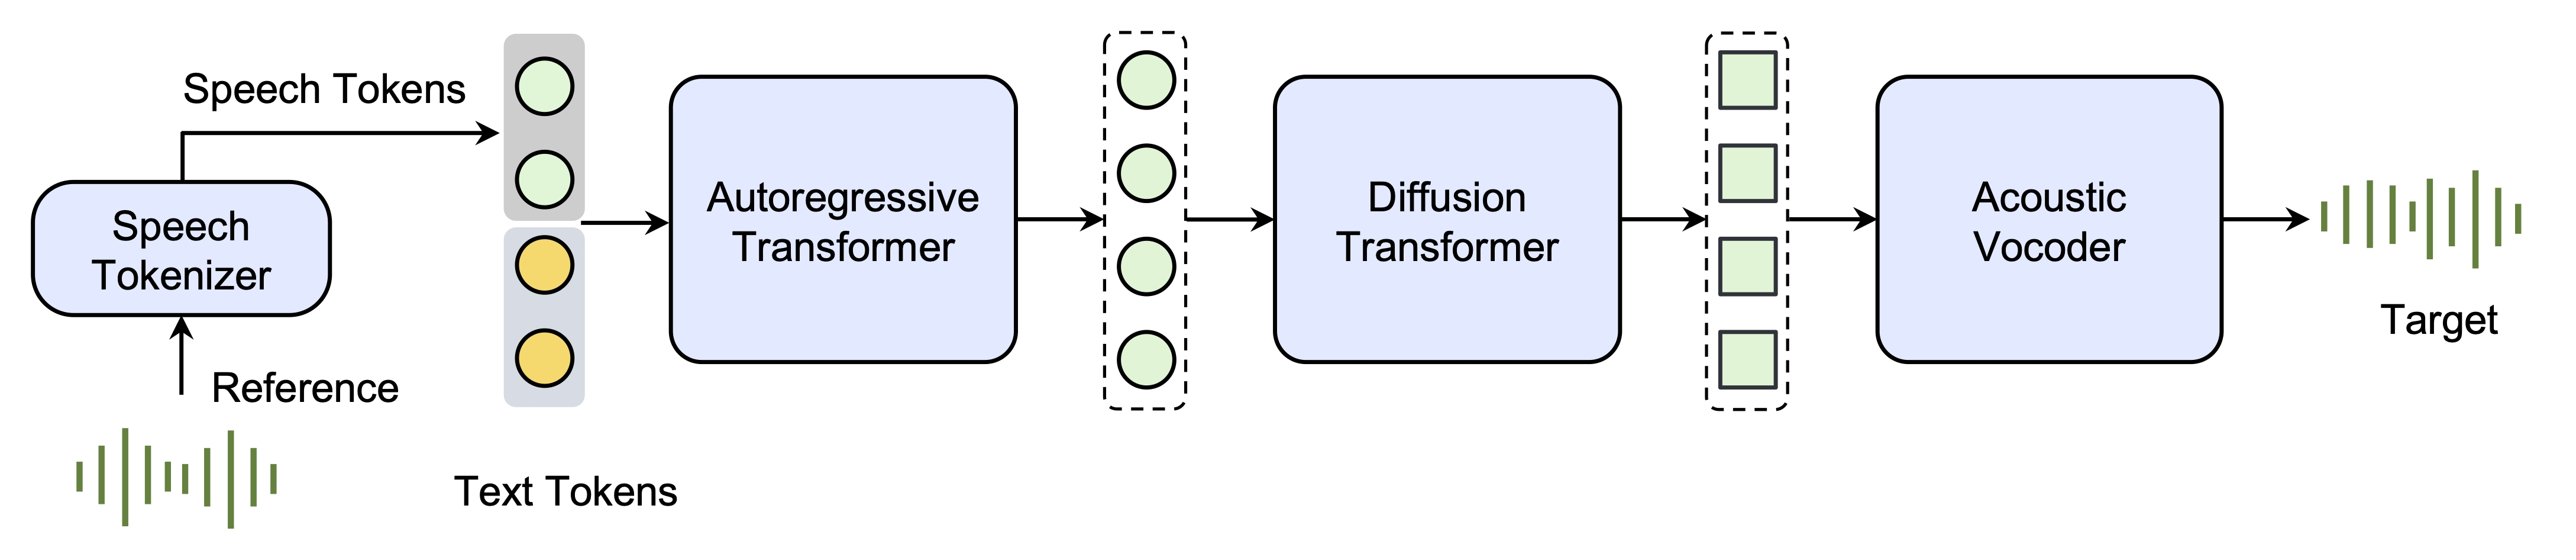
Además, proponemos un método de auto-destilación para la descomposición de la voz, así como un método de aprendizaje por refuerzo para mejorar la robustez, la similitud del hablante y la controlabilidad del modelo. También presentamos una variante no autorregresiva (NAR) del modelo Seed-TTS, llamada Seed-TTS DiT, que adopta una arquitectura completamente basada en difusión. A diferencia de los sistemas TTS basados en NAR anteriores, Seed-TTS DiT no depende de la duración fonémica estimada previamente y realiza la generación de voz de extremo a extremo. Demostramos que esta variante alcanza un rendimiento comparable al de la variante basada en modelos de lenguaje tanto en evaluaciones objetivas como subjetivas, y mostramos su eficacia en la edición de voz.
Paper: https://arxiv.org/abs/2406.02430









