
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Wanliang Engine: Ein One-Stop-Gateway für nahezu alle großen KI-Modell-APIs
Wanliang Engine: Ein One-Stop-Gateway für nahezu alle großen KI-Modell-APIsEinführung
Was ist die Million Engine
Die Million Engine (Wanliang Engine) ist ein Multi-Modell-Aggregations-Gateway für KI-Anwendungen und Agent-Entwickler. Sie hilft Entwicklern in China in erster Linie dabei, die Probleme mit Netzwerklatenz, Kontosperrungen und Beschränkungen bei hoher Parallelität zu lösen, die beim Aufruf von Übersee-Large-Model-APIs auftreten.
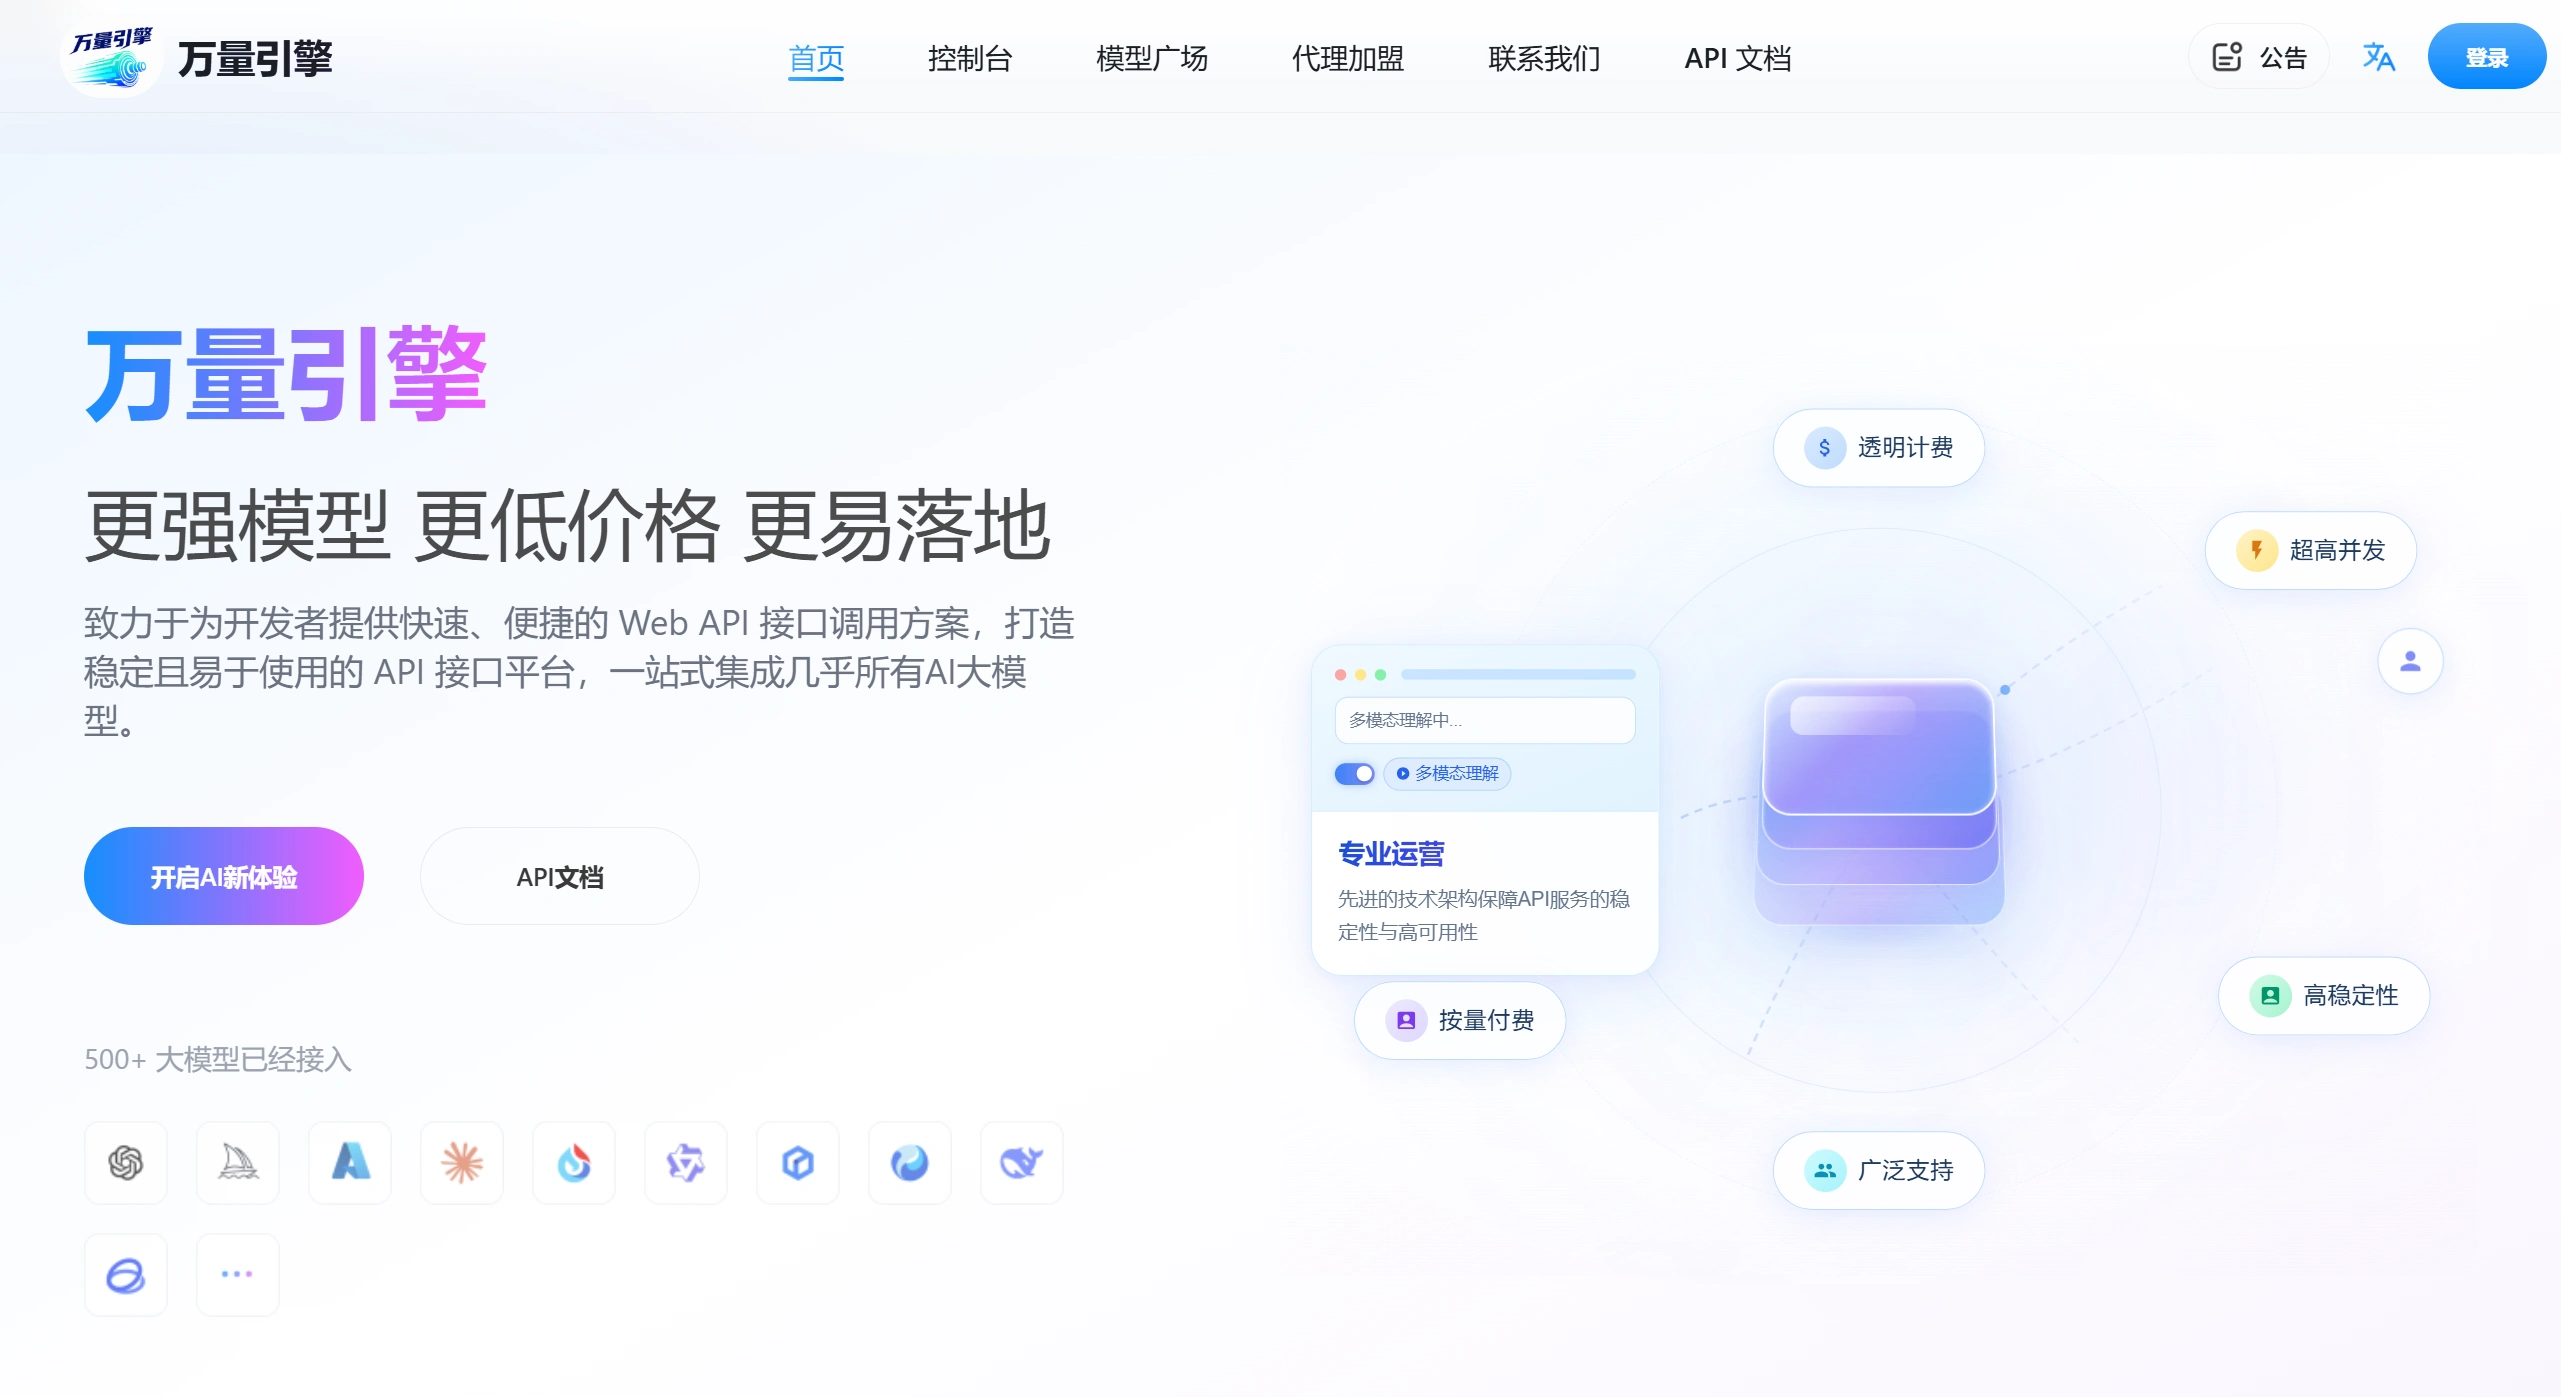
Funktionsmerkmale
Einheitlicher Zugriff auf mehrere Modelle: Mit einem einzigen API-Schlüssel können über 500 gängige Modelle wie GPT-4o, Claude 3, Gemini und Gemma 4 aufgerufen werden
Kompatibel mit dem OpenAI SDK: Durch einfaches Ändern der base_url können bestehende Projekte direkt migriert werden, nahezu ohne Codeänderungen
Hochgeschwindigkeits-Grenzüberschreitungs-Leitung: Nutzt unternehmensgerechte Kanäle mit globalen Edge-Node-Bereitstellungen und einer durchschnittlichen Latenz von etwa 0,5 Sekunden
Stabilität bei hoher Parallelität: Unterstützt 100+ QPS, stabile Verbindung ohne Abbrüche, intelligenter Lastausgleich mit automatischem Retry, Fehlerrate nahe 0 %
Anti-Sperr-Mechanismus: Es werden intern zahlreiche API-Schlüssel vorgehalten, um zu vermeiden, dass einzelne Konten eingeschränkt oder gesperrt werden
Flexible Abrechnung: Pay-as-you-go, keine Probleme mit ablaufenden Paketen, der Preis ist vergleichbar mit dem offiziellen Angebot, aber günstiger
Volle Funktionsunterstützung: Streaming-Ausgabe, Batch-Anfragen, Funktionsaufrufe, Midjourney-Bildgenerierung usw. werden unterstützt
Anwendungsszenarien
Entwicklung von KI-Anwendungen: Schnelle Erstellung von Chat-Bots, Schreibassistenten, Code-Generierungstools usw.
Unternehmensweite KI-Integration: Anbindung von KI an interne Systeme, z. B. Kundenservice, Dokumentenverarbeitung, Datenanalyse
Geschäftsprozesse mit hoher Parallelität: Szenarien, die viele Aufrufe erfordern, wie z. B. Analyse von E-Commerce-Bewertungen oder Massengenerierung von Inhalten
Streaming-Dialog-Anwendungen: Entwicklung von Echtzeit-Interaktionsprodukten für Web oder mobile KI-Dialoge
Koordinierte Multi-Model-Steuerung: Automatische Auswahl des am besten geeigneten Modells je nach Aufgabe, z. B. GPT-4o für komplexes Reasoning, Claude für lange Texte
Vor- und Nachteile der Million Engine
Vorteile:
Schneller Zugriff aus China, 70 % geringere Latenz im Vergleich zu selbst aufgebautem Nginx
Hohe Stabilität, Verfügbarkeit über 99,9 %
Einfache Integration, in 3 Minuten eingerichtet
Geringere Kosten als selbst aufgebaute Lösungen, keine eigenen Server und kein eigener Betrieb nötig
7x24-Stunden-technischer Support
Nachteile:
Abhängigkeit von einem Drittanbieter-Dienst, gewisses Risiko eines Vendor Lock-in
Sehr große Unternehmen benötigen möglicherweise maßgeschneiderte Lösungen
Einige Spezialmodelle haben eigene Zuordnungsnamen, daher sollte vor der Integration die Dokumentation geprüft werden
Wie man die Million Engine nutzt
Konto registrieren: Besuchen Sie millionengine.com und erhalten Sie nach der Registrierung einen API-Schlüssel
Konfiguration ändern: Ändern Sie die base_url des OpenAI SDK auf https://millionengine.com/v1
Schlüssel austauschen: Ersetzen Sie den ursprünglichen Schlüssel durch den von der Million Engine bereitgestellten
Modell aufrufen: Rufen Sie das Modell einfach im standardmäßigen OpenAI-Schnittstellenformat auf
Nutzung überwachen: Im Backend-Dashboard kann der Token-Verbrauch in Echtzeit eingesehen werden
Häufig gestellte Fragen
F: Was ist der Unterschied zur offiziellen API?
A: Das Schnittstellenformat ist identisch, aber es werden optimierte Leitungen in China genutzt, wodurch Geschwindigkeit und Stabilität besser sind
F: Wird Streaming-Ausgabe unterstützt?
A: Ja, das Erlebnis entspricht dem offiziellen
F: Was kann man tun, wenn die Generierung langer Texte abbricht?
A: Es wird empfohlen, das SDK-Timeout auf 60–120 Sekunden einzustellen
F: Wie erfolgt die Abrechnung?
A: Die Abrechnung erfolgt nach tatsächlichem Token-Verbrauch, der Preis entspricht dem offiziellen, ohne versteckte Kosten
Bewertung
Die Million Engine positioniert sich als produktionsreife Basis für KI-Anwendungen, die es Entwicklern ermöglicht, sich ohne Sorgen um die Infrastruktur auf das Kerngeschäft zu konzentrieren. Für chinesische KI-Entwickler löst sie das Netzwerkschmerzpunkt beim Zugriff auf Übersee-Modelle und bietet sofort einsetzbare, unternehmensgerechte Stabilität. Im Vergleich zu selbst aufgebauten Proxies oder anderen Weiterleitungslösungen bietet sie deutliche Vorteile bei Latenz, Stabilität und Kostenkontrolle. Geeignet für verschiedene KI-Anwendungsszenarien, vom einzelnen Entwickler bis zum mittelständischen Unternehmen.















