
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten

DreamBooth: Personalisierte Text-zu-Bild-Technologie
DreamBooth: Personalisierte Text-zu-Bild-TechnologieEinführung
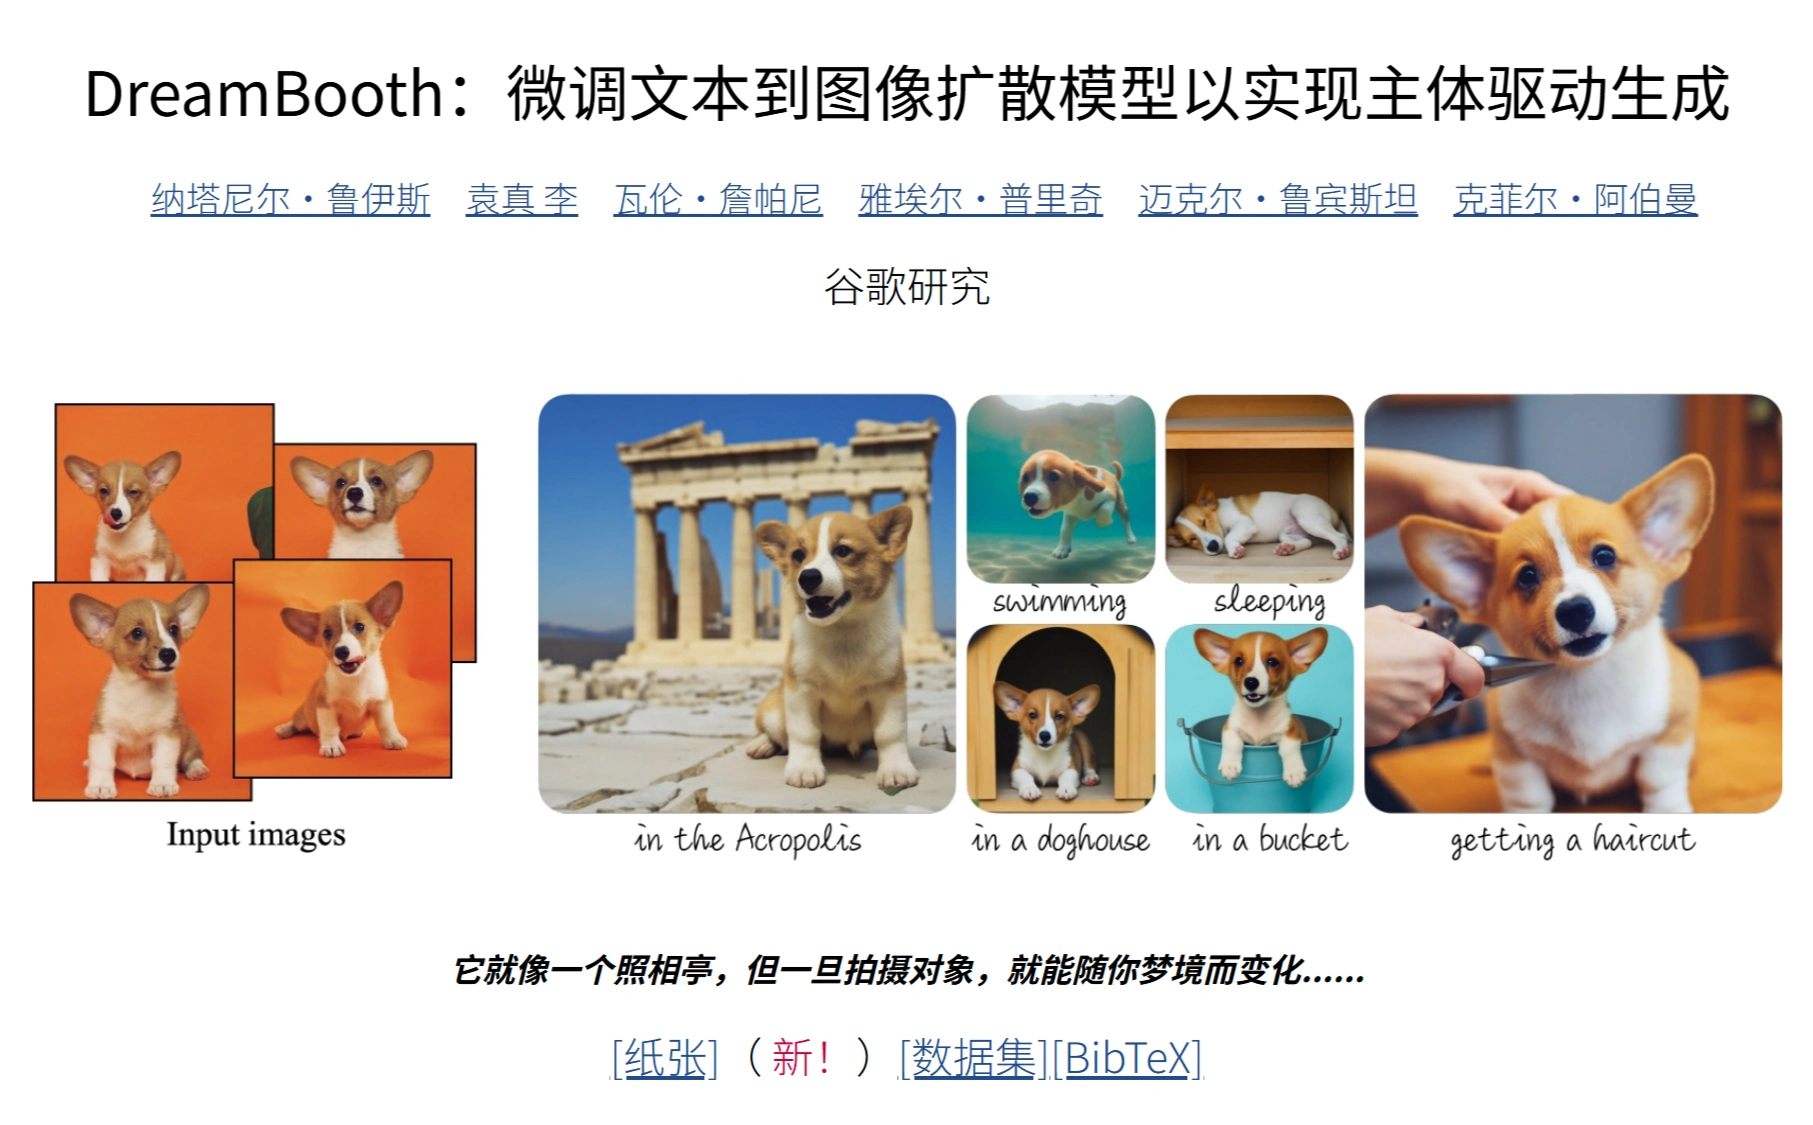
DreamBooth ist eine personalisierte Text-zu-Bild-Technik, die 2022 von Google Research und der Boston University entwickelt wurde. Ziel ist es, mit sehr wenigen Beispielen einem vortrainierten Diffusionsmodell beizubringen, ein bestimmtes Objekt – etwa eine Person, ein Haustier, einen Gegenstand oder einen bestimmten Stil – zu erkennen, damit dieses anschließend in verschiedensten Szenen und Stilen hochauflösend generiert werden kann. Ursprünglich wurde sie in Verbindung mit Googles Imagen vorgestellt, wurde später aber auch für Modelle wie StableDiffusion übernommen und ist heute eine gängige Methode für personalisierte Generierung.
Wie DreamBooth funktioniert
Feintuning mit sehr wenigen Bildern. In der Regel reichen 3–5 Bilder des Objekts, kombiniert mit Textprompts im Format „eindeutiges Wort + Klassenname“, z. B. „aphotoof[V]dog“, um das neue Objekt in der Semantik des Modells zu verankern.
Während des Trainings wird ein klassenspezifischer Prior-Erhaltungsverlust hinzugefügt, damit das Modell die Vielfalt der ursprünglichen Klasse beibehält. So wird Überanpassung oder Language Drift vermieden, und das Objekt kann in unterschiedlichen Szenen verschieden dargestellt werden.
Anschließend ein Super-Resolution-Feintuning. Zunächst werden Bilder mit niedriger Auflösung erzeugt, dann mit einem SR-Modell schrittweise hochskaliert – üblich ist 64×64→256×256→1024×1024 –, um Details und Texturen realistischer zu machen.
Schritte zur Nutzung von DreamBooth
Suche zunächst 3–5 hochauflösende Bilder des Objekts, idealerweise aus verschiedenen Blickwinkeln.
Gib dem Objekt einen seltenen Bezeichner und verfasse eine einfache Klassenbeschreibung, z. B. aphotofosksdog.
Wähle eine passende Lernrate und einen Referenzbildsatz und starte das Feintuning. Auf einer einzelnen GPU werden 8–24 GB VRAM benötigt, die Trainingszeit beträgt 1–2 Stunden.
Nach dem Training genügt ein Prompt wie sksdogwearingspacesuitonMars, um ein Bild deines Corgis auf dem Mars zu erhalten.
Hauptmerkmale von DreamBooth
Schon mit wenigen Beispielen lässt sich die Ausgabe deutlich verändern.
Lässt sich in verschiedene Text-zu-Bild-Diffusionsmodelle integrieren, z. B. StableDiffusion.
Die Community bietet fertige Gewichte, Colab-Tutorials und diverse Tools mit Oberfläche – der Einstieg und die Nutzung sind einfach.
Vorteile und Probleme von DreamBooth
Vorteile:
Es genügen wenige Bilder, es werden keine gepaarten Text-Bild-Daten benötigt.
Erfasst individuelle Details wie Muster, Gesichtszüge oder Produktlogos.
Hohe Generierungsqualität, die durch die reichhaltigen Informationen von StableDiffusion sehr realistische Details liefert.
Probleme:
Hoher VRAM-Bedarf: Für ein vollständiges Feintuning sind 15–24 GB nötig, mit LoRA lässt sich dies auf 8–12 GB reduzieren.
Anfällig für Überanpassung. Wird dies nicht kontrolliert, erkennt das Modell möglicherweise nur das Trainingsobjekt, und die Generierung anderer Objekte derselben Klasse wird verzerrt.
Langsameres Training als LoRA: LoRA benötigt nur 30–60 Minuten, während ein vollständiges DreamBooth-Feintuning 1–2 Stunden dauert.
Typische Einsatzszenarien für DreamBooth
Erstellung virtueller Avatare für Personen oder Haustiere, um sich selbst oder Katze/Hund in Spiel- oder Filmszenen zu platzieren.
Erstellung individueller Produktbilder: Nach dem Hochladen von Produktfotos lassen sich in einem Durchgang Werbebilder in verschiedenen Stilen erzeugen.
Character Design: Film- oder Spielestudios können schnell unterschiedliche Posen und Beleuchtungen derselben Figur erstellen.
Hinweise
Das Training ist sehr VRAM-hungrig und auf normalen Grafikkarten möglicherweise teuer. Cloud-GPUs oder Optimierungsverfahren können Kosten sparen.
Am besten verwendest du 3–10 Bilder, aus mehreren Blickwinkeln, mit unterschiedlichen Hintergründen und möglichst scharf – so sind die Ergebnisse stabiler und ähnlicher.
Kurz gesagt: DreamBooth ermöglicht es einem großen Modell, sich ein einzelnes Individuum zu merken. Es ist eine repräsentative Methode für personalisierte Bildgenerierung im Bereich aiGC und eignet sich gut für den Einsatz im Anime-Bereich.













