
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Step-Video-T2V: fortschrittliches Text-zu-Video-Generierungsmodell
Step-Video-T2V: fortschrittliches Text-zu-Video-GenerierungsmodellEinführung
Step-Video-T2V ist ein fortschrittliches Text-zu-Video-Generierungsmodell, das in Zusammenarbeit zwischen StepFun und Geely Auto Open-Source veröffentlicht wurde. Es verfügt über zahlreiche herausragende Eigenschaften und zeigt eine starke Leistung im Bereich der Video-Generierung.
Highlights des Step-Video-T2V-Modells
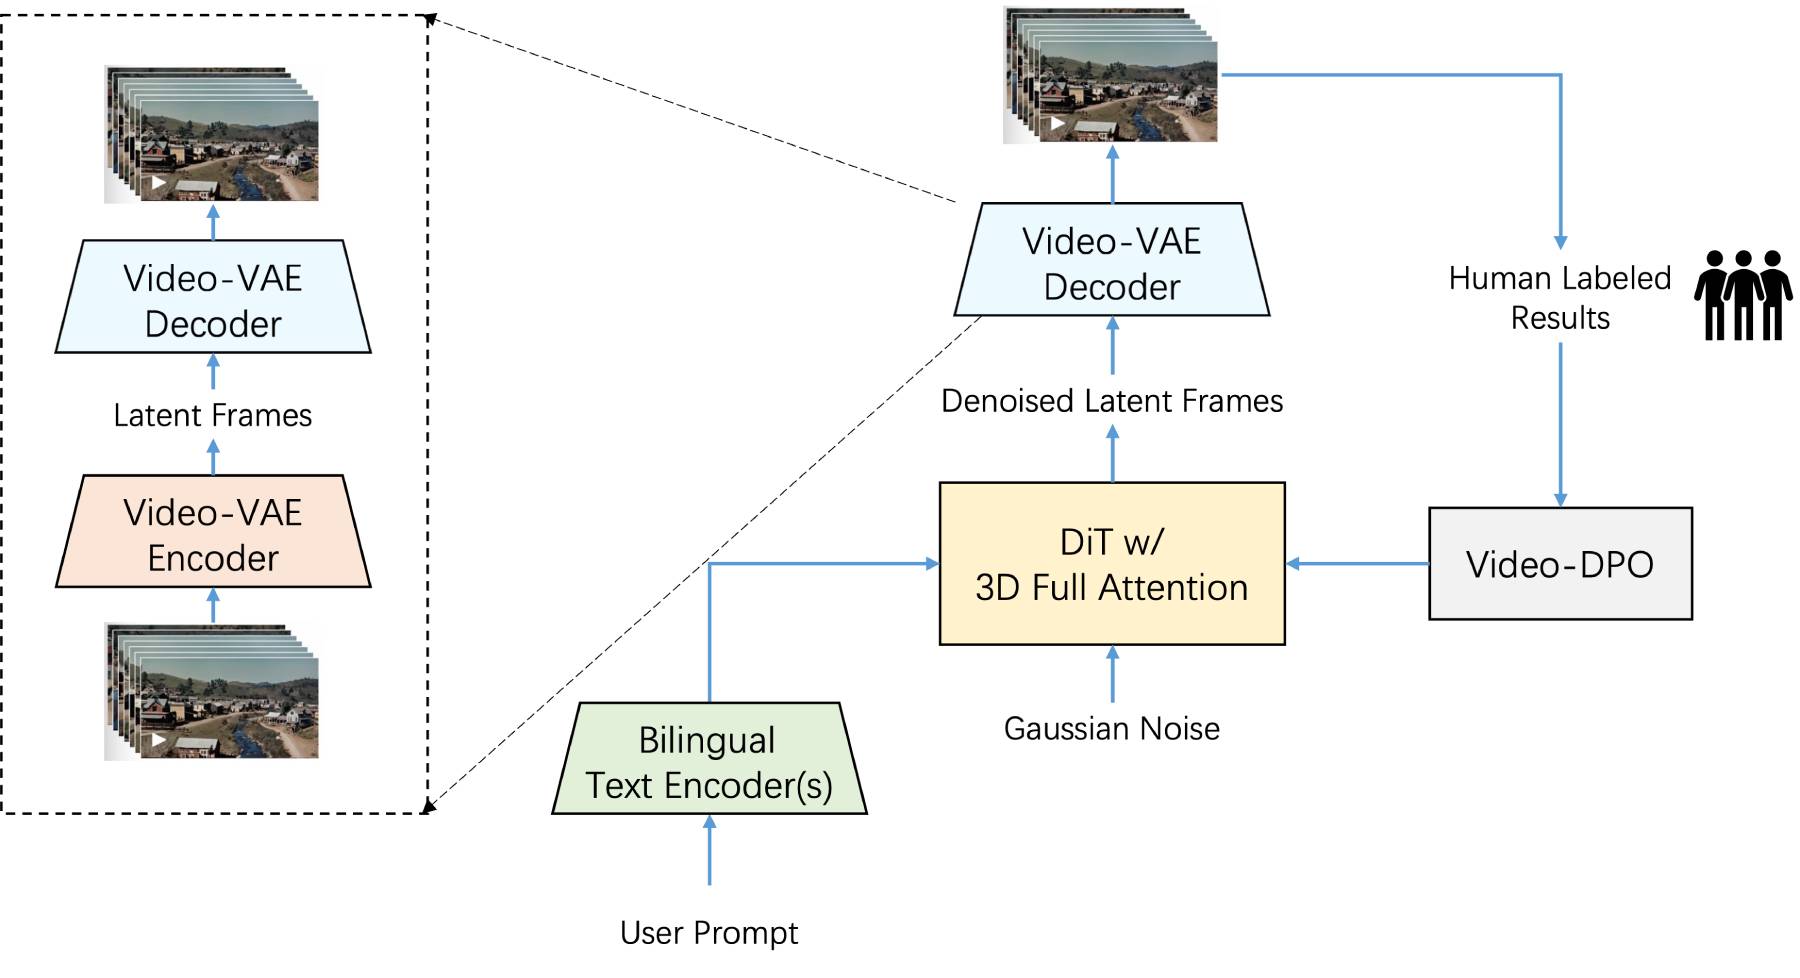
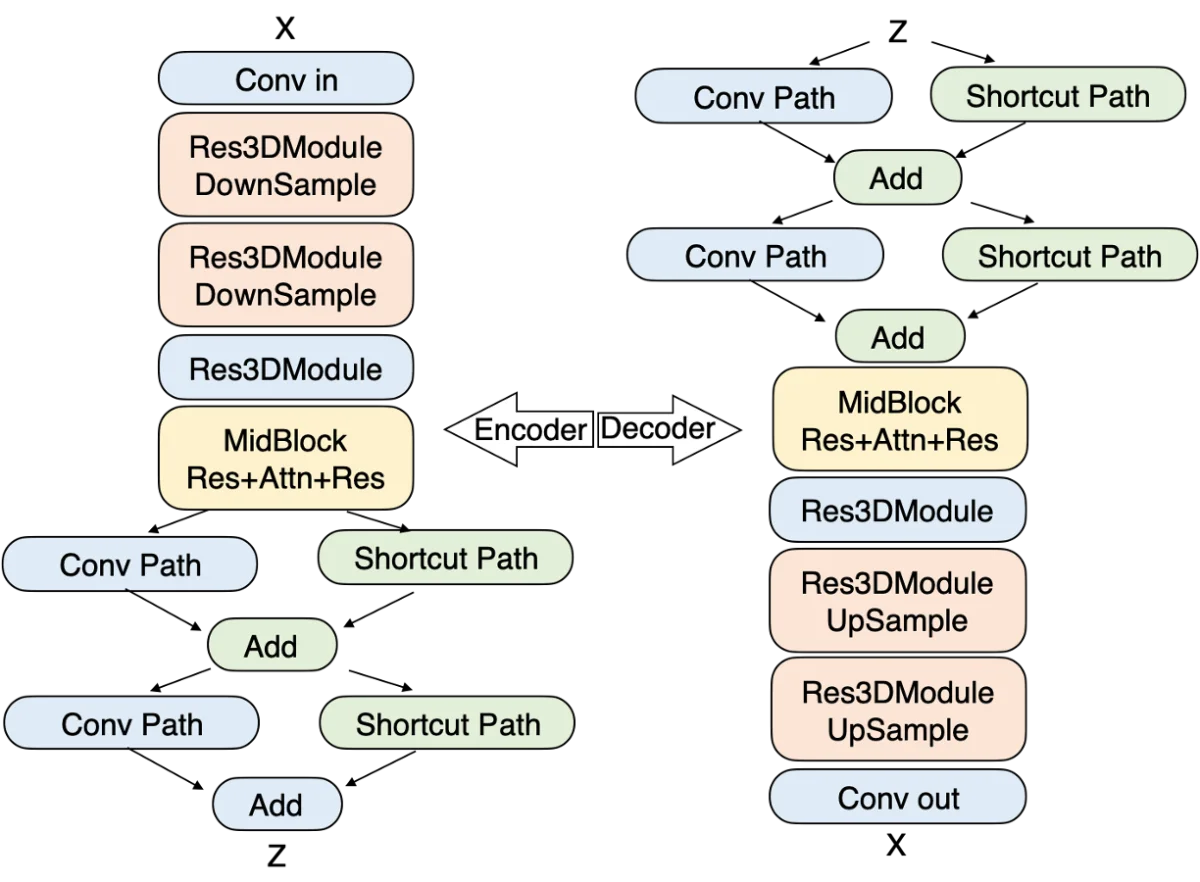
Es verwendet das DiT-Modell und das Flow-Matching-Trainingsverfahren und erreicht eine räumliche Komprimierung von 16×16 sowie eine zeitliche Komprimierung von 8×, was die Effizienz der großskaligen Video-Generierung erheblich steigert.
Mit einer enormen Parameteranzahl von 30 Milliarden kann es hochwertige Videos mit einer Auflösung von bis zu 544x992 generieren.
Es unterstützt die Eingabe von Prompts in Chinesisch und Englisch und ist somit für Benutzer mit unterschiedlichem sprachlichen Hintergrund benutzerfreundlich.
Funktionsmerkmale von Step-Video-T2V
Großskalige Parameter: Mit einer Parameteranzahl von bis zu 30 Milliarden verfügt das Modell über eine äußerst hohe Generierungsfähigkeit und Genauigkeit, sodass es Textbeschreibungen präziser verstehen und in hochwertige Videos umwandeln kann.
Effiziente Video-Generierung: Es unterstützt die Generierung von hochwertigen Videos mit bis zu 204 Frames (544x992 Pixel) und erfüllt damit vielfältige kreative Anforderungen. Durch den Einsatz eines tiefenkomprimierten Variational Autoencoders (Video-VAE) wird eine räumliche Komprimierung von 16×16 und eine zeitliche Komprimierung von 8× erreicht, wodurch die Trainings- und Inferenzkosten effektiv gesenkt werden, während die Videoqualität erhalten bleibt.
Zweisprachiger Text-Encoder: Es unterstützt chinesische und englische Eingaben, kann den Inhalt von Textbeschreibungen tiefgehend verstehen und entsprechende Videos generieren, sodass Benutzer unterschiedlicher Sprachen das Modell bequem nutzen können.
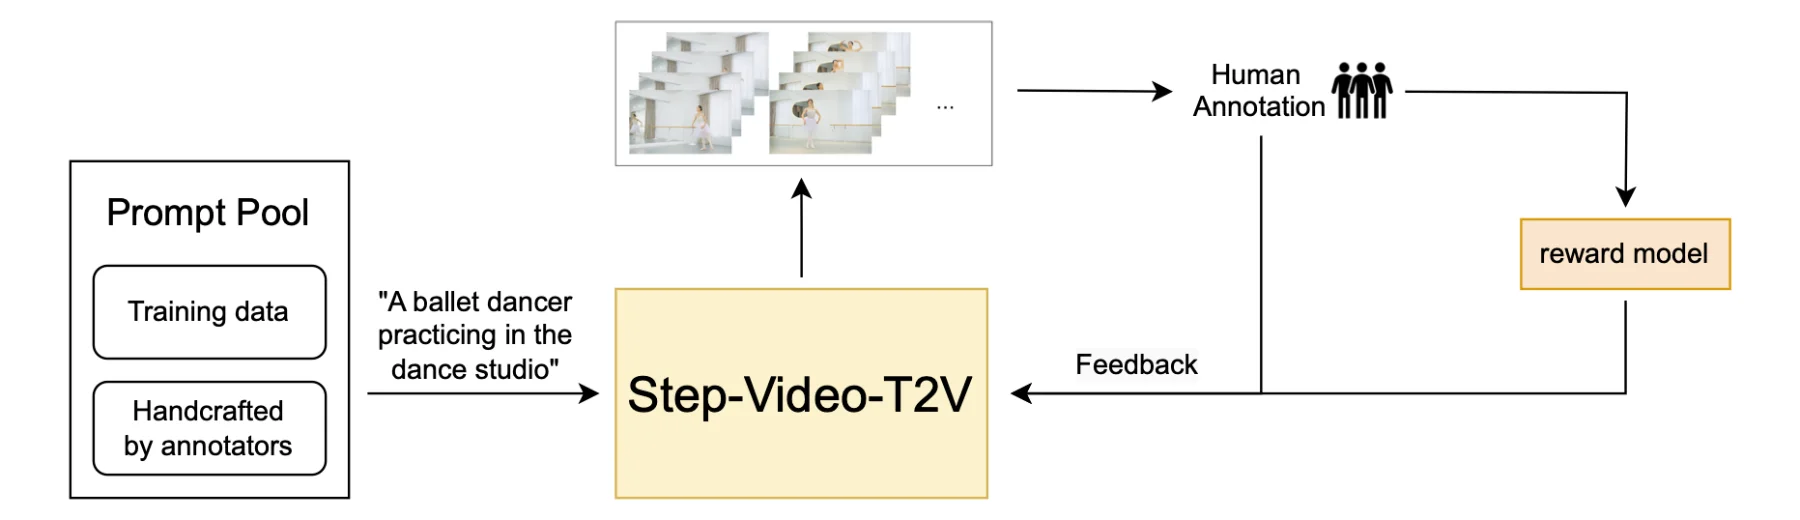
Fortschrittliche Architektur: Es verwendet eine 3D-Full-Attention-DiT-Architektur, die sich flexibel an dynamische Auflösungsänderungen anpasst und die Stabilität sowie hohe Qualität der Video-Generierung gewährleistet. Durch die Einführung der Video Preference Optimization (Direct Preference Optimization, DPO) über einen menschlichen Feedback-Mechanismus wird die Qualität und Glätte der generierten Videos weiter verbessert, sodass sie den Erwartungen der Benutzer besser entsprechen.
Multimodale Fusion: Durch die Kombination der Verständnisfähigkeiten von Bild-, Sprach- und Textmodalitäten sind die erzeugten Inhalte detailgetreuer. So werden beispielsweise die Gesichtsausdrücke der generierten Figuren lebendiger, Licht- und Schattenveränderungen natürlicher und die Darstellung dynamischer Objekte fließender und realistischer.
Flexible Betriebsmodi: Es bietet eine Basisversion (50 Generierungsschritte) und eine Turbo-Version (15-Schritte-Destillationsbeschleunigung), um den Leistungsanforderungen verschiedener Benutzer in unterschiedlichen Szenarien gerecht zu werden. In der Praxis benötigt die Generierung eines Videos mit 204 Frames etwa 4 GPUs mit 80 GB VRAM und dauert ungefähr 12 Minuten.
Anwendungsszenarien von Step-Video-T2V
Kreative Videoerstellung: Unterstützt Videoersteller bei der Generierung komplexer Szenen und detailreicher, kreativer Videoinhalte – ideal für Werbe- und Kurzvideo-Produktionen.
Animations- und Filmproduktion: In der Animations- und Filmbranche kann es zur Generierung hochwertiger virtueller Charaktere, dynamischer Szenen und komplexer Bewegungen eingesetzt werden.
Bildung und Training: Es ermöglicht die Erstellung interaktiver Lehrvideos, die den Unterricht lebendiger und ansprechender gestalten und die Beteiligung sowie den Lernerfolg der Schüler und Studenten steigern.
Unterhaltungsindustrie: Es kann automatisch Game-CGs, Film-Trailer und andere Unterhaltungsinhalte generieren und so viel Zeit und Personalkosten sparen.
Kulturelle Verbreitung: Besonders in der chinesischen Ästhetik zeigt es hervorragende Ergebnisse und kann Tuschemalereien, Szenen im klassischen chinesischen Stil und ähnliche Inhalte erzeugen. Dies trägt zur digitalen Verbreitung der traditionellen Kultur bei und verleiht ihr in der neuen Ära neue Vitalität.
Verwendung von Step-Video-T2V:
1. Abhängigkeiten installieren:
Installieren Sie die erforderlichen Python-Bibliotheken und Abhängigkeiten. Dies erfolgt in der Regel über pip oder andere Paketverwaltungs-Tools.
pip install transformers torch torchvision torchaudio
2. Umgebung konfigurieren:
Richten Sie die erforderliche Hardware-Umgebung ein. Empfohlen werden mindestens 4 NVIDIA-GPUs mit jeweils 80 GB VRAM.
Laden Sie die Modellgewichtedateien herunter und entpacken Sie sie in das angegebene Verzeichnis.
3. Modell laden:
Laden Sie das vortrainierte Step-Video-T2V-Modell mithilfe der Hugging Face Transformers-Bibliothek.
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "stepfun-ai/Step-Video-T2V"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
4. Video generieren:
Bereiten Sie den Text-Prompt vor und wandeln Sie ihn in ein für das Modell geeignetes Format um.
Führen Sie das Generierungsskript aus und warten Sie auf das Ergebnis.
input_text = "A red-haired woman performing on stage."
inputs = tokenizer(input_text, return_tensors="pt")
# Generate video frames (this is a simplified example; actual implementation may vary)
outputs = model.generate(**inputs, max_length=204)  # Adjust parameters as needed
# Save or display the generated video frames
5. Nachbearbeitung:
Führen Sie eine Nachbearbeitung der generierten Videoframes durch, z. B. das Zusammenfügen zu einem vollständigen Video oder das Hinzufügen von Audio.
Ressourcenzugriff:
GitHub-Repository: https://github.com/stepfun-ai/Step-Video-T2V
Hugging Face Demo: https://huggingface.co/stepfun-ai














