
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
StoryDiffusion: Erzeugung kohärenter Bild- und Videogeschichten sowie von Comics
StoryDiffusion: Erzeugung kohärenter Bild- und Videogeschichten sowie von ComicsEinführung
StoryDiffusion ist ein von dem HVision-Team der Nankai-Universität entwickeltes KI-Tool. Zu den Hauptfunktionen gehören die Erzeugung von konsistenten Bild- und Video-Geschichten sowie die Erstellung von Comics. StoryDiffusion nutzt die Consistent Self-Attention-Technologie und kann ohne Training thematisch konsistente Bilder erzeugen, die zum Erzählen von Geschichten oder als Eingabe für die nachfolgende Inhaltserzeugung verwendet werden können.
StoryDiffusion kann die Konsistenz von Charakteren wahren und mehrteilige Comics sowie lange Videos erzeugen, was besonders für Bereiche wie Werbung und Film wichtig ist, die eine zusammenhängende Erzählung benötigen.
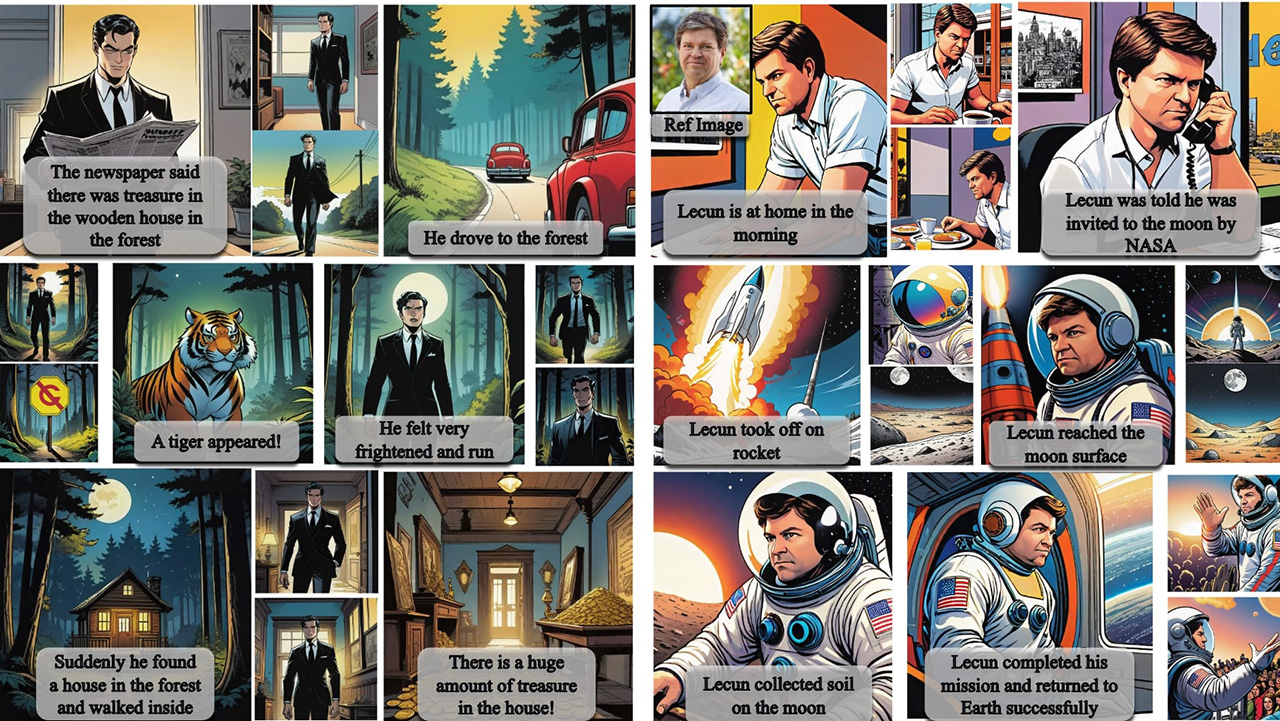
Hauptfunktionen und Merkmale von StoryDiffusion:
Konstanz der Charaktere: StoryDiffusion kann mithilfe des Consistent Self-Attention-Mechanismus thematisch konsistente Bilder und Videos erzeugen und sicherstellen, dass Charakterstil und Kleidung in mehrteiligen Comics und langen Videos einheitlich bleiben, um eine zusammenhängende Geschichte zu erzählen.
Vielseitige Einsatzmöglichkeiten: Das Tool eignet sich nicht nur für die Comic-Erstellung, sondern kann auch in Szenarien wie der Umwandlung von Bildern in Videos eingesetzt werden. Nutzer können durch die Bereitstellung einer Reihe von Bedingungsbildern mithilfe des Image-to-Video-Modells Videos erzeugen, was neue kreative Möglichkeiten und Produktionsmittel für Bereiche wie Werbung und Film bietet.
Gestaltung von Lehrmaterialien: Pädagogen können StoryDiffusion verwenden, um Lehrvideos oder interaktive Geschichten zu gestalten, die die Beteiligung und das Interesse der Lernenden fördern.
Langstreckige Bilderzeugung: Besonders geeignet für die Erstellung zusammenhängender Werbegeschichten zur Stärkung der Markenidentität. Diese Funktion verleiht StoryDiffusion deutliche Vorteile in den Bereichen Werbung und Markenförderung.
Plug-and-Play ohne Training: Das Forschungsteam hat die Consistent Self-Attention in die U-Net-Architektur bestehender Bilderzeugungsmodelle integriert und die ursprünglichen Self-Attention-Gewichte wiederverwendet, um die Eigenschaften „ohne Training" und „Plug-and-Play" beizubehalten.
Hohe Effizienz und Robustheit: StoryDiffusion kann die Charaktereigenschaften bewahren und gleichzeitig die Prompt-Beschreibungen gut erfüllen, was seine Robustheit zeigt. Dies zeigt, dass die Methode bei quantitativen Metriken die beste Leistung erzielt.
StoryDiffusion kann durch den Consistent Self-Attention-Mechanismus nicht nur konsistente Bilder und Videos erzeugen, sondern auch in zahlreichen realen Szenarien wie Bildung, Werbung und Unterhaltung eingesetzt werden und zeichnet sich dabei durch hohe Effizienz und Robustheit aus.
GitHub-Projekt: Das entsprechende Projekt hat auf GitHub bereits 1k Stars erhalten. Die GitHub-Adresse lautet: https://github.com/HVision-NKU/StoryDiffusion.
Paper und Demo: Weitere technische Details und experimentelle Ergebnisse zu StoryDiffusion sind in dem Paper „StoryDiffusion: Consistent Self-Attention for long-range image and video generation" zu finden. Die Adresse des Papers lautet: https://arxiv.org/pdf/2405.01434v1














