
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
YOLO-World: Echtzeit-Objekterkennung mit offenem Vokabular
YOLO-World: Echtzeit-Objekterkennung mit offenem VokabularEinführung
YOLO-World, ein von Tencentai-Lab entwickeltes Echtzeit-Objekterkennungs-Werkzeug, das automatisch verschiedene Objekte in Bildern erkennen und lokalisieren kann. YOLO-World übertrifft viele hochmoderne Methoden sowohl in Bezug auf Geschwindigkeit als auch Genauigkeit.
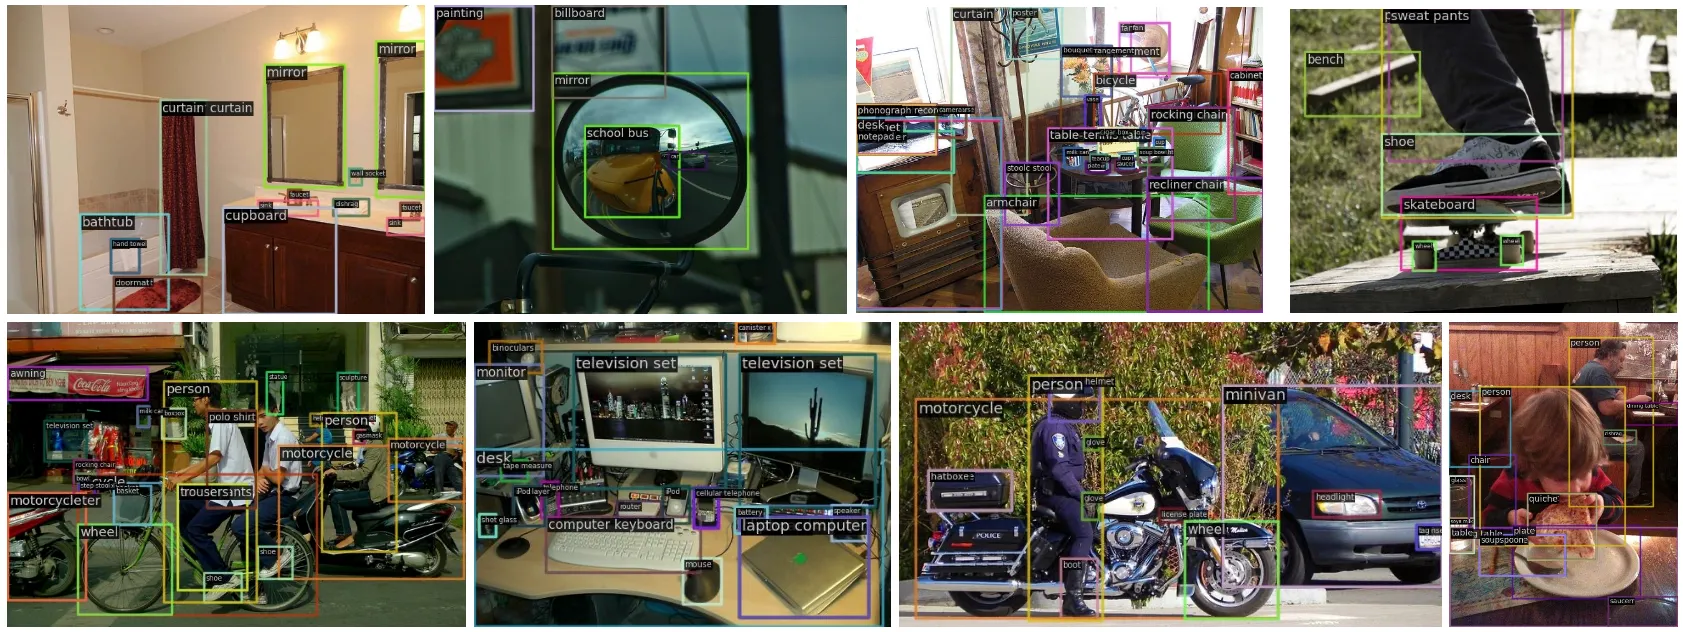
YOLO-World ist die nächste Generation von YOLO-Detektoren und wurde für die Echtzeit-Open-Vocabulary-Objekterkennung entwickelt. YOLO-World wurde auf umfangreichen Vision-Language-Datensätzen (einschließlich Objects365, GQA, Flickr30K und CC3M) vortrainiert, was YOLO-World eine starke Zero-Shot-Open-Vocabulary-Fähigkeit sowie die Fähigkeit zur Bildverankerung verleiht. Es ermöglicht Echtzeit-Objekterkennung ohne Training – selbst wenn bestimmte Objekte zuvor nicht gesehen wurden, ist YOLO-World für Objekterkennung und Open-Vocabulary-Instanzsegmentierung geeignet.
Funktionsmerkmale von YOLO-World:
1. Lernen im großen Maßstab: YOLO-World erwirbt umfassende visuelle und sprachliche Kenntnisse, indem es eine große Menge an Bildern mit den entsprechenden Beschreibungen (z. B. Objektnamen) lernt. Dadurch kann es eine breite Palette von Objekten erkennen.
Das Projekt wurde auf umfangreichen Vision-Language-Datensätzen vortrainiert, darunter Objects365, GQA, Flickr30K und CC3M, was YOLO-World eine starke Zero-Shot-Open-Vocabulary-Fähigkeit sowie Lokalisierungsfähigkeiten in Bildern verleiht.
2. Schnell und genau: YOLO-World erreicht 35.4 AP bei der Zero-Shot-Evaluierung auf dem LVIS-Datensatz und verarbeitet auf einer V100 mit 52.0 FPS, wobei es sowohl in Geschwindigkeit als auch Genauigkeit viele hochmoderne Methoden übertrifft. Selbst in Bildern mit komplexen Szenen bleibt eine hohe Genauigkeit erhalten. YOLO-World gibt an, 20-mal schneller als GroundingDINO zu sein.
3. Zero-Shot-Erkennung: Am beeindruckendsten ist, dass YOLO-World selbst dann, wenn es bestimmte Objekte zuvor nicht gesehen hat, mithilfe zuvor erlernter Fähigkeiten sowie Hinweisen und Kontextinformationen im Bild diese neuen Objekte erfolgreich erkennen und lokalisieren kann. Das bedeutet, dass wir es nicht trainieren müssen, um neue Objektklassen zu erkennen. Wir müssen lediglich den Klassennamen als Texteingabeaufforderung angeben, und das Modell gibt die Bounding Boxes dieser Objekte zurück (falls vorhanden).
4. Objekte verstehen: YOLO-World stützt sich nicht nur auf visuelle Informationen, sondern kombiniert diese auch mit sprachlichen Informationen. Es versteht menschliche Sprachbeschreibungen, wodurch es in der Lage ist, selbst Objekte zu identifizieren, die es zuvor nicht direkt gesehen hat.
5. Im Vergleich zu bestehenden Open-Vocabulary-Erkennungsmethoden ist das YOLO-World-Modell mindestens 20-mal schneller. Es kann etwa 52 Bilder pro Sekunde verarbeiten.
6. Es setzt einen neuen, hochmodernen Maßstab auf dem LVIS-Objekterkennungsdatensatz.














