
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Umi-OCR: Kostenloses, Open-Source-Offline-OCR-Tool für Stapelverarbeitung
小编 ·

Umi-OCR: Kostenloses, Open-Source-Offline-OCR-Tool für Stapelverarbeitung
Was ist Umi-OCR?
Umi-OCR ist ein quelloffenes, kostenloses Offline-OCR-Tool, das auf dem PaddleOCR-Framework von Baidu basiert. Es unterstützt Screenshot-/Batch-Bildimport, Texterkennung in PDF-Dokumenten, das Entfernen von Wasserzeichen/Kopf- und Fußzeilen, das Scannen/Erstellen von QR-Codes sowie eingebaute mehrsprachige Bibliotheken. Es bietet hohe Erkennungsgenauigkeit, Offline-Betrieb, Mehrsprachenunterstützung und effiziente Stapelverarbeitung.
Funktionsmerkmale von Umi-OCR
Offline-Betrieb: Vollständig offline nutzbar, keine Internetverbindung erforderlich, schützt die Privatsphäre der Nutzer.
Mehrsprachenunterstützung: Integrierte mehrsprachige Bibliotheken, unterstützt Texterkennung in vielen Sprachen.
Vielfältige Erkennungsfunktionen:
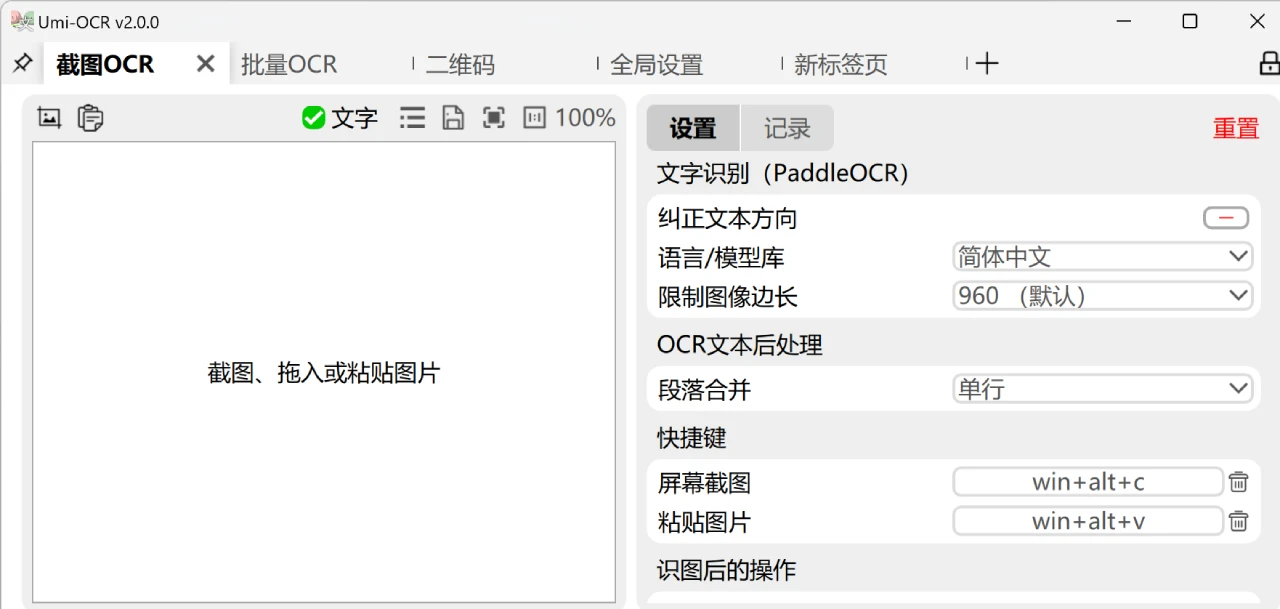
Screenshot-OCR: Unterstützt Bildschirmfotos und eingefügte Bilder zur Texterkennung.
Stapel-OCR: Ermöglicht den Batch-Import von Bildern zur Texterkennung und unterstützt mehrere Bildformate.
PDF-Erkennung: Unterstützt das Extrahieren von Text aus PDF-Dokumenten, Kopf- und Fußzeilen können ausgeschlossen werden.
QR-Code-Erkennung: Unterstützt das Scannen und Erstellen von QR-Codes.
Formelerkennung: Unterstützt die Erkennung mathematischer Formeln (in der Testphase).
Textnachbearbeitung: Unterstützt die Formatierung und Bereinigung der Erkennungsergebnisse, um Störtexte zu entfernen.
Flexible Aufrufoptionen: Unterstützt Kommandozeilen- und HTTP-Schnittstellenaufrufe, bequem für die Integration durch Entwickler.
Technische Merkmale von Umi-OCR
Hohe Erkennungsgenauigkeit: Integrierte mehrsprachige Modelle, unterstützt vereinfachtes/traditionelles Chinesisch, Englisch, Japanisch, Koreanisch und gängige europäische Sprachen sowie die Erkennung von Texten in gemischter Layoutgestaltung.
Komplexe Layoutanalyse: Präzise Erkennung von vertikalem Text, Tabellen und einfachen mathematischen Formeln.
Optimierung für Bilder geringer Qualität: Vorverarbeitung für unscharfe, geneigte und schlecht beleuchtete Bilder zur Steigerung der Erkennungsgenauigkeit.
Effiziente Stapelverarbeitung und flexible Ausgabe: Unterstützt das Hineinziehen von Ordnern oder den Batch-Import von Bildern, sodass Hunderte von Dateien mit einem Klick per OCR erkannt werden können.
Anwendungsszenarien von Umi-OCR
Büroszenarien: Schnelles Extrahieren von Text aus gescannten PDFs und Bildberichten und Umwandlung in bearbeitbare Dokumente.
Wissenschaftliche Recherche: Erkennung fremdsprachiger Literatur und historischer Quellen zur Unterstützung von Übersetzung und Zitation.
Multimedia-Verarbeitung: Bietet Texterkennungsunterstützung für Video-Screenshots, Manga-Übersetzungen und Spieluntertitel.
Automatisierte Abläufe: Integration in andere Toolchains über die Kommandozeilenschnittstelle zur Automatisierung der Batch-OCR.
Download und Nutzung von Umi-OCR
Download-Links:
Lanzou Cloud (für China empfohlen, keine Registrierung/keine Geschwindigkeitsbegrenzung): https://hiroi-sora.lanzoul.com/s/umi-ocr
GitHub Release: https://github.com/hiroi-sora/Umi-OCR/releases/tag/v2.1.4
Installation: Einfach entpacken und nutzen, keine Installation erforderlich. Unterstützt Windows 7 x64 und Linux x64.
Installation über die Kommandozeile: Installation über Scoop (Windows):
scoop install extras/umi-ocr
Zukünftige Pläne
Refactoring des zugrunde liegenden Plugin-Mechanismus.
Hinzufügen eines Online-OCR-API-Plugins.
Implementierung eines eigenständigen Plugins zur Erkennung mathematischer Formeln.
Unterstützung für Bildübersetzung und Offline-Übersetzung.
Kompatibilität mit macOS und weiteren Linux-Distributionen
Das vor ein paar Tagen vorgestellte olmOCR ist ebenfalls empfehlenswert. Wer den Schwerpunkt auf PDF-Konvertierung legt, kann es auch einmal ausprobieren.









