
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
olmOCR: leistungsstarkes Open-Source-OCR-Tool für hochpräzise PDF- und Dokumentkonvertierung
小编 ·

olmOCR: leistungsstarkes Open-Source-OCR-Tool für hochpräzise PDF- und Dokumentkonvertierung
Was ist OLMOCR?
OLMOCR ist ein quelloffenes Tool, das PDF-Dateien mit hoher Genauigkeit in Text umwandeln kann. Bei der Konvertierung wird die Lesereihenfolge des Dokuments beibehalten und die Erkennung von Tabellen, Gleichungen und handschriftlichen Inhalten unterstützt. Es verfügt zudem über eine hohe Dokumenten-Durchsatzfähigkeit, eine Textkonvertierung unter Beibehaltung der natürlichen Lesereihenfolge und eine hohe Genauigkeit, die Halluzinationen reduziert.
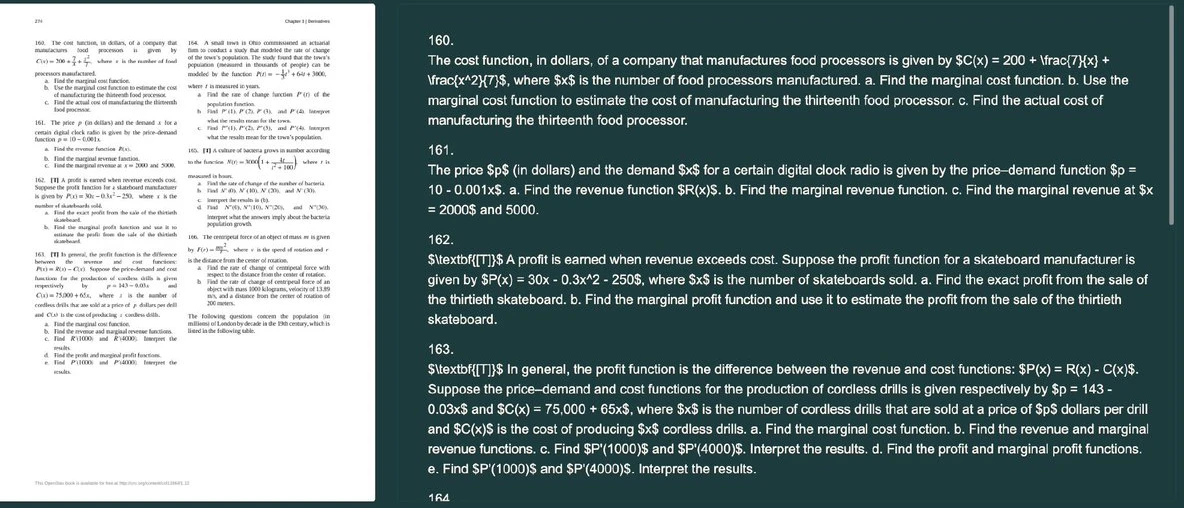
Funktionen und Merkmale von olmOCR
Hohe Genauigkeit: OLMOCR bietet fortschrittliche OCR-Technologie, die sicherstellt, dass die inhaltliche Genauigkeit während des Konvertierungsprozesses maximal erhalten bleibt.
Unterstützung mehrerer Formate: Dieses Tool kann verschiedene Arten von PDFs verarbeiten, einschließlich Dokumenten mit komplexen Formatierungen.
Entwickler-Toolkit: Neben den grundlegenden OCR-Funktionen enthält OLMOCR eine Reihe von Werkzeugen zur Linearisierung von PDFs, um Datensätze zu erstellen, die für das Training von ai-Sprachmodellen geeignet sind.
Anwendungsfälle von olmOCR
Kann verwendet werden, um gescannte Papierdokumente in Text zu digitalisieren und so die Dokumentenverwaltung zu erleichtern.
Die integrierten Funktionen helfen Benutzern, wichtige Daten wie Tabelleninhalte zu extrahieren, um sie später zu analysieren und zu nutzen.
Geeignet für Unternehmen und Forschungseinrichtungen, die eine umfangreiche Dokumentenverarbeitung benötigen.
Kann im Bildungsbereich für die Digitalisierung von Prüfungsmaterialien und handschriftlichen Notizen eingesetzt werden.
Im medizinischen Bereich kann dieses Tool zur Verarbeitung gescannter Krankenakten und Formulare genutzt werden.
Im juristischen Bereich kann es zur effizienten Verwaltung und Recherche von Rechtsdokumenten verwendet werden.
Geeignet für historische Forschungsprojekte, die eine Digitalisierung und Archivierung von Papierdokumenten erfordern.
Vorteile von olmOCR
Hohe Erkennungsgenauigkeit: Fähigkeit zur Erkennung komplexer Strukturen (wie Tabellen, Gleichungen usw.).
Wirtschaftlich effizient: Die Konvertierungskosten betragen nur 190 US-Dollar pro Million PDF-Seiten.
Großskalige Verarbeitungsfähigkeit: Ermöglicht die Massenkonvertierung großer Dateien.
Kompatibilität mit verschiedener Hardware: Kann an unterschiedliche Hardwarekonfigurationen angepasst werden.
Umfassende Komponenten: Bietet Modellgewichte, Daten und Trainingscode, aus denen Benutzer flexibel wählen können.
Häufig gestellte Fragen zu olmOCR
F: Wird die Erkennung handschriftlicher Texte unterstützt?
A: Ja, olmOCR kann handschriftliche Texte erkennen.
F: Gibt es Beschränkungen für die Stapelverarbeitung?
A: olmOCR unterstützt großskalige Stapelverarbeitung und passt sich flexibel an verschiedene Hardwareumgebungen an.
F: Gibt es eine kostenlose Testversion?
A: Die Übersicht und alle Komponenten sind quelloffen und auf GitHub verfügbar.
F: Wie viel Zeit wird durchschnittlich für die Verarbeitung einer PDF-Seite benötigt?
A: Die genaue Zeit hängt von der Hardwarekonfiguration ab, aber die Gesamtlaufzeitkosten sind sehr gering.
F: Welche Sprachen werden unterstützt?
A: olmOCR unterstützt mehrere Sprachen, einschließlich Inhalten mit komplexen Strukturen.
Online-Demo:Besuchen Sie olmocr.allenai.org
GitHub-Repository:https://github.com/allenai/olmocr









