
 脚本プランナー▸
 AIアプリ
 AIニュース
Story-Iter:UCSC-VLAAが提案する長編ストーリー視覚化ソリューション
Story-Iter:UCSC-VLAAが提案する長編ストーリー視覚化ソリューション紹介
Story-Iterとは?
Story-Iterは、UCSC-VLAAが提案する長編ストーリーの可視化ソリューションです。このタスクは、物語のテキストに基づいて一貫した画像シーケンスを生成し、最大100フレームの長編ストーリーシーンに対応します 。
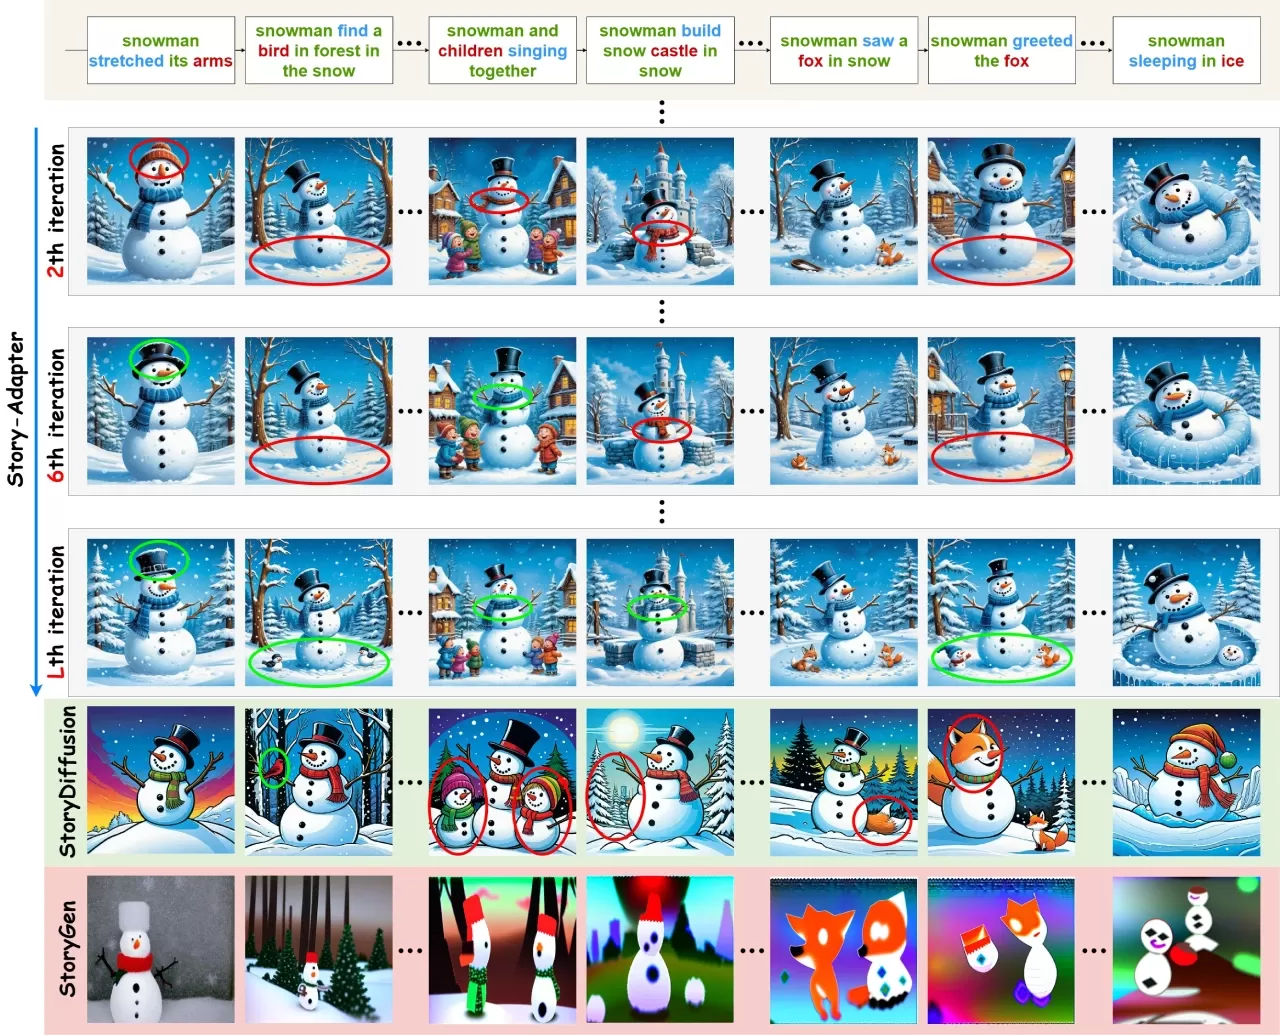
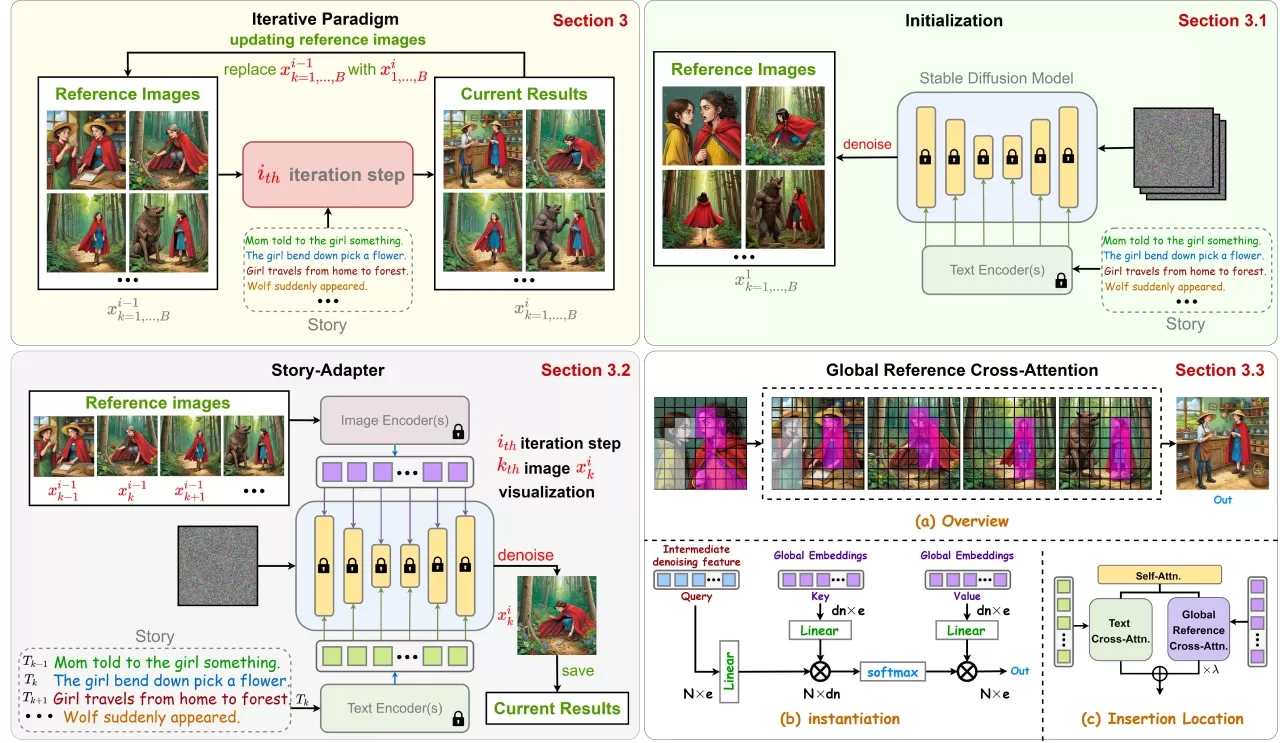
自己回帰手法とは異なり、Story-Iterは外部反復メカニズムを採用しています。拡散モデルの内部ノイズ除去ステップに加えて、追加の反復ループを導入し、各フレームの品質を最適化するために、前回生成されたすべての参照画像を継続的に統合します 。
🔧 Story-Iterの主な機能
1. グローバル参照クロスアテンションモジュール
プラグアンドプレイ:追加学習不要で、既存の拡散モデル(Stable Diffusionなど)に直接統合可能
グローバル埋め込み:すべての参照フレームをグローバル埋め込みでモデル化し、長尺シーケンスのセマンティック一貫性を保証
クロスアテンション機構:画像生成プロセス中、すべての参照画像の情報フローを集約
2. 反復最適化パラダイム
初期化フェーズ:物語テキストのプロンプトに基づいて各フレームの初期バージョンを生成
反復リファインメント:前ラウンドで生成されたすべての画像を次のラウンドの参照として段階的に最適化
漸進的な改善:全体的な視覚コンテキストとテキスト制約を繰り返し統合することで、きめ細かいインタラクション生成を実現
3. 長尺シーケンス対応
最大100フレームの長編ストーリー画像シーケンスの生成に対応
セマンティック一貫性と詳細なインタラクションの面で優れた性能を発揮
🎯 Story-Iterの活用シーン
漫画・絵本の生成:長編ストーリーテキストから一貫した漫画ページを自動生成
アニメーションプリビズ:アニメーション制作にストーリーボードレベルのビジュアルプレビューを提供
映画ストーリーボード:監督や撮影監督が絵コンテを迅速に作成することを支援
児童書:教育コンテンツ向けの挿絵豊富な物語書籍を作成
広告クリエイティブ:長尺シーケンスのプロモーション用ビジュアルストーリーを生成
ゲームカットシーン:ゲームのシナリオに合わせた連続的なビジュアルナラティブを生成
✅ Story-Iterの長所と短所
長所
学習不要:追加のモデル学習やファインチューニングが不要で、プラグアンドプレイ
計算効率:大規模なマルチモーダルエンコーダーを導入する手法と比べて、計算コストが低い
一貫性の保証:グローバル参照メカニズムにより、長尺シーケンスにおけるキャラクター、シーン、スタイルの一貫性を効果的に維持
細粒度のインタラクション:複雑な人物インタラクションを含む高品質なシーンを生成可能
拡張性:最大100フレームのストーリー生成に対応し、従来の方法をはるかに超える
短所
反復のオーバーヘッド:学習不要だが、反復プロセスでは複数回の推論が必要で、時間コストが高い
ベースモデルへの依存:性能は基盤となる拡散モデル(SDなど)の能力に制限される
長編ストーリーの課題:100フレームに対応するが、極端に長いストーリーでは一貫性のドリフトが発生する可能性あり
公式コードの未公開:GitHubリポジトリが完全公開されていない、または初期段階にある可能性あり
🛠️ Story-Iterの使用方法
環境準備
# 克隆仓库(假设已公开)
git clone https://github.com/UCSC-VLAA/story-iter.git
cd story-iter
# 安装依赖
pip install -r requirements.txt
基本的な使用フロー
ストーリーテキストの準備:ストーリーを連続したテキスト記述に分解(各フレームに1つの記述が対応)
初期化生成:最初のラウンドの生成を実行し、テキストプロンプトのみに基づいて初期画像シーケンスを生成
反復最適化:
生成された画像を次のラウンド生成の参照として使用
GRCAモジュールを有効化し、グローバル参照情報を集約
収束するか事前設定された反復回数に達するまで反復
結果の出力:最終的に最適化された一貫したストーリー画像シーケンスを取得
主要なパラメータ
--num_iterations:反復回数(通常3〜5回で顕著な改善が見られる)
--use_grca:グローバル参照クロスアテンションモジュールを有効化
--num_frames:ストーリーフレーム数(最大100フレームまで対応)
❓ Story-Iterに関するよくある質問
Q1: Story-IterとStory-Adapterの関係は?
arXivの情報によると、Story-IterとStory-Adapterは同じプロジェクトの異なる名称です。論文ではStory-Adapter: A Training-free Iterative Framework for Long Story Visualizationとして引用されていますが、プロジェクトページおよびICLR 2026への提出ではStory-iterの名称が使用されています 。
Q2: 自分のモデルを学習させる必要がありますか?
不要です。Story-Iterは学習不要(training-free)のフレームワークであり、事前学習済みのStable Diffusionモデルに直接適用できます 。
Q3: どのベースモデルに対応していますか?
主にStable Diffusionシリーズモデル(SD 1.5、SDXLなど)に基づいており、GRCAモジュールを挿入することで機能を拡張します 。
Q4: 100フレームのストーリー生成にはどれくらいの時間がかかりますか?
具体的な時間はハードウェア構成と反復回数によって異なります。反復最適化メカニズムを採用しているため、合計時間 = 単一フレーム生成時間 × フレーム数 × 反復回数。A100 GPUを使用することで大幅に高速化されます。
Q5: キャラクターの一貫性はどのように保証されますか?
GRCAモジュールのグローバル参照メカニズムにより、各反復ですでに生成されたすべてのフレームの情報が集約され、キャラクターの外見、服装、シーン要素がストーリー全体で一貫して保たれます 。
📚 関連リソース
プロジェクトページ:https://jwmao1.github.io/storyiter/
論文アドレス:https://arxiv.org/abs/2410.06244
GitHubリポジトリ:https://github.com/UCSC-VLAA/story-iter
所属機関:UCSC-VLAA(カリフォルニア大学サンタクルーズ校 視覚言語・人工知能研究所)














