
 Asistente de guiones▸
 Apps AI
 Noticias AI
RAGFlow: motor RAG de código abierto basado en comprensión profunda de documentos
RAGFlow: motor RAG de código abierto basado en comprensión profunda de documentosIntroducción
RAGFlow es un motor de generación aumentada por recuperación (RAG) de código abierto, diseñado para comprender documentos en profundidad. Proporciona flujos de trabajo RAG sencillos y eficientes para todo tipo de empresas y particulares, y combinado con grandes modelos de lenguaje (LLM) ofrece respuestas fiables con citas fundamentadas para datos en formatos complejos. RAGFlow es ideal para escenarios que requieren generación dinámica de contenido y dependen de bases de conocimiento externas, como atención al cliente inteligente, generación de documentos y análisis de datos, ayudando a los usuarios a extraer de forma eficiente información valiosa de grandes volúmenes de datos.
Funciones principales de RAGFlow:
Integración con grandes modelos de lenguaje: compatible con modelos como Zhipu y DeepSeek, y admite despliegue local mediante Xinference y Ollama, mejorando las respuestas.
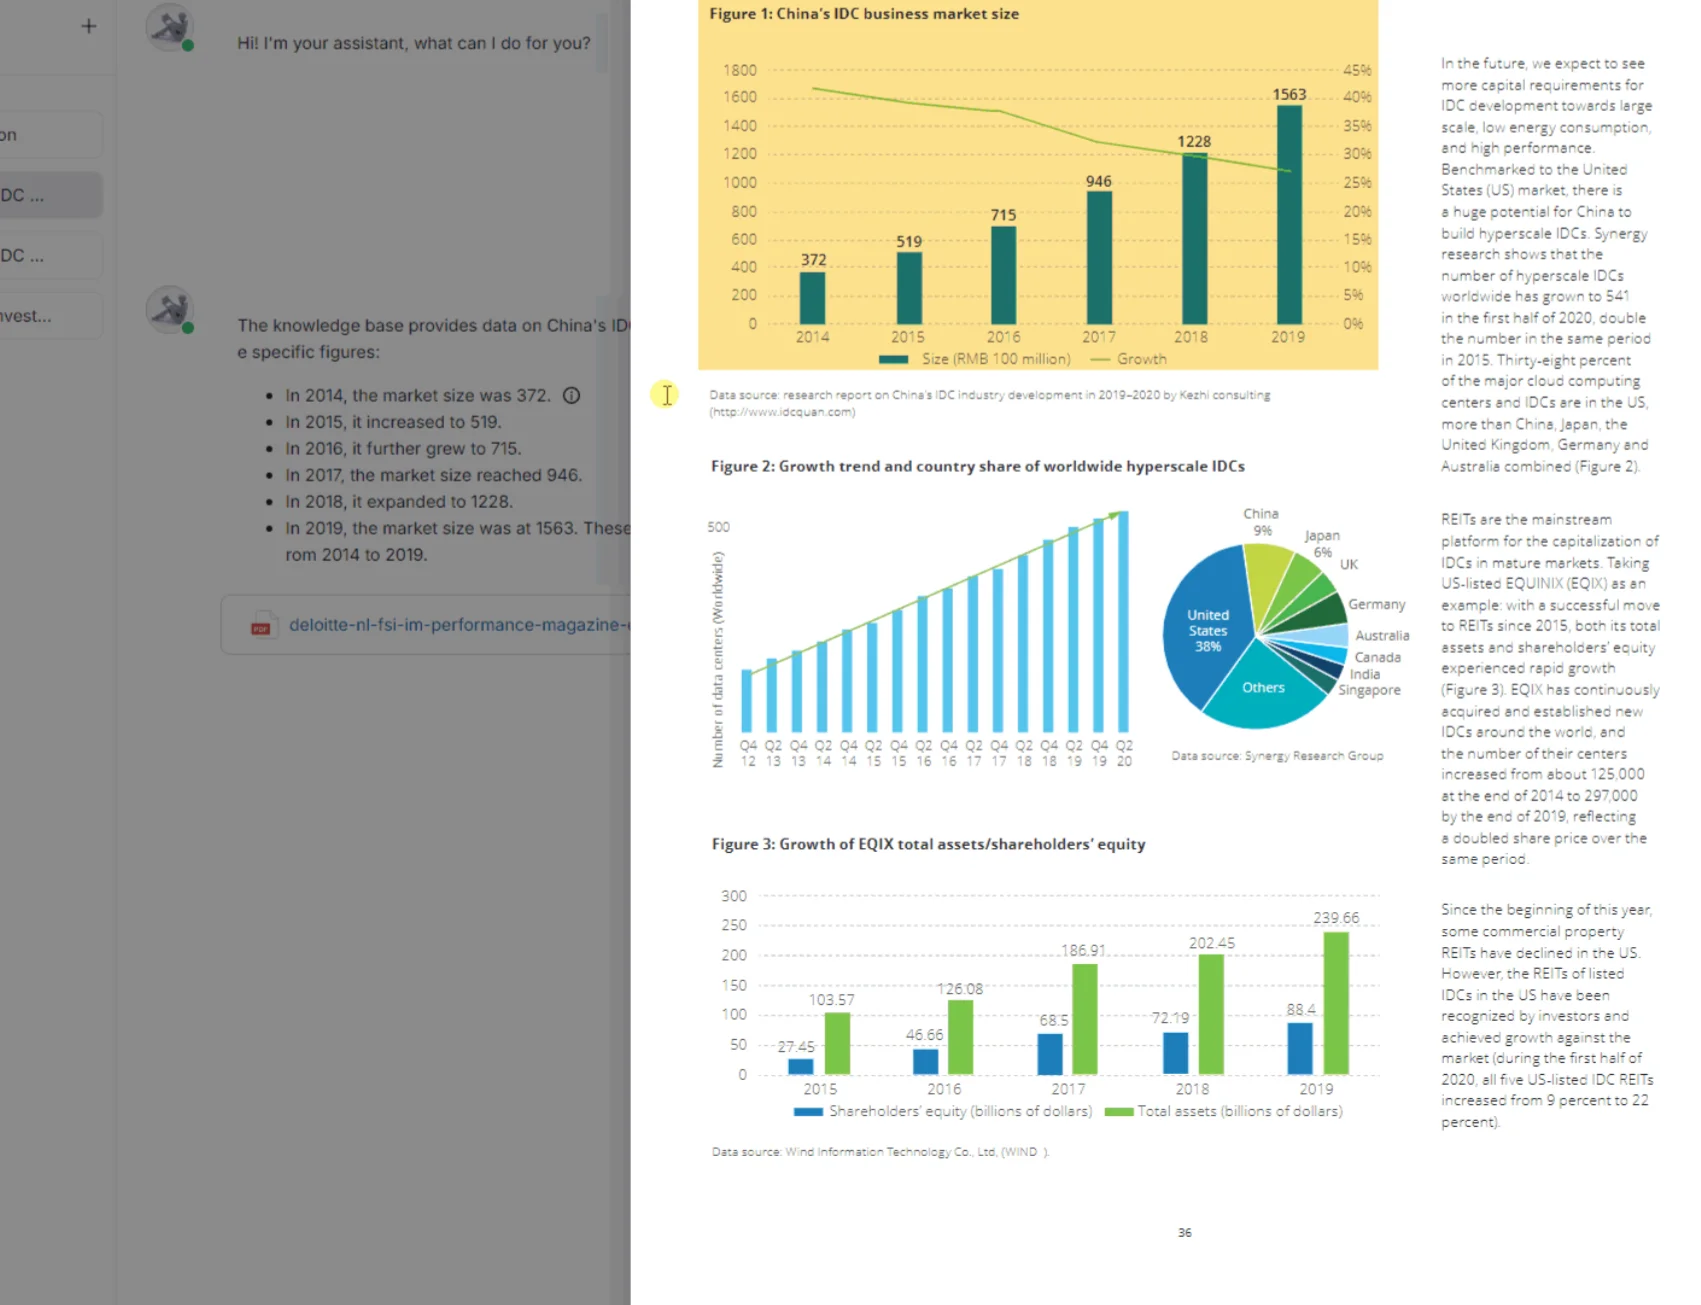
Comprensión profunda de documentos: capaz de analizar documentos en múltiples formatos como PDF, Word, Excel y ppt, extrayendo información clave como texto, imágenes y tablas.
Fragmentación basada en plantillas: mecanismo inteligente de fragmentación en el que el usuario puede elegir plantillas según sus necesidades, mejorando la eficiencia y la precisión del procesamiento de datos.
Soporte de citas para reducir alucinaciones: tecnología de fragmentación de texto visualizable que permite revisar rápidamente referencias clave y citas trazables, reduciendo el riesgo de alucinaciones en el uso de la información.
Compatibilidad con datos de múltiples fuentes: admite documentos, diapositivas, Excel, texto, imágenes, escaneos, datos estructurados, páginas web y otros tipos de datos heterogéneos.
Flujo de trabajo simplificado y automatizado: procesos RAG automatizados con configuración flexible de LLM y modelos de embedding, que permiten la recuperación de datos y la reordenación de la fusión.
Procesamiento diverso de documentos: compatible con formatos de archivo como Word, PPT, Excel, TXT, imágenes, PDF, páginas web y otros datos no estructurados.
Edición de flujos de trabajo sin código: admite la edición de tareas y flujos de trabajo sin necesidad de programar.
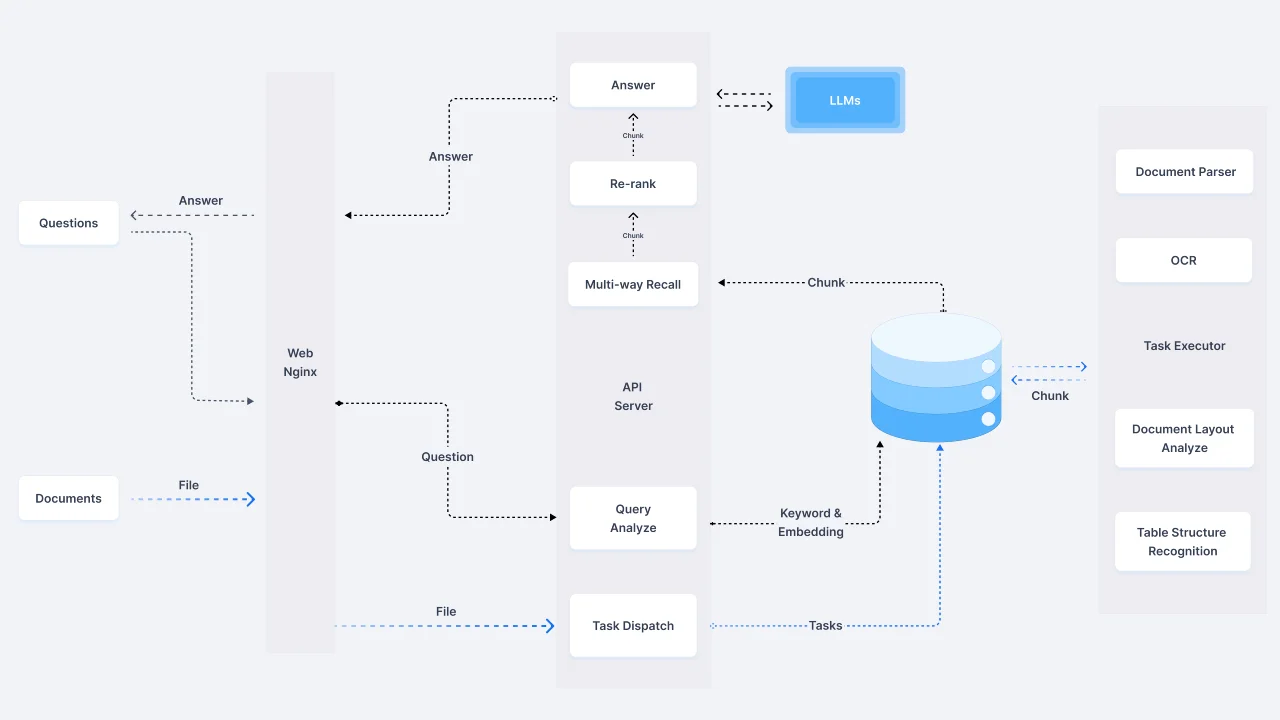
Arquitectura del sistema RAGFlow:
La arquitectura del sistema RAGFlow incluye componentes clave como el analizador de documentos, el analizador de consultas, el recuperador, el reordenador y el LLM (modelo de lenguaje grande), logrando respuestas rápidas y un procesamiento preciso ante consultas complejas.
Aplicaciones de RAGFlow:
Gestión del conocimiento empresarial: creación de una base de conocimiento propia para optimizar el intercambio y la recuperación interna de conocimientos.
Atención al cliente: integración en sistemas de soporte para recuperar información rápidamente y resolver las dudas de los clientes de forma eficiente.
Sistemas de recuperación de información: construcción de sistemas eficientes para obtener rápidamente la información requerida.
Generación de documentos: generación automática de informes, resúmenes y otros documentos.
Análisis de datos: extracción de información clave a partir de grandes volúmenes de datos para su análisis.
Apoyo a la educación y la investigación: sistemas inteligentes de tutoría que pueden generar pasos de resolución o recursos de aprendizaje a partir de las preguntas de los estudiantes.
¿Cómo usar RAGFlow?
1. Configuración del entorno: instala y configura RAGFlow siguiendo la documentación oficial; es necesario disponer de un entorno de desarrollo como Python.
2. Definición de tareas: utiliza el editor sin código o la interfaz de programación para definir las tareas y los flujos de trabajo necesarios.
3. Ingreso de datos: introduce en el sistema los datos a procesar (como consultas de usuarios, textos, etc.).
4. Recuperación y generación dinámicas: el sistema recupera y genera contenido automáticamente según el flujo de trabajo predefinido.
5. Ajuste y optimización: evalúa los resultados obtenidos y ajusta y optimiza las tareas para mejorar el rendimiento del modelo.
GitHub: https://github.com/infiniflow/ragflow














