
 Assistant scénario▸
 Apps AI
 Actualités AI
Tarsier : grand modèle vision-langage de ByteDance
Tarsier : grand modèle vision-langage de ByteDanceIntroduction
Tarsier est une série de modèles de langage vision de grande taille (LVLM) lancée par ByteDance, spécialisée dans les tâches de compréhension vidéo, incluant la description vidéo, les questions-réponses, la localisation et les tests d'hallucination.
Fonctionnalités principales de Tarsier
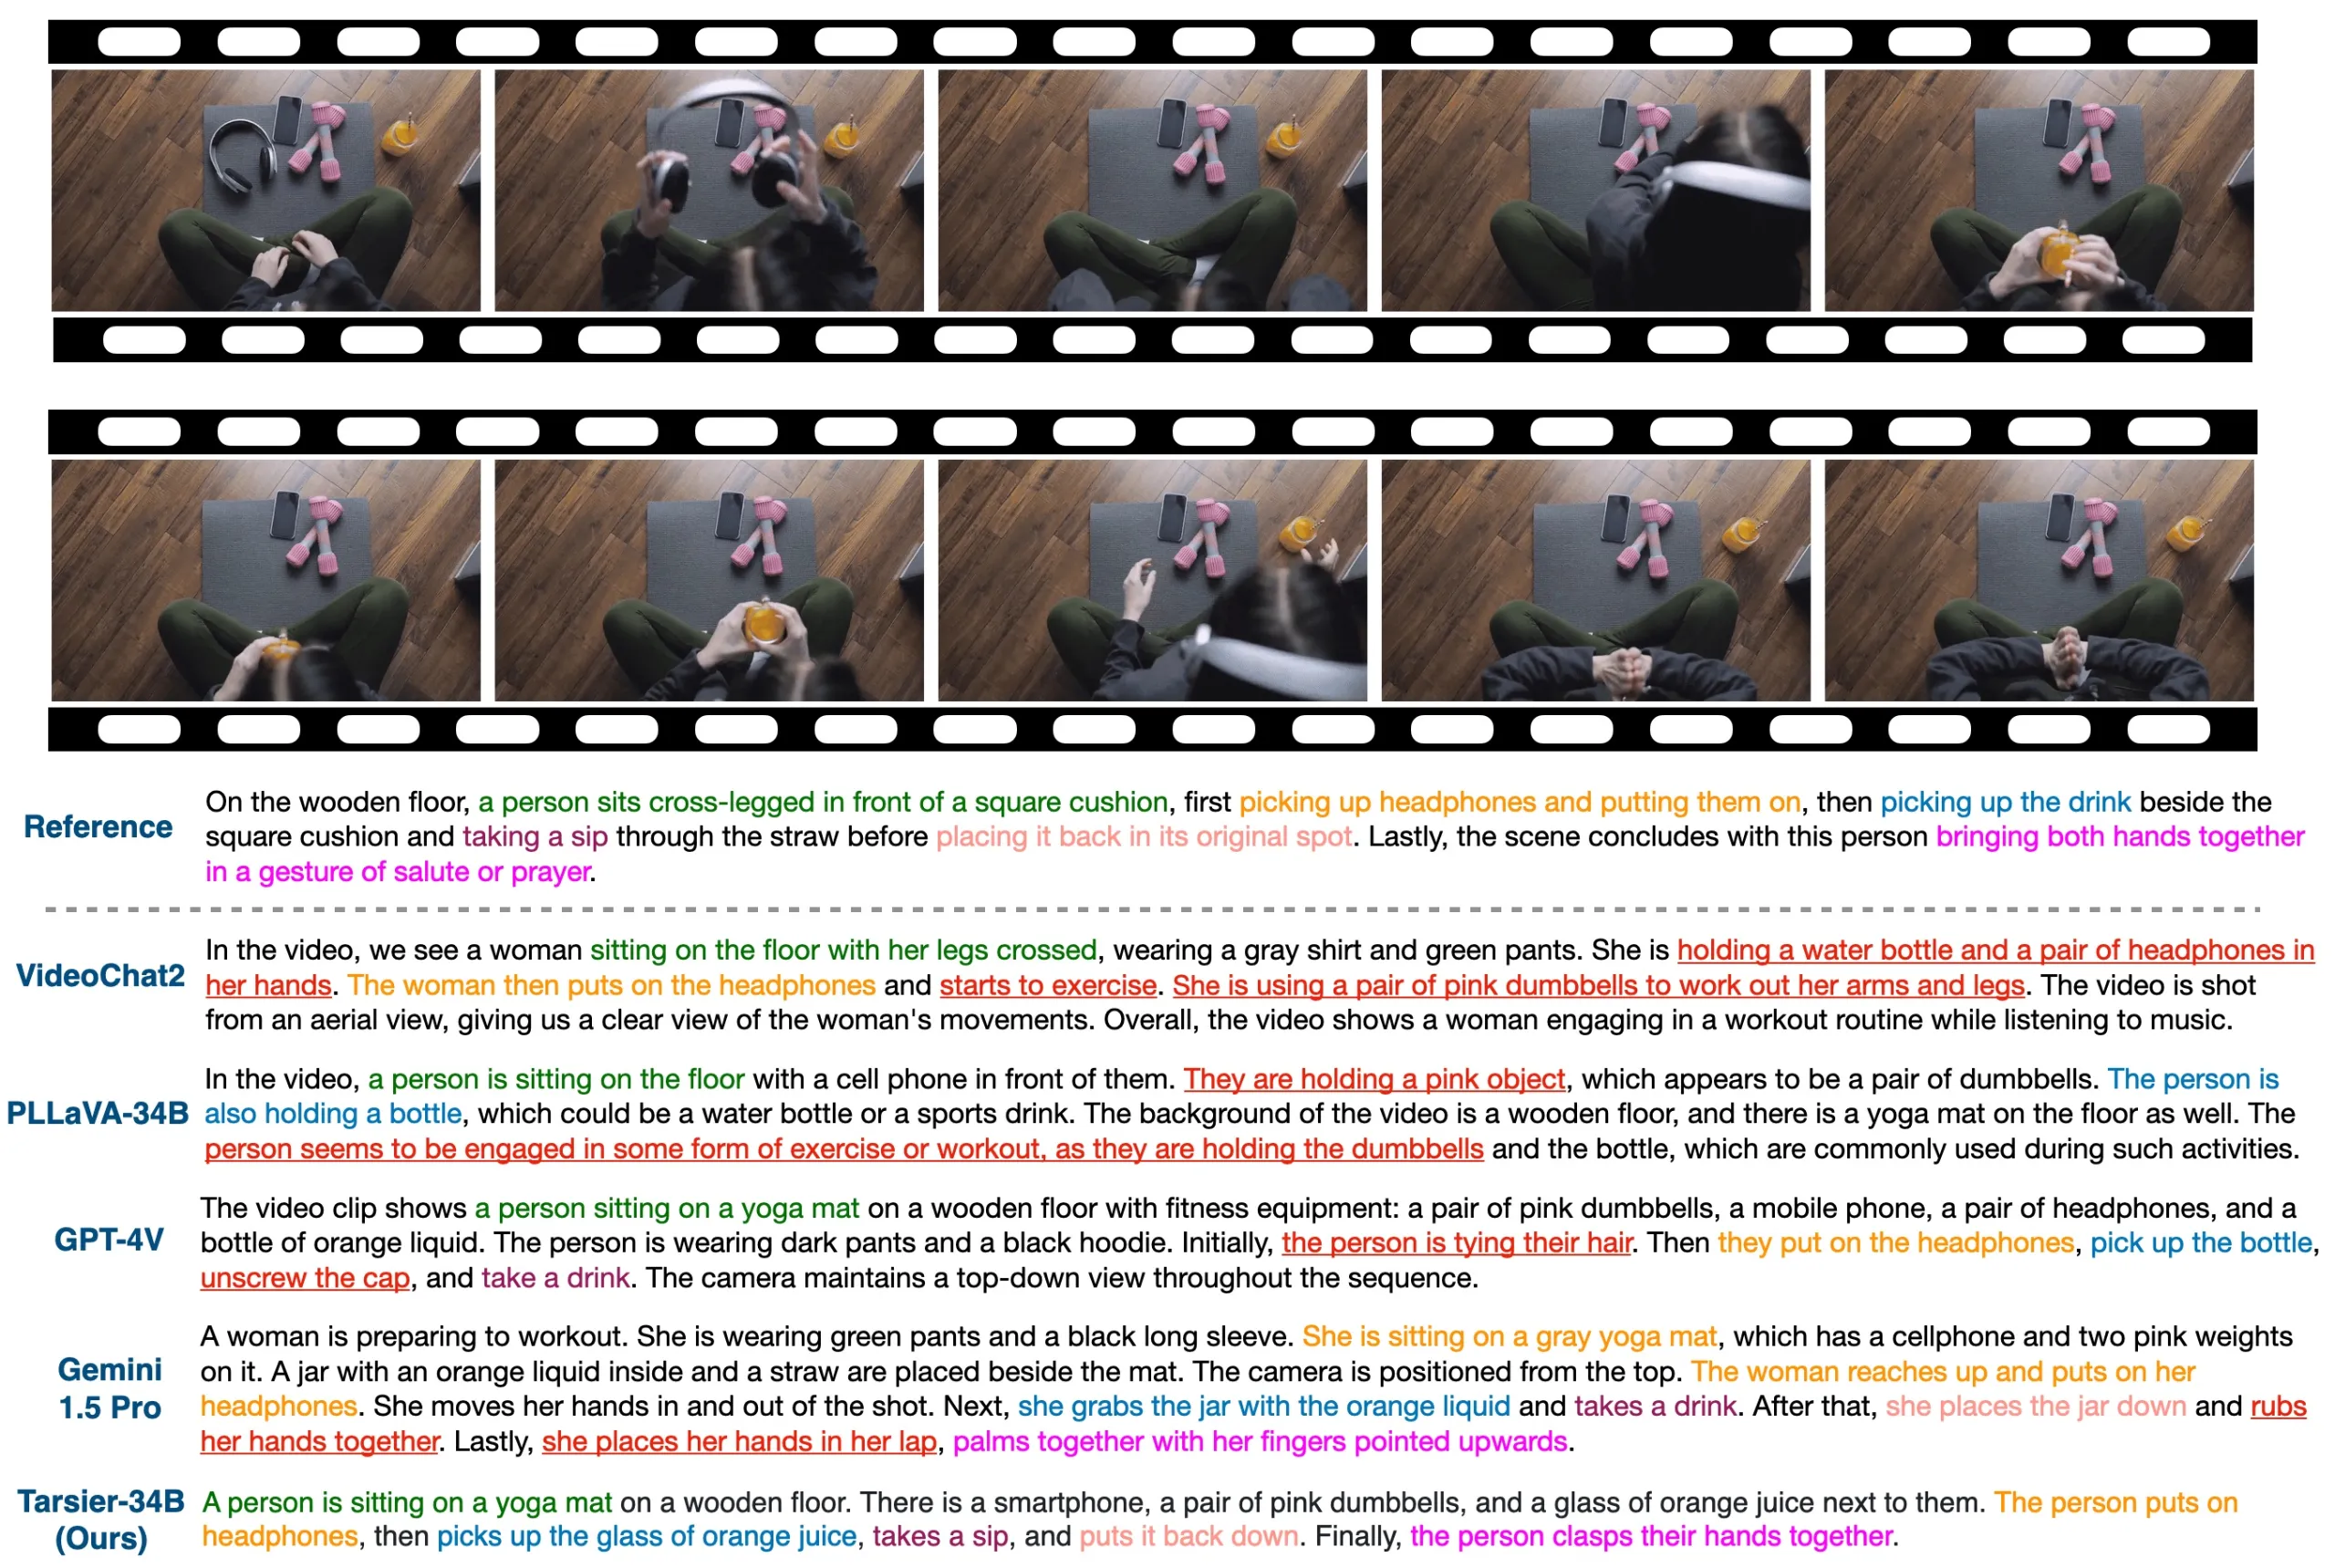
Génération de descriptions vidéo : Tarsier peut générer des descriptions vidéo de haute qualité, couvrant divers détails de la vidéo, notamment les actions, les scènes et l'intrigue, aidant les utilisateurs à mieux comprendre le contenu vidéo.
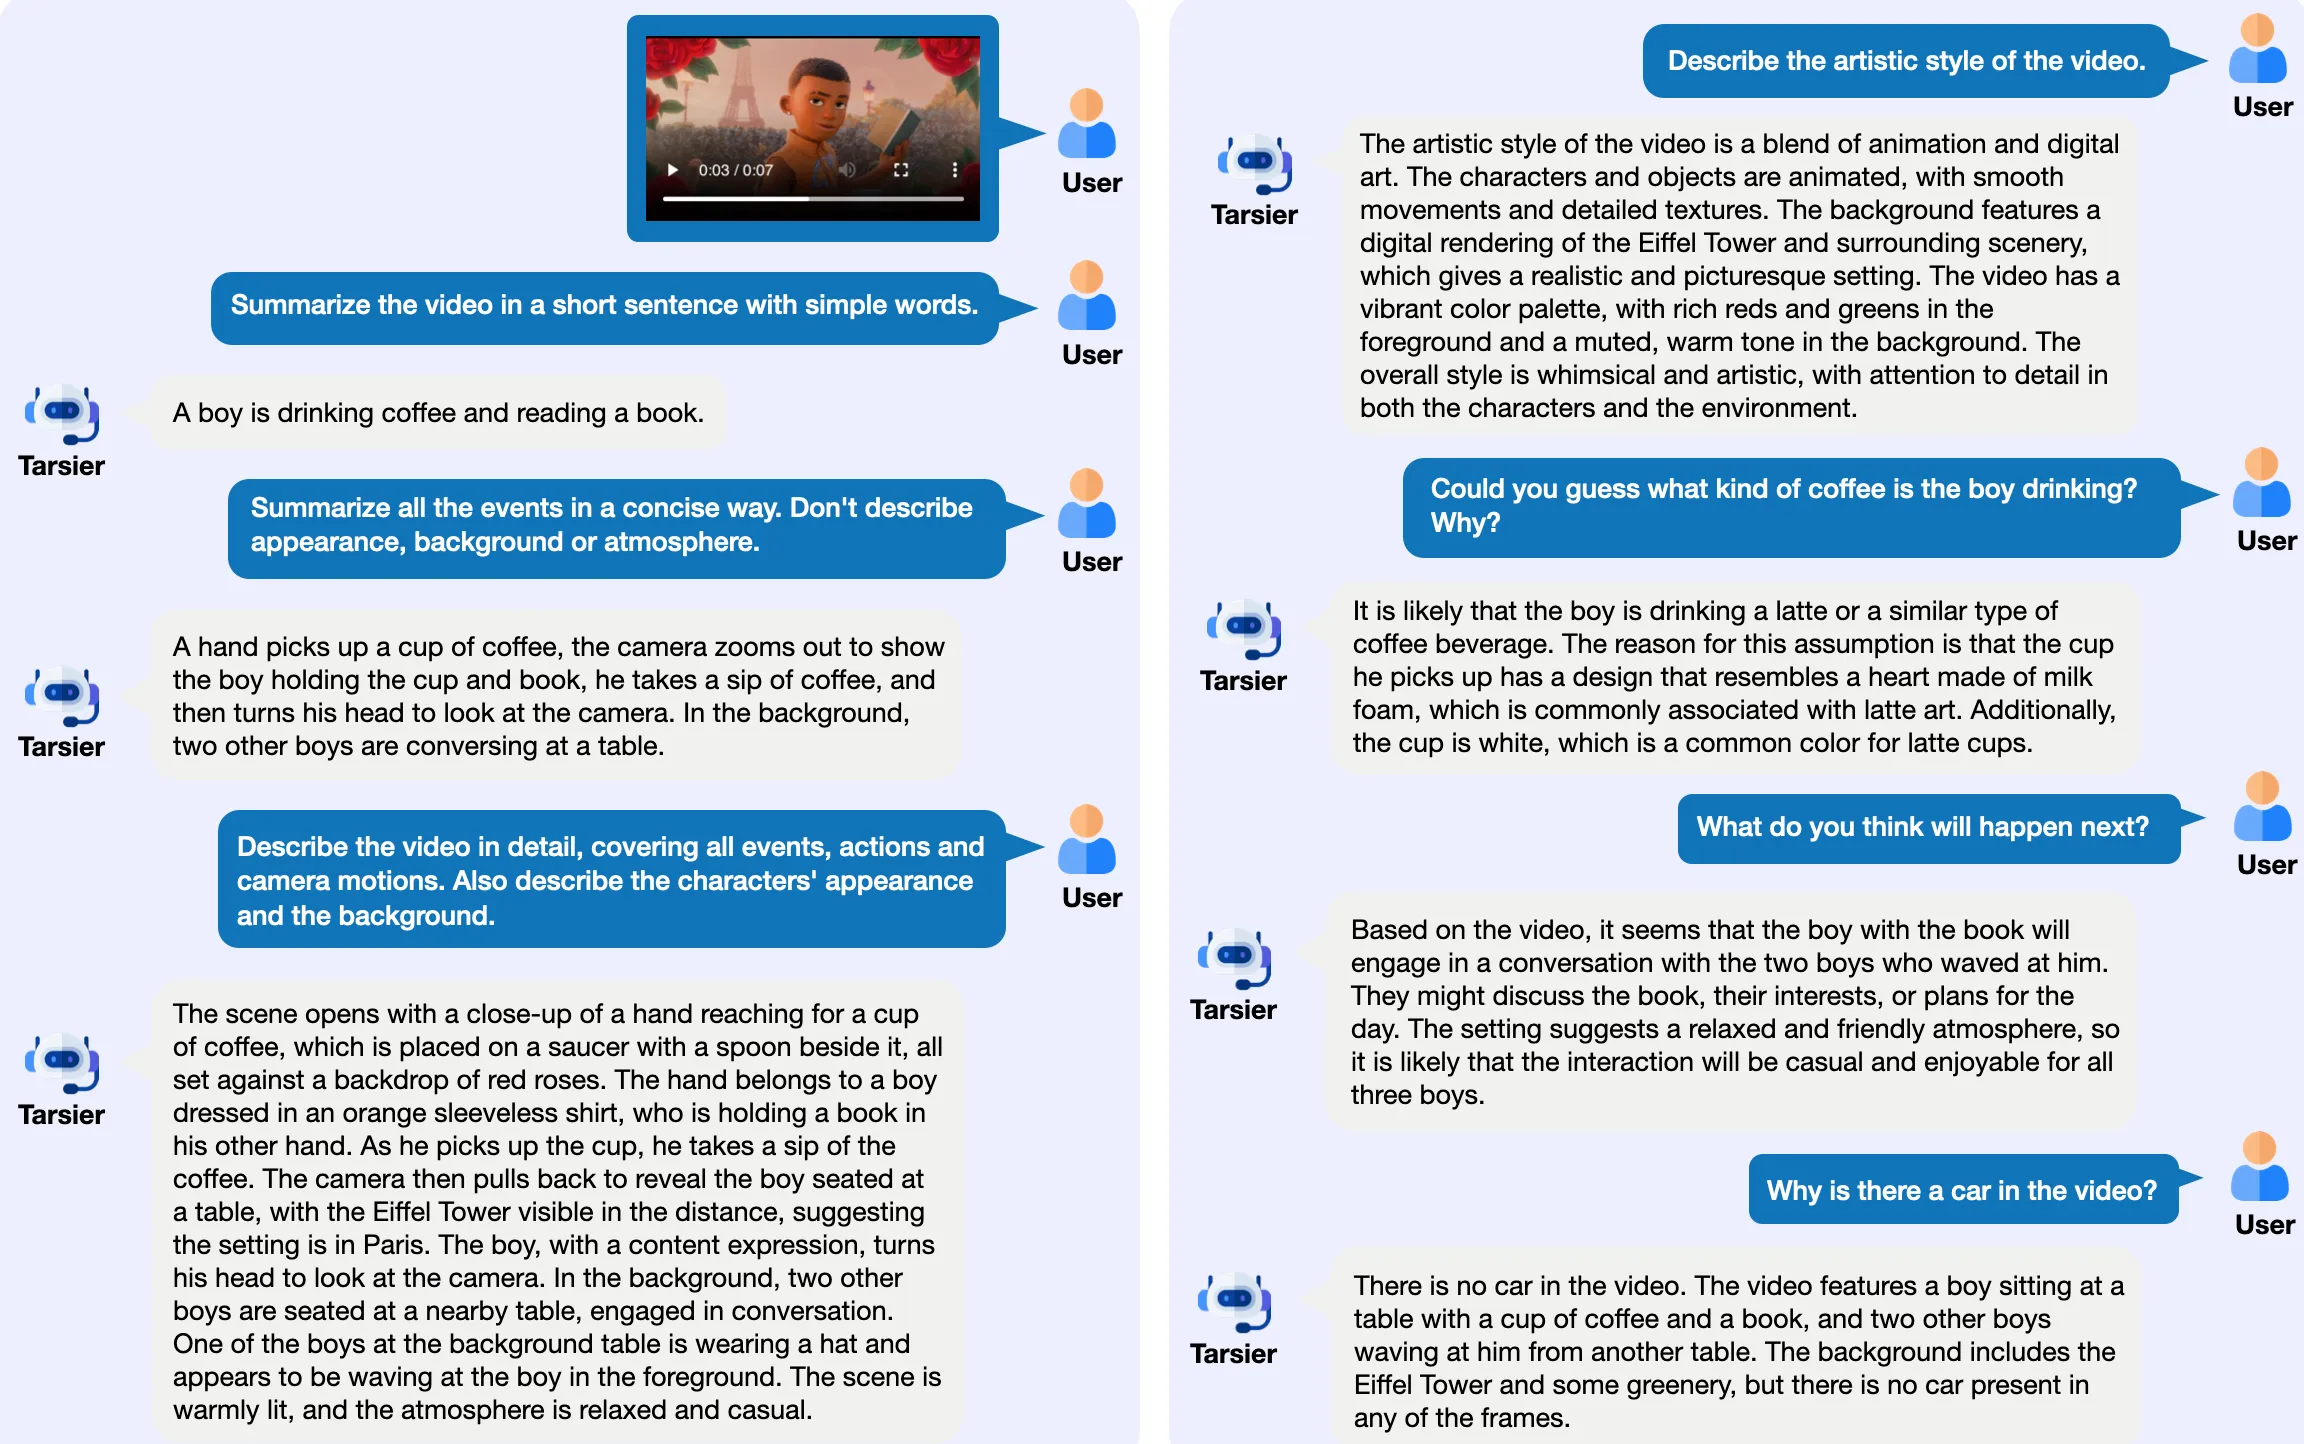
Capacité de questions-réponses : Le modèle Tarsier prend en charge les questions-réponses vidéo, les utilisateurs peuvent poser des questions basées sur le contenu vidéo, et le modèle fournira des réponses pertinentes.
Fonction de localisation : Détecte et localise le moment où des événements spécifiques se produisent dans la vidéo, prend en charge la localisation sur plusieurs segments vidéo, et permet d'identifier et de marquer des objets ou des scènes spécifiques dans la vidéo.
Test d'hallucination : Grâce à l'optimisation des stratégies d'entraînement, Tarsier2 réduit considérablement la possibilité que le modèle génère des informations erronées.
Support multilingue : Prend en charge la génération de descriptions vidéo dans plusieurs langues.
Cas d'utilisation de Tarsier :
Création de contenu : Tarsier peut aider les créateurs de contenu à générer des descriptions vidéo, améliorant l'accessibilité et le référencement (SEO) des vidéos.
Domaine éducatif : Dans les vidéos éducatives, Tarsier peut fournir des descriptions détaillées du contenu, aidant les étudiants à mieux comprendre les supports d'apprentissage.
Réseaux sociaux : Les plateformes sociales peuvent utiliser Tarsier pour générer des descriptions automatiques du contenu vidéo, améliorant ainsi l'expérience utilisateur.
Vidéosurveillance : Dans le domaine de la surveillance de sécurité, Tarsier peut analyser les flux vidéo et générer des descriptions en temps réel, aidant le personnel de sécurité à identifier rapidement les menaces potentielles.
Robotique : Générer des instructions détaillées étape par étape pour des tâches spécifiques.
Conduite autonome : Aider les véhicules à reconnaître les conditions routières et à faciliter la prise de décision.
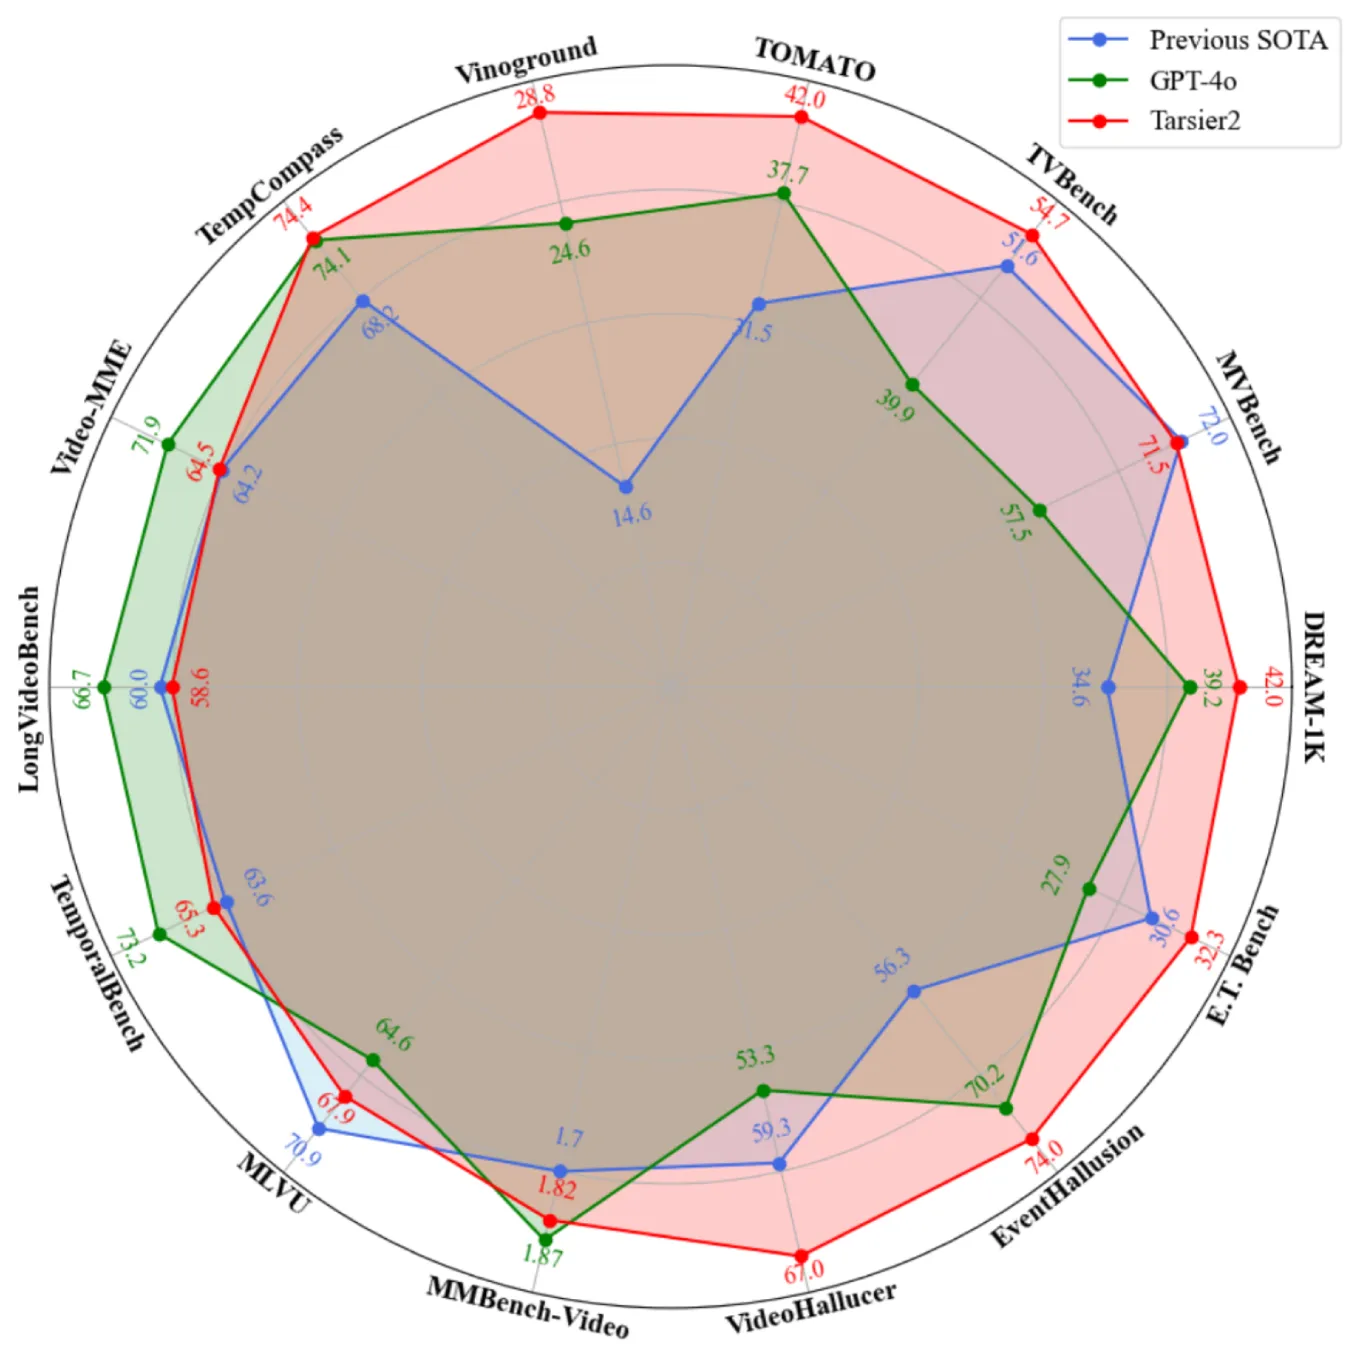
La dernière version du modèle Tarsier, Tarsier2, a apporté des améliorations significatives à plusieurs égards, notamment en termes de volume et de diversité des données. Les données de pré-entraînement sont passées de 11 millions à 40 millions de paires vidéo-texte, renforçant la capacité d'apprentissage du modèle. De plus, Tarsier2 a introduit un alignement temporel fin pendant la phase de fine-tuning supervisé, améliorant davantage la précision des descriptions vidéo et la capacité de capture des détails. Grâce à l'entraînement par optimisation directe des préférences (DPO), Tarsier2 est capable de générer des descriptions vidéo davantage alignées sur les préférences humaines, réduisant ainsi la possibilité de générer des hallucinations.
En termes d'évaluation des performances, Tarsier2 s'est distingué dans le benchmark DREAM-1K, avec un score F1 supérieur de 2,8 % à celui de GPT-4o et de 5,8 % à celui de Gemini-1.5-Pro. Sur 15 benchmarks publics, Tarsier2 a établi de nouveaux résultats de pointe, couvrant les questions-réponses vidéo, la localisation vidéo, les tests d'hallucination et les questions-réponses, démontrant sa polyvalence en tant que puissant modèle de langage vision généraliste.
Au-delà de la description vidéo, il démontre également de solides performances dans des tâches telles que les questions-réponses, le grounding et l'intelligence incarnée.
Article : https://arxiv.org/abs/2501.07888
Code : https://github.com/bytedance/tarsier
Dataset : https://huggingface.co/datasets/omni-research/DREAM-1K
Demo : https://huggingface.co/spaces/omni-research/Tarsier2-7b














