
 Asistente de guiones▸
 Apps AI
 Noticias AI
Kokoro TTS: un modelo TTS (texto a voz) de código abierto y alto rendimiento
Kokoro TTS: un modelo TTS (texto a voz) de código abierto y alto rendimientoIntroducción
Kokoro TTS es un modelo detexto a voz (TTS) de código abierto, ligero y de alto rendimiento, con 82 millones de parámetros, basado en la arquitectura StyleTTS 2. Ofrece síntesis de voz natural y de alta calidad, ideal para audiolibros, podcasts y más, convirtiéndose en un producto estrella en el campo de TTS.
Funciones de Kokoro TTS
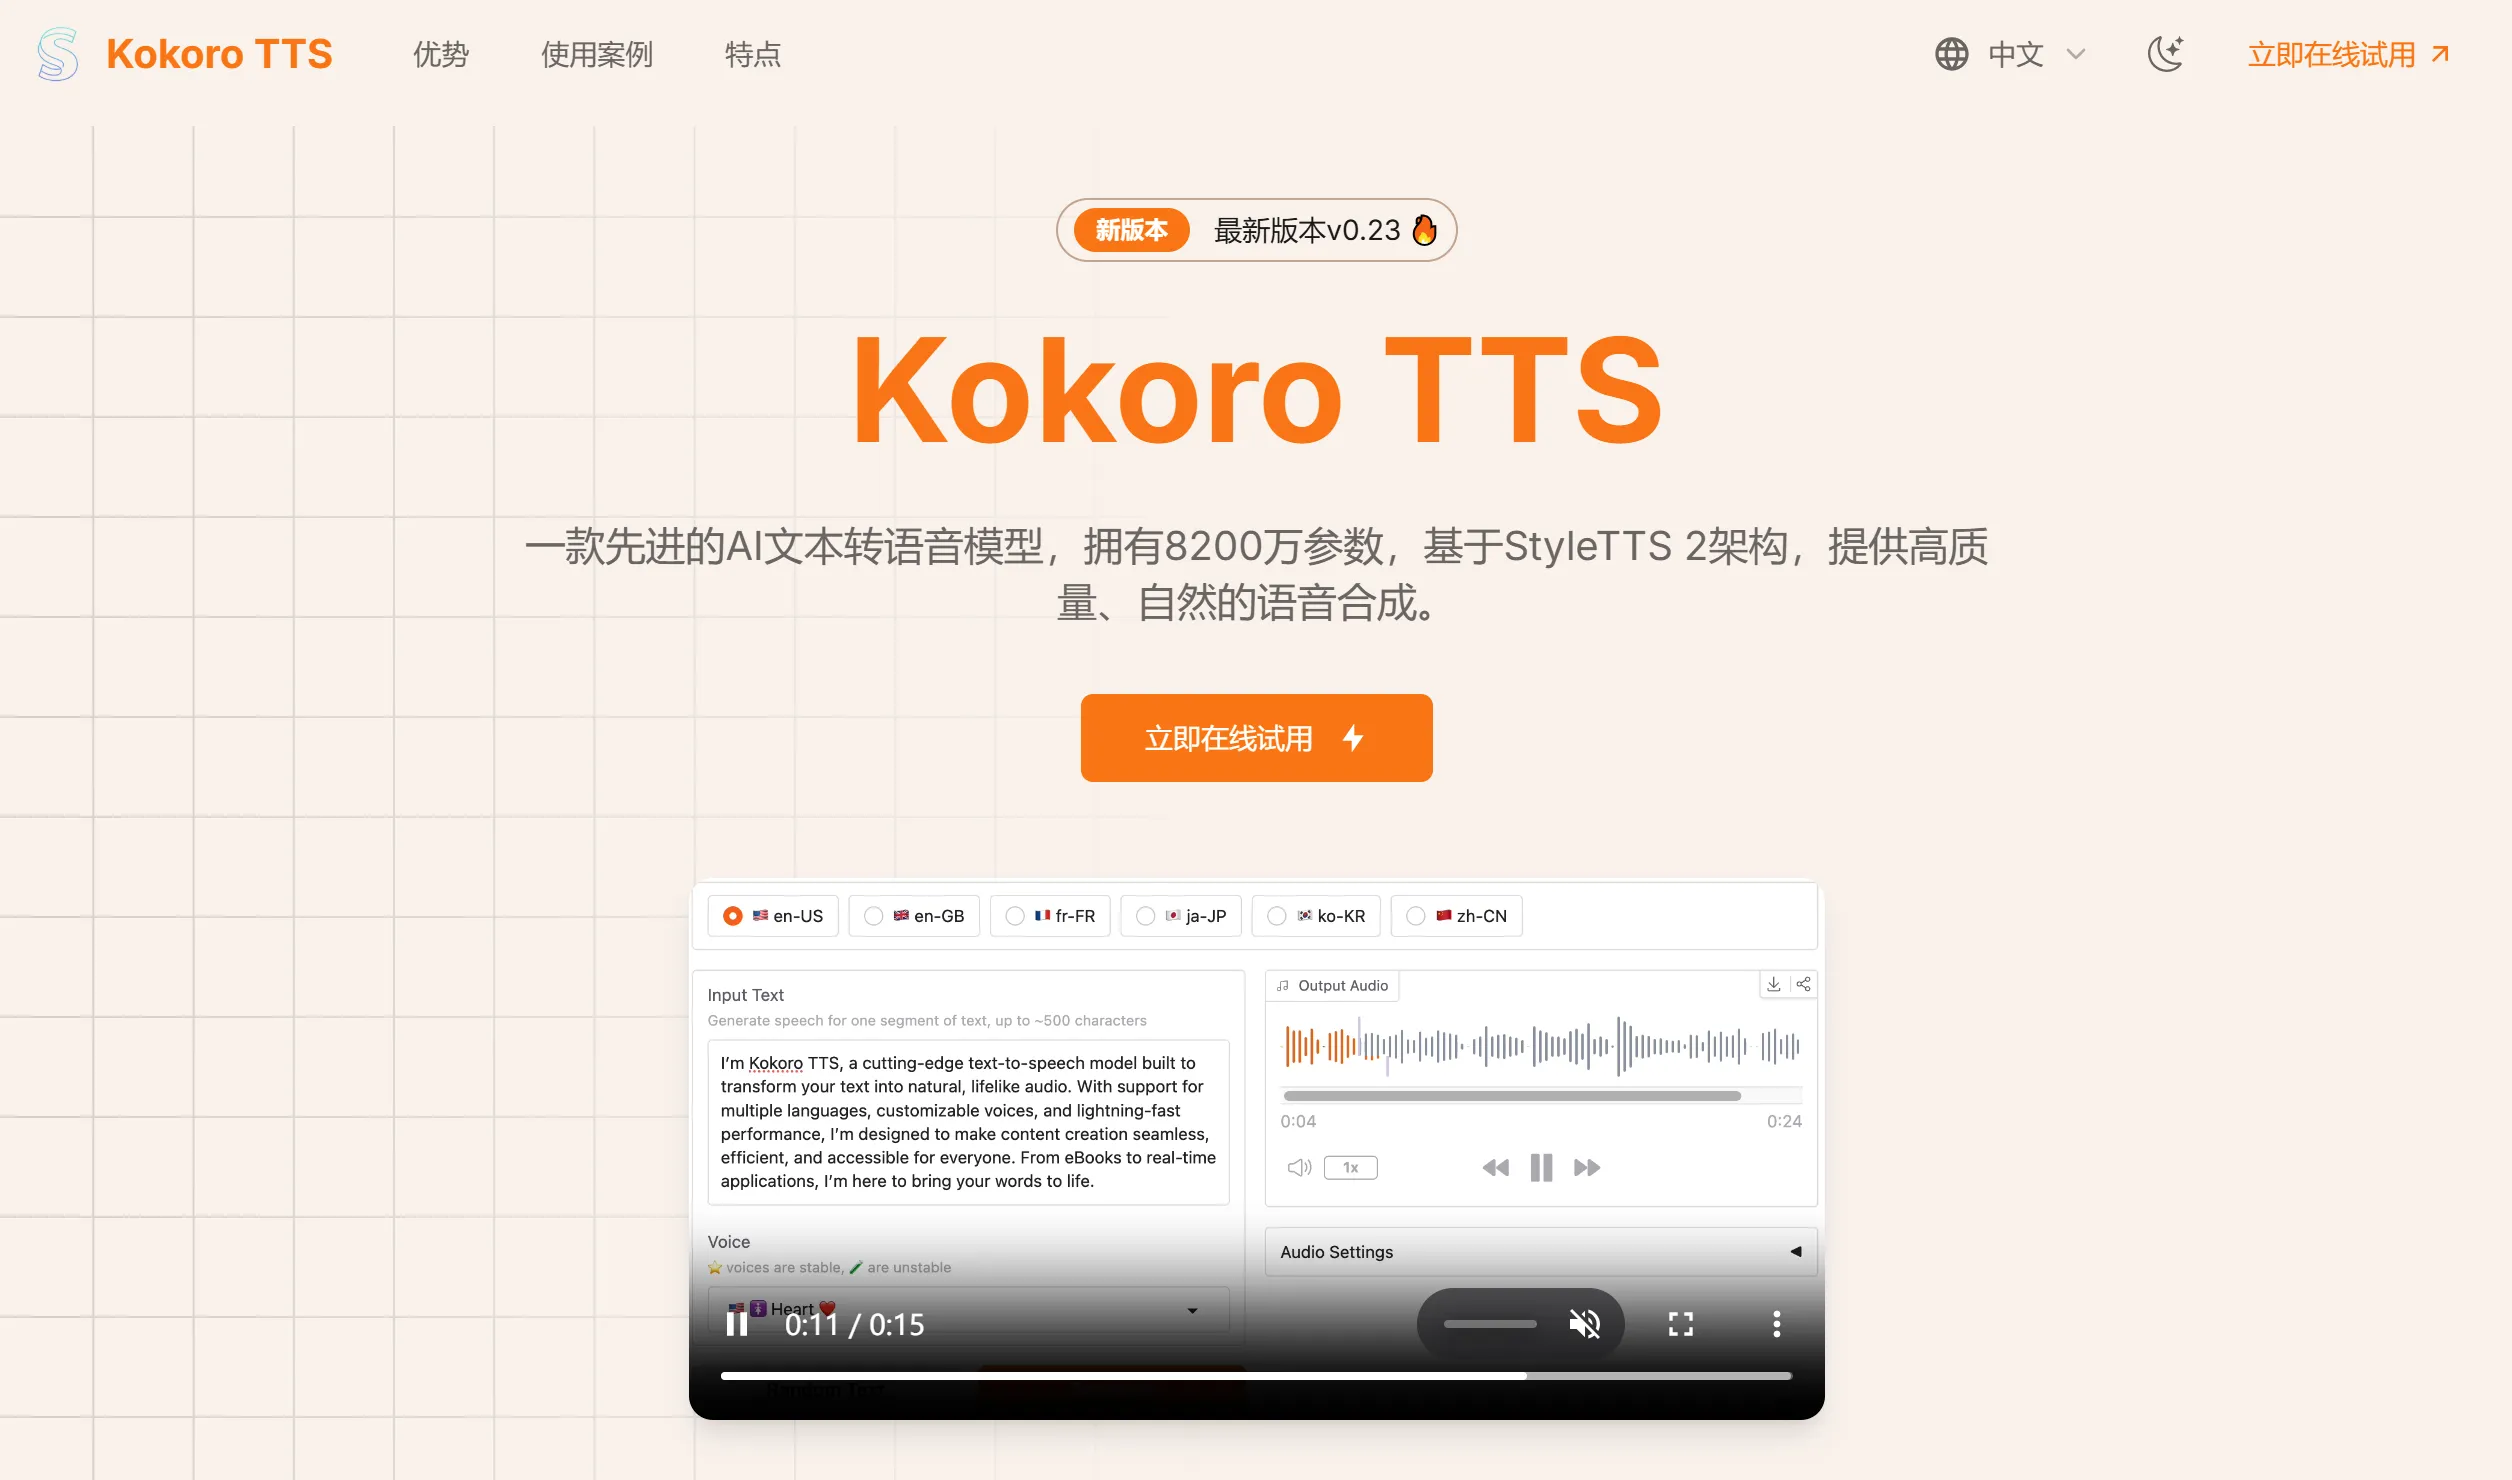
Síntesis de voz de alta calidad: Kokoro TTS puede convertir texto en voz natural y fluida, compatible con múltiples idiomas, incluyendo inglés americano y británico, francés, japonés, coreano y chino.
Soporte multilingüe: compatible con inglés americano, inglés británico, francés, coreano, japonés y mandarín, entre otros idiomas.
Diversidad de estilos de voz: Kokoro TTS no solo genera voz natural y fluida, sino que también admite estilos especiales como susurros, así como 10 paquetes de voz diferentes que abarcan distintos géneros y características.
Bajo consumo de recursos: con solo 82M de parámetros, Kokoro TTS consume menos recursos en comparación con muchos modelos TTS populares, lo que permite un funcionamiento eficiente en ordenadores convencionales.
Generación en tiempo real: Kokoro TTS admite la generación de voz en tiempo real, permitiendo a los usuarios obtener la salida de voz deseada al instante.
Soporte para múltiples formatos de entrada: estaherramienta admite varios formatos de entrada, incluidos archivos de texto y libros electrónicos (como EPUB).
Características principales de Kokoro TTS:
Ligereza y alto rendimiento
Con solo 82 millones de parámetros, Kokoro TTS, gracias a su arquitectura híbrida optimizada de StyleTTS 2 e ISTFTNet, alcanza una calidad de voz comparable a la de modelos grandes con miles de millones de parámetros (como MetaVoice y XTTS)37. Su diseño puramente decodificador elimina la estructura tradicional del codificador, reduciendo la complejidad computacional y logrando síntesis casi en tiempo real en CPU y procesamiento acelerado en GPU710.
Velocidad y eficiencia: velocidad de síntesis inferior a 100 ms, compatible con computación en el borde y despliegue en dispositivos de bajos recursos.
Soporte multilingüe: actualmente centrado en inglés (americano/británico), pero la arquitectura permite la futura expansión a chino, francés, japonés y otros idiomas.
Código abierto y uso comercial
Utiliza la licencia Apache 2.0, que permite el uso comercial gratuito y el desarrollo secundario, siendo adecuada para desarrolladores individuales e integración empresarial. La plataforma Hugging Face ofrece pesos del modelo y documentación de despliegue, reduciendo la barrera de entrada.
Estilos de voz diversos
Ofrece más de 10 paquetes de voz preentrenados (como Bella, Adam, Sarah), que abarcan diferentes géneros y acentos, y admite estilos especiales como susurros, mejorando la diversidad expresiva.
Ventajas técnicas de kokoroTTS:
Innovación arquitectónica:Combina el control de prosodia de StyleTTS 2 con la generación eficiente de espectros de ISTFTNet, sin depender de modelos de difusión, reduciendo el consumo de recursos computacionales mientras se mantiene una alta fidelidad de sonido.
Entrenamiento y cumplimiento de datos:Basado en un conjunto de datos seleccionado de 100 horas, con fuentes que incluyen audio de dominio público y contenido sintético conforme, garantizando la seguridad de los derechos de autor.
Flexibilidad de despliegue:Compatible con la optimización del tiempo de ejecución ONNX, se puede desplegar de forma local o en la nube, sin depender de una GPU, siendo compatible con herramientas como Docker y FastAPI, y ofreciendo una interfaz REST API.
Casos de uso de kokoroTTS:
Sistemas de interacción en tiempo real: como asistentes de voz y atención al cliente, aprovechando su baja latencia para ofrecer respuesta de voz instantánea710.
Creación de contenidos: audiolibros,locuciones para publicidad, generación de voz para personajes de juegos, con soporte para selección de tonos personalizados712.
Servicios de accesibilidad: ofrece soporte detexto a voz para usuarios con discapacidad visual, proporcionando servicios de lectura de texto que les ayudan a acceder a la información.
Educación y medios: explicaciones de cursos en línea, producción de podcasts, generación devídeos de formación multilingüe o contenido de audio educativo.
Juegos y realidad virtual: en aplicaciones de juegos y realidad virtual, Kokoro TTS puede proporcionar voz natural para los personajes.
Conversión de libros electrónicos en audiolibros con Kokoro: convierta fácilmente su biblioteca de libros electrónicos en audiolibros de alta calidad; incluso con títulos poco conocidos, las voces naturales y multilingües de Kokoro pueden lograrlo.
Inicio rápido
Descárguelo desdeGithub e instale las dependencias mediante pip o npm;
Clone el modelo Kokoro TTS desde Hugging Face y cargue el paquete de voz;
Llame a la API para generar audio de 24 kHz, compatible con ejecución local o en dispositivos de borde.
Gracias a su código abierto y su licencia comercial favorable, Kokoro TTS tiene una ventaja competitiva en el mercado, especialmente en aplicaciones comerciales que requieren síntesis de voz de alta calidad.
Noticias relacionadas:
llasa 3B TTS: modelo de texto a voz (TTS) basado en la arquitectura LLaMA
Recomendación de 10 excelentes modelos de voz TTS de código abierto
Seed-TTS: modelo TTS de texto a voz de alta calidad desarrollado por ByteDance














