
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten

DeepSeek Coder: Open-Source-Codegenerierungs-LLM von DeepSeek
DeepSeek Coder: Open-Source-Codegenerierungs-LLM von DeepSeekEinführung
DeepSeek Coder ist eine Reihe von quelloffenen Large Language Models zur Codegenerierung, die vom chinesischen KI-Unternehmen DeepSeek (深度求索) veröffentlicht wurde. Durch Deep-Learning-Technologien verbessert sie die Fähigkeit zur Codegenerierung und zum Codeverständnis, steigert die Programmier-Effizienz von Entwicklern und erreicht in mehreren Benchmarks eine Leistung, die mit der gängiger Closed-Source-Modelle gleichzieht oder diese übertrifft.
1. Modellarchitektur und Kerntechnologien
Mixture-of-Experts-Architektur (MoE)
DeepSeek Coder V2 verwendet eine MoE-Architektur mit insgesamt 236B Parametern und 21B aktivierten Parametern. Durch die dynamische Auswahl von Expertennetzwerken wird die Aufgabenadaption verbessert. Die Trainingsdaten decken 338 Programmiersprachen ab (erweitert von 86 in V1) und unterstützen ein Kontextfenster von 128K, wodurch komplexe Code-Repositorys und lange Textaufgaben verarbeitet werden können.
Innovative Trainingsmethoden
Fill-In-Middle (FIM): Durch zufälliges Aufteilen des Codes in Präfix (Prefix), Mitte (Middle) und Suffix (Suffix) wird das Modell darauf trainiert, die fehlenden mittleren Teile zu ergänzen, wodurch die Fähigkeit zur Codevervollständigung gestärkt wird.
Repo-Level Pre-Training: Auf Basis der Abhängigkeiten in Code-Repositorys wird ein Datensatz erstellt, der mithilfe topologischer Sortierung die Abhängigkeiten zwischen Dateien berücksichtigt und so die projektweite Codegenerierungsfähigkeit verbessert.
Optimierung durch Reinforcement Learning
Der GRPO-Algorithmus (Group Relative Policy Optimization) wird eingesetzt, um die Ausgaben an menschliche Präferenzen anzupassen, kombiniert mit Compiler-Feedback und Testfällen zur Optimierung der Code-Korrektheit.
2. Leistung und Benchmarks
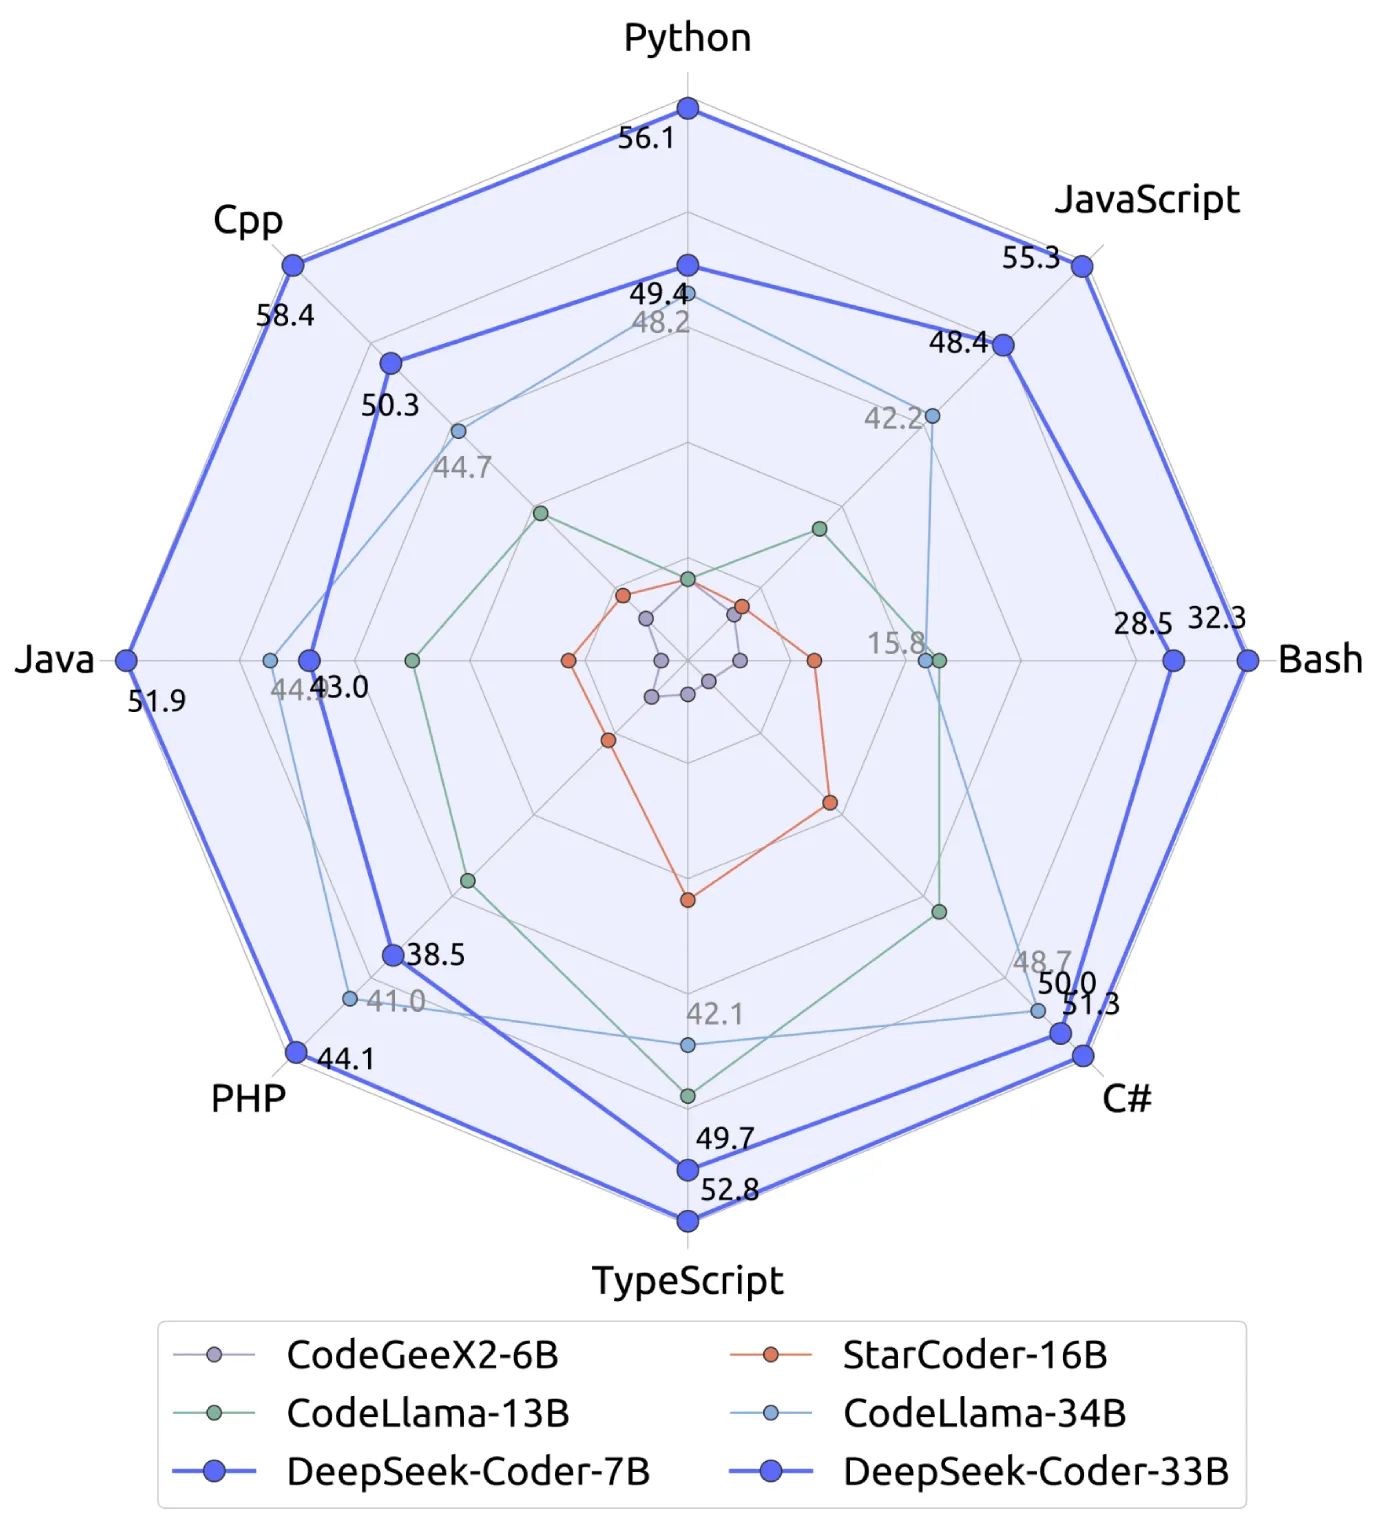
Fähigkeit zur Codegenerierung
Im HumanEval-Benchmark erreicht DeepSeek Coder V2 eine Genauigkeit von 90,2 % und übertrifft damit GPT-4-Turbo und Claude 3 Opus8.
Bei SWEBench (Benchmark für komplexe Code-Aufgaben) ist es das erste Mal, dass ein Open-Source-Modell einen Wert von über 10 % erzielt.
Unterstützt mehrsprachige Generierung in 338 Sprachen wie Python, Java und Rust, mit einer um 20 % höheren Generierungsgeschwindigkeit als GPT-4.
Mathematik und Reasoning
In Mathe-Wettbewerbs-Benchmarks wie MATH und aiME ist die Leistung vergleichbar mit GPT-4o und Gemini 1.5 Pro.
Durch Chain-of-Thought (COT) wird die Fähigkeit zur Lösung komplexer Probleme deutlich verbessert.
Allgemeine Sprachverarbeitung
Im MMLU-Benchmark (Multitask Language Understanding) erreicht es 79,2 % und behält damit eine mit allgemeinen Modellen (wie DeepSeek-V2) vergleichbare Generalisierungsfähigkeit.
3. Entwickler-Ökosystem und Anwendungsszenarien
Open Source und niedrige Kosten
Modell, Code und technischer Bericht sind vollständig quelloffen (MIT-Lizenz) und unterstützen kostenfreie kommerzielle Nutzung sowie Weiterentwicklung.
Die API-Preise sind äußerst wettbewerbsfähig: Eingabekosten von nur 0,27 USD pro Million Tokens (bei Cache-Hit nur 0,07 USD), weit unter den 18 USD von GPT-4.
Integration und Bereitstellung
Bereitstellung vortrainierter Modelle auf Hugging Face sowie lokaler Privatdeployments, mit Unterstützung für den Betrieb auf einer einzelnen Maschine mit 880 GB GPU-Speicher oder einer Lite-Version (V2-Lite) mit nur 40 GB auf einer einzelnen GPU.
Integration in Entwicklungs-Tool-chains (wie das vLLM-Framework), Optimierung des Sparse-Attention-Mechanismus zur Reduzierung des Speicherverbrauchs und Steigerung der Inferenzgeschwindigkeit.
Anwendungsfälle
Automatisierte Code-Reviews: Erkennung von Code-Schwachstellen und Vorschläge zur Optimierung, wodurch der Entwicklungszyklus beschleunigt wird.
API-Erstellung: Automatische Generierung von RESTful-Diensten, GraphQL-Queries usw., wodurch das Schreiben von Boilerplate-Code reduziert wird.
Machine-Learning-Projekte: Generierung von Daten-Pipelines und Algorithmus-Code zur Unterstützung durchgängiger KI-Entwicklung.
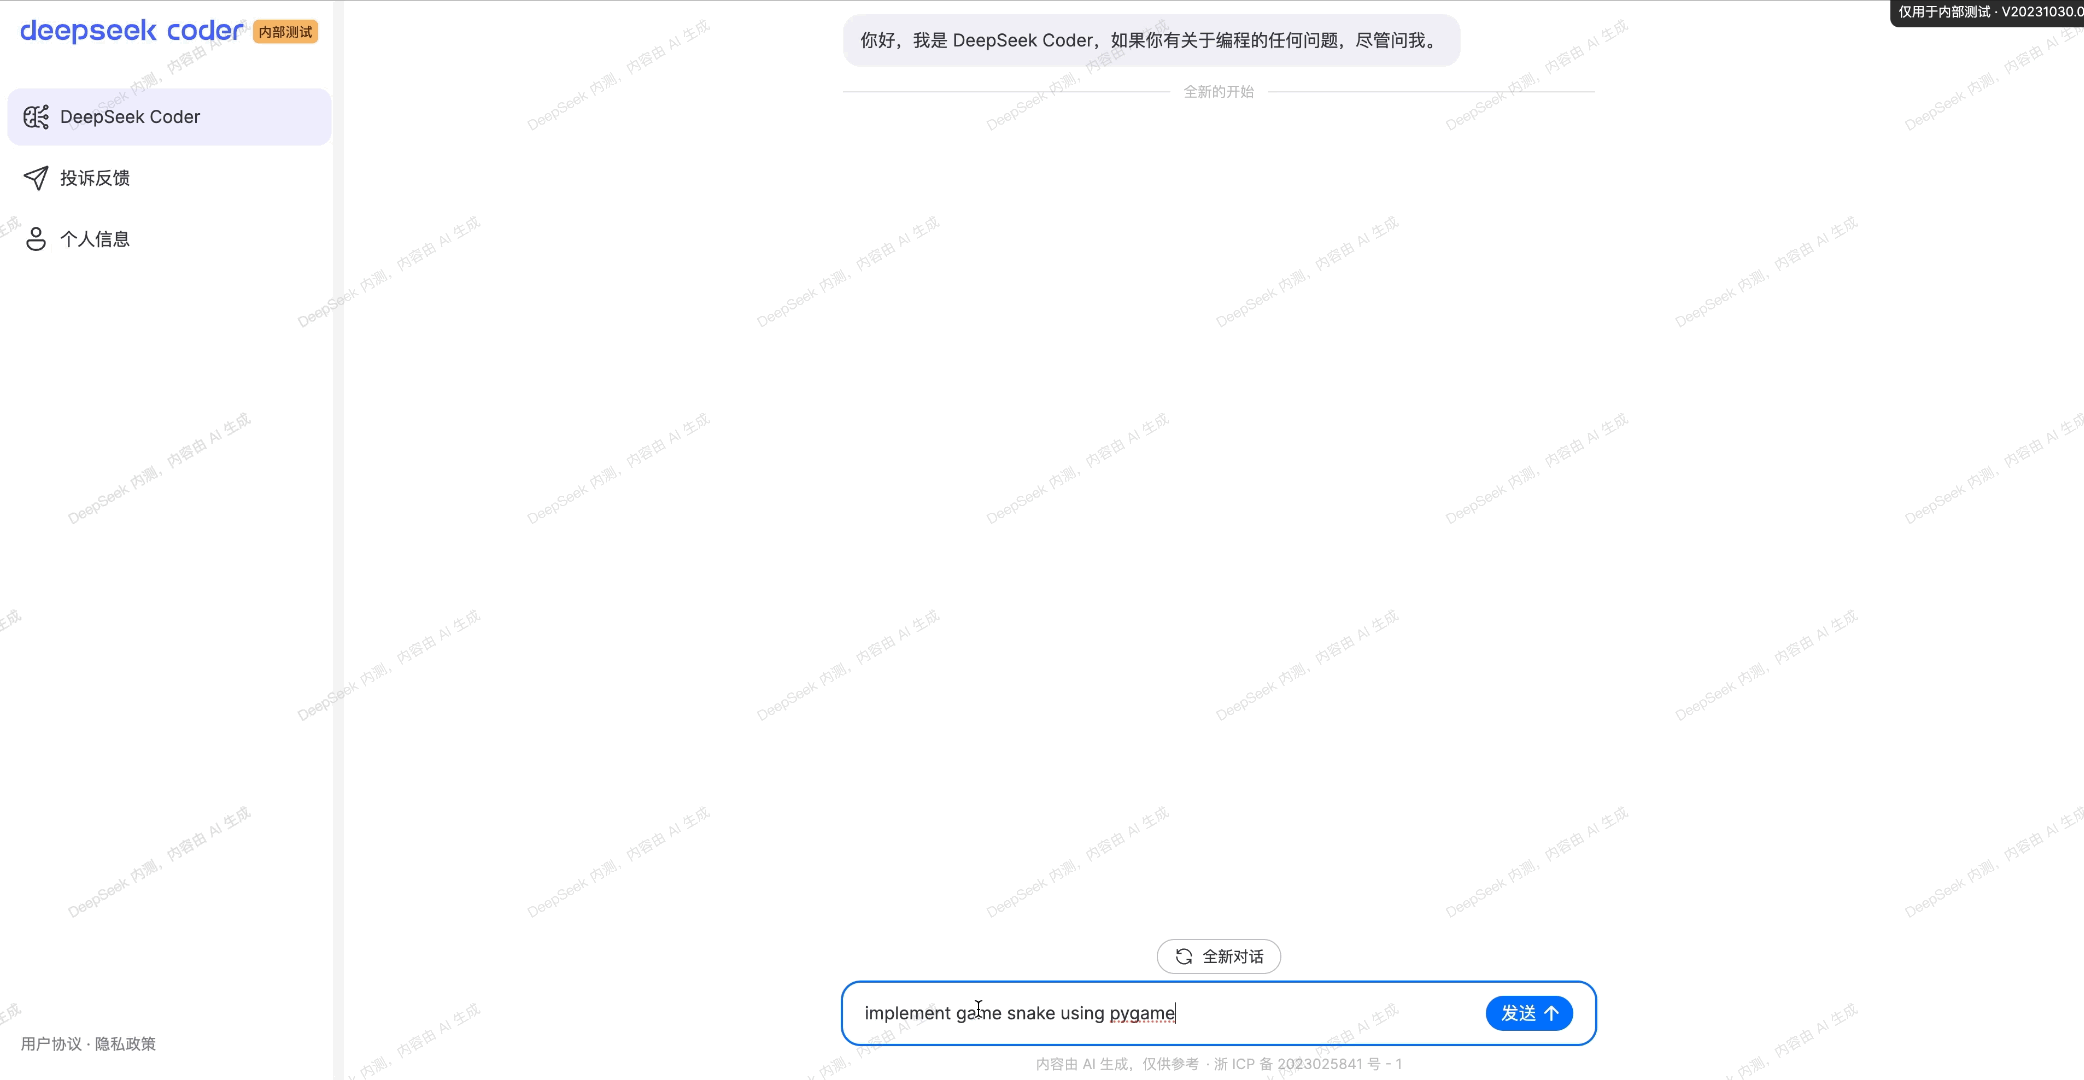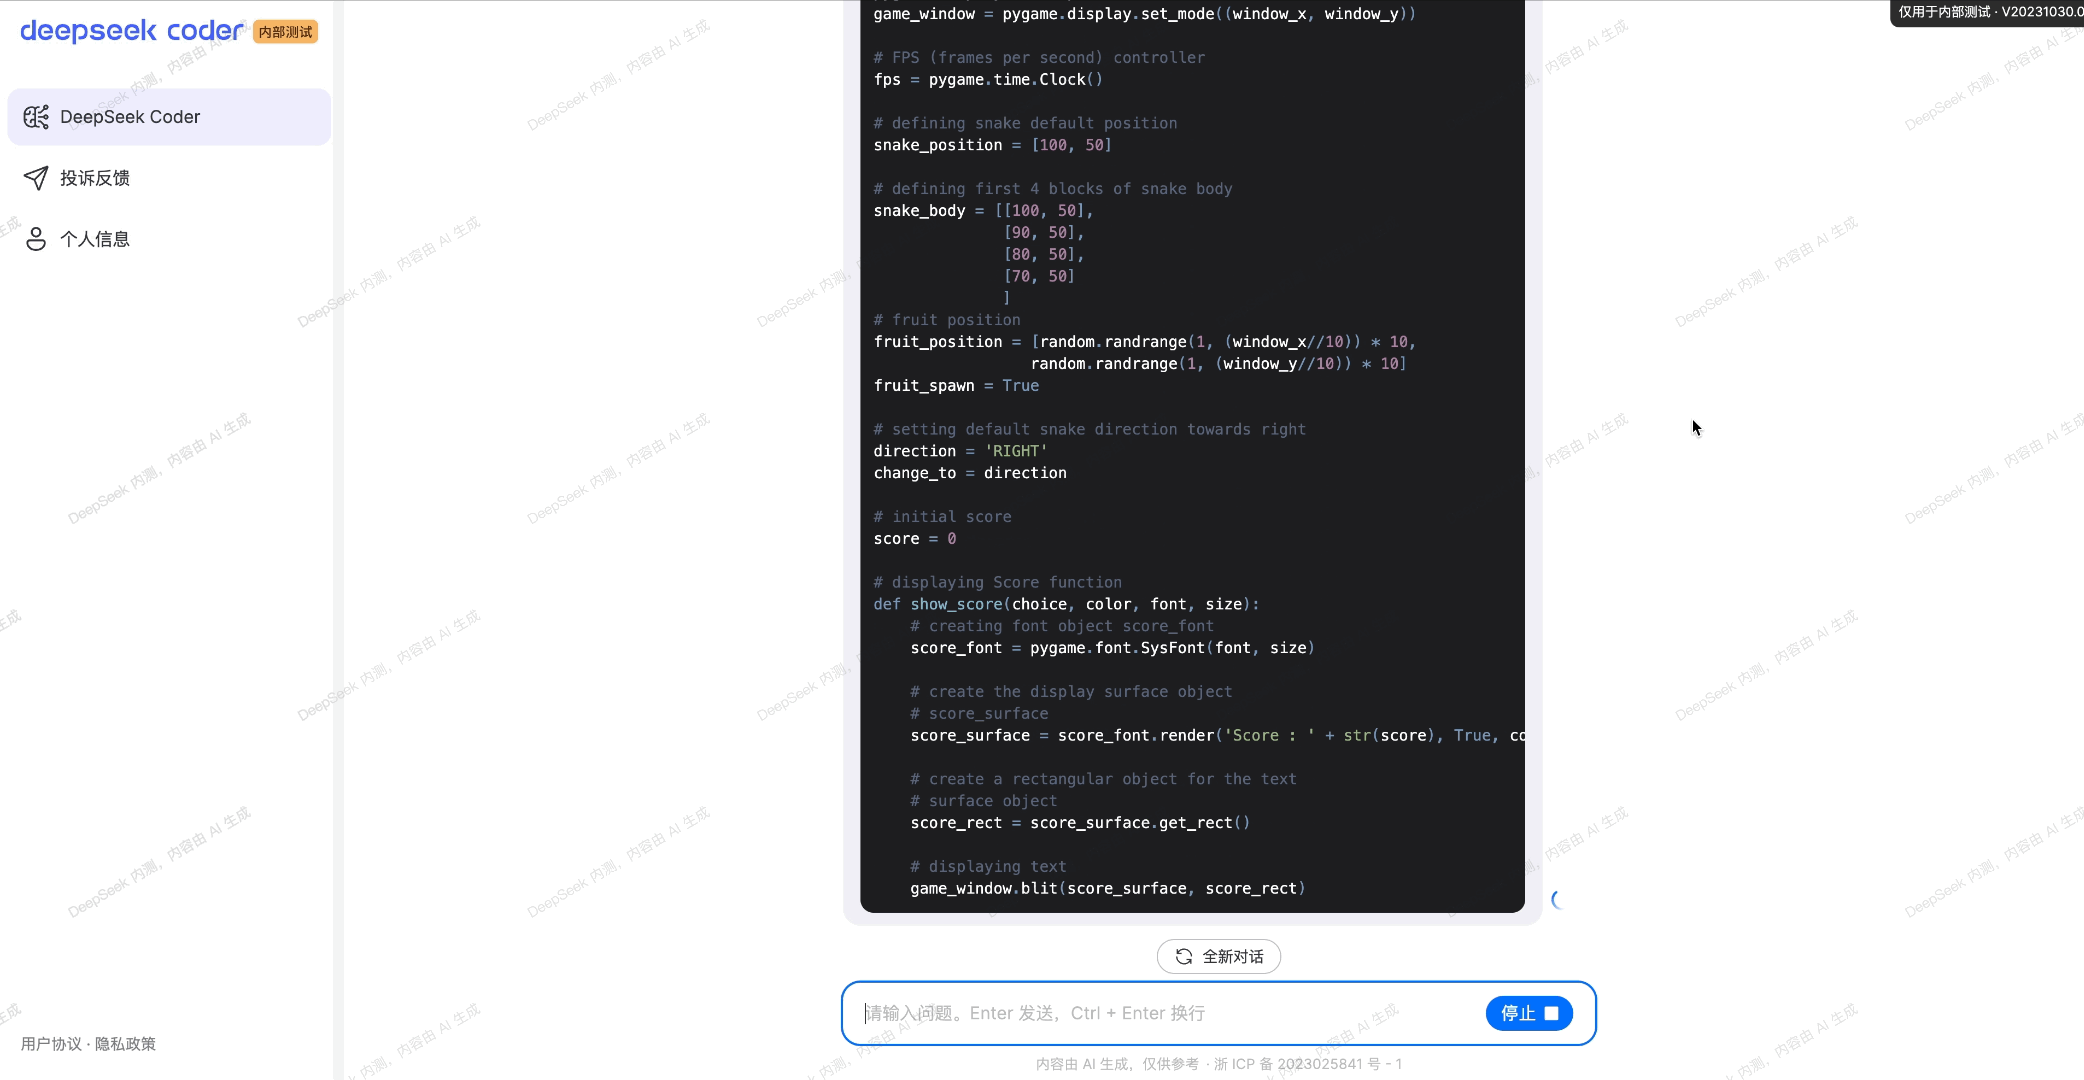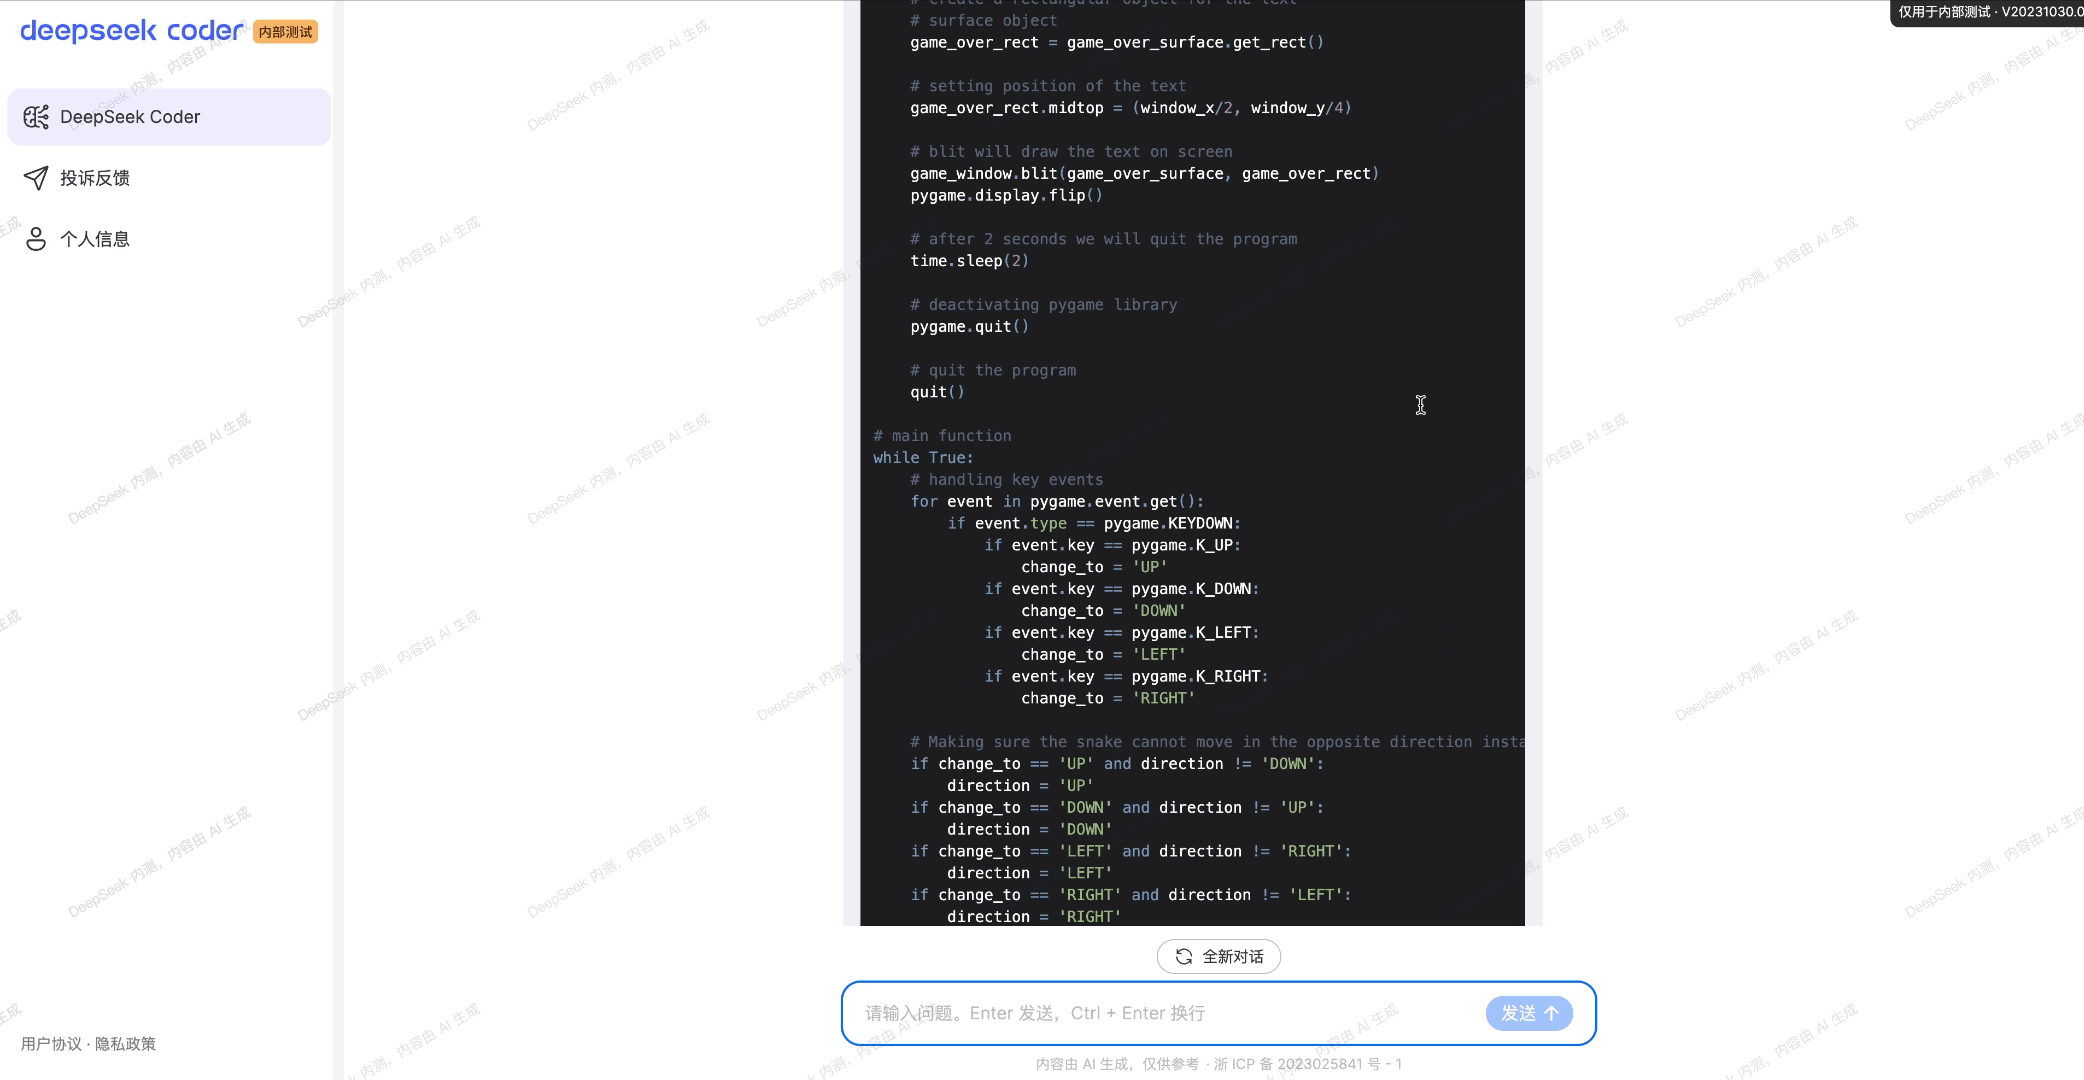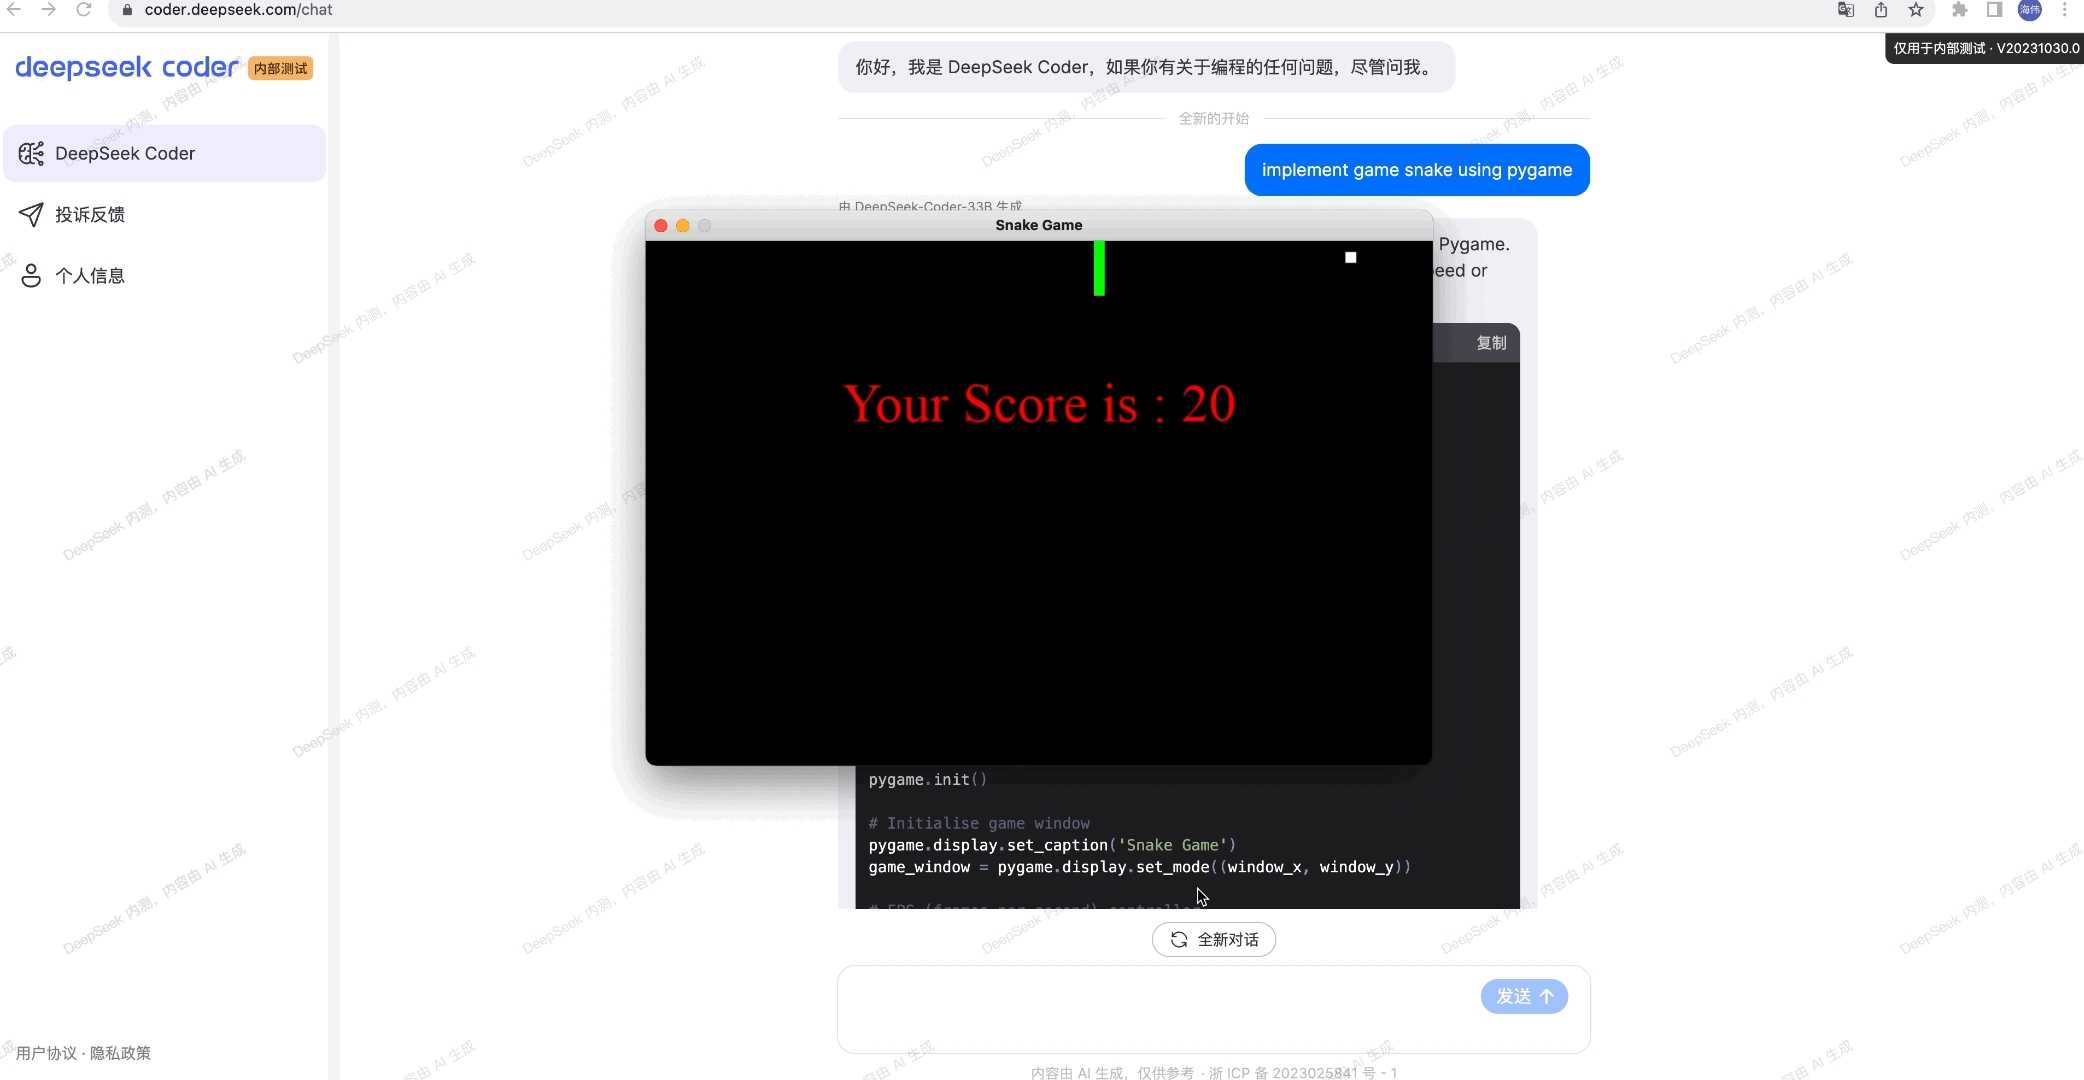
DeepSeek Coder kann breit in der Softwareentwicklung, Datenanalyse und automatisierten Tests eingesetzt werden. Es generiert nicht nur Code, sondern beantwortet auch programmierrelevante Fragen und hilft Entwicklern so, ihre Arbeitseffizienz zu steigern.
Mit technologischen Innovationen (wie der MoE-Architektur und dem FIM-Training) sowie einem offenen Ökosystem definiert DeepSeek Coder die Leistungsgrenzen von Codegenerierungsmodellen neu. Sein hervorragendes Preis-Leistungs-Verhältnis, die breite Sprachunterstützung und die Fähigkeit zur Bearbeitung projektweiter Code-Kontexte machen es zu einem zentralen Werkzeug für effizienteres Entwickeln und fördern gleichzeitig die Zusammenarbeit und den Fortschritt der globalen Open-Source-KI-Community. Mit künftigen multimodalen und noch größeren Modellen könnte DeepSeek zum Maßstab in der Codegenerierung im AGI-Zeitalter werden.
GitHub-Repository:https://github.com/deepseek-ai/DeepSeek-Coder












