
 Asistente de guiones▸
 Apps AI
 Noticias AI
ToucanTTS: modelo multilingüe a gran escala que cubre más de 7.000 idiomas
ToucanTTS: modelo multilingüe a gran escala que cubre más de 7.000 idiomasIntroducción
ToucanTTS, un conjunto de herramientas para la síntesis de voz más avanzada, un modelo de texto a voz (Text-to-Speech, TTS) extremadamente completo creado por el Instituto de Procesamiento de Lenguaje Natural (IMS) de la Universidad de Stuttgart. ToucanTTS cubre un gran modelo multilingüe con más de 7.000 idiomas.
ToucanTTS no solo admite múltiples idiomas, sino que también ofrece síntesis de voz con múltiples hablantes, capaz de imitar el ritmo, el acento y la entonación de diferentes hablantes.
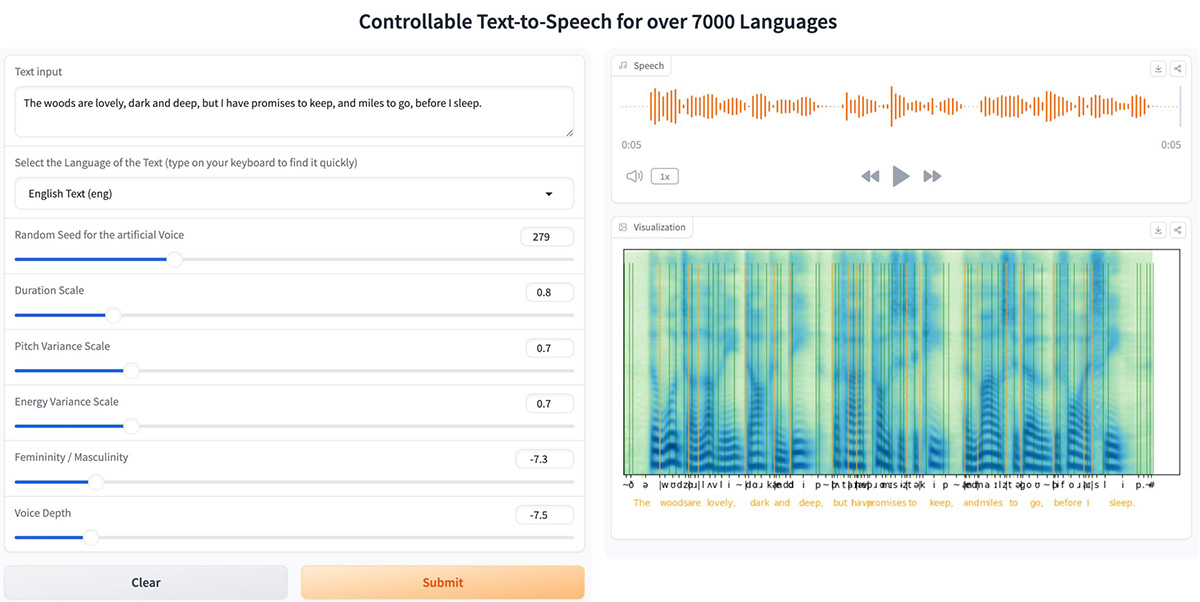
También ofrece demostraciones interactivas para diversas aplicaciones, incluyendo diseño de voz, clonación de estilos, síntesis de voz multilingüe y lectura editada manualmente de poesía, mostrando su versatilidad y potente rendimiento.
Funciones de ToucanTTS:
Soporte multilingüe: ToucanTTS puede sintetizar voz en más de 7.000 idiomas, lo que lo convierte en el modelo TTS con mayor cantidad de idiomas disponibles. Este amplio soporte lingüístico satisface a una audiencia internacional diversa.
Síntesis de voz con múltiples hablantes: ToucanTTS permite la síntesis de voz con múltiples hablantes, permitiendo a los usuarios imitar el ritmo, el acento y la entonación de diferentes hablantes. Es particularmente útil para aplicaciones que requieren diversidad de estilos y personalización de voz.
Edición colaborativa humano-máquina: ToucanTTS permite a los usuarios personalizar la voz sintetizada para cumplir con requisitos específicos, siendo especialmente útil para estudios literarios y tareas de lectura de poesía.
Arquitectura: ToucanTTS está basado en la arquitectura FastSpeech 2, con mejoras inspiradas en PortaSpeech. Incluye un PostNet basado en flujo normalizador y un alineador independiente entrenado con clasificación temporal conexionista (CTC) y reconstrucción de espectrogramas, logrando una síntesis de voz de alta calidad y sonido natural.
Representación articulatoria: una característica única de ToucanTTS es el uso de la representación articulatoria de los fonemas como entrada. Aprovechando los datos multilingües, se mejora la calidad y disponibilidad de la síntesis de voz para idiomas con pocos recursos.
Demostraciones interactivas: ToucanTTS ofrece demostraciones interactivas para diversas aplicaciones, como diseño de voz, clonación de estilos, síntesis de voz multilingüe y lectura de poesía editada manualmente. Estas demostraciones muestran la versatilidad y solidez del kit de herramientas.
Entrenamiento e inferencia: el kit de herramientas proporciona instrucciones completas sobre la instalación de dependencias, configuración del almacenamiento, descarga de modelos preentrenados y ejecución de pipelines de entrenamiento. Admite tanto el ajuste fino a partir de modelos preentrenados como el entrenamiento desde cero.
Características de ToucanTTS:
Soporte multilingüe y multihablante: A través de un modelo preentrenado multilingüe a gran escala, admite la síntesis de voz multilingüe que abarca más de 7.000 idiomas. Logra la síntesis de voz con múltiples hablantes y clona la prosodia como el ritmo, el acento y la entonación a través de los hablantes.
Edición colaborativa humano-máquina: Permite la edición colaborativa humano-máquina de la voz sintetizada, por ejemplo, para recitación de poesía y estudios literarios.
Demostraciones interactivas: Ofrece demostraciones interactivas de síntesis de voz multilingüe a gran escala, clonación de estilos entre hablantes, diseño de voz y recitación de poesía editada manualmente.
Arquitectura y componentes: Basado principalmente en la arquitectura FastSpeech 2, con algunas modificaciones, como un PostNet basado en flujo normalizador inspirado en PortaSpeech. Incluye un alineador autocontenido entrenado con CTC y reconstrucción de espectrogramas para diversas aplicaciones. Proporciona modelos preentrenados multilingües, alineador, funciones de embedding, vocoder y GAN de embedding.
Facilidad de uso: Construido completamente en Python y PyTorch, diseñado para ser simple y apto para principiantes, sin dejar de ser potente.
Representación articulatoria: El sistema IMS Toucan toma la representación articulatoria de los fonemas como entrada, permitiendo que los datos multilingües beneficien a los idiomas con pocos recursos.
Aplicaciones de ToucanTTS:
Síntesis de voz para aplicaciones multilingües: ToucanTTS admite más de 7.000 idiomas, lo que resulta muy ventajoso para crear aplicaciones multilingües, como plataformas globales de atención al cliente, herramientas educativas y funciones de asistencia para personas que no son hablantes.
Diseño y personalización de voz: la capacidad de síntesis de voz con múltiples hablantes permite crear voces personalizadas que pueden usarse en diversas aplicaciones, como asistentes virtuales, audiolibros y mensajes de marketing personalizados.
Edición colaborativa humano-máquina: esta función es particularmente útil en estudios literarios y tareas de lectura de poesía, donde se requiere un control preciso de la salida de voz para cumplir con requisitos estilísticos específicos.
¿Cómo usar ToucanTTS?
Con unos simples pasos, puedes comenzar a usar ToucanTTS.
1. Descargar desde GitHub
Descarga el código desde GitHub. git clone https://github.com/2noise/ToucanTTS descarga ToucanTTS
2. Instalar dependencias
Antes de comenzar, asegúrate de tener instalados los paquetes necesarios. Necesitarás torch y ToucanTTS. Si aún no están instalados, puedes instalarlos usando pip:
3. Importar las bibliotecas necesarias
Importa las bibliotecas necesarias para tu script. Necesitarás torch, ToucanTTS y Audio de IPython.display.
4. Inicializa ToucanTTS, crea una instancia de la clase ToucanTTS y carga el modelo preentrenado.
5. Prepara el texto, define el texto que deseas convertir en voz. Reemplaza
6. Genera la voz, usa el método infer para generar voz a partir del texto. Establece use_decoder=True para habilitar el decodificador.
7. Reproducir el audio
Usa la clase Audio de IPython.display para reproducir el audio generado. Establece la frecuencia de muestreo en 24.000 Hz y habilita la reproducción automática.
8. Completar el script
Enlace GitHub de ToucanTTS: https://github.com/DigitalPhonetics/IMS-Toucan
Enlace de demostración en línea: https://huggingface.co/spaces/Flux9665/MassivelyMultilingualTTS
Enlace del conjunto de datos: https://huggingface.co/datasets/Flux9665/BibleMMS














