
 Помощник сценариста▸
 AI Приложения
 AI Новости
Story-Iter: решение для визуализации длинных историй от UCSC-VLAA
Story-Iter: решение для визуализации длинных историй от UCSC-VLAAОписание
Что такое Story-Iter?
Story-Iter — это решение для визуализации длинных историй, предложенное UCSC-VLAA. Эта задача требует генерации связных последовательностей изображений на основе нарративного текста, поддерживая длинные сюжетные сцены до 100 кадров.
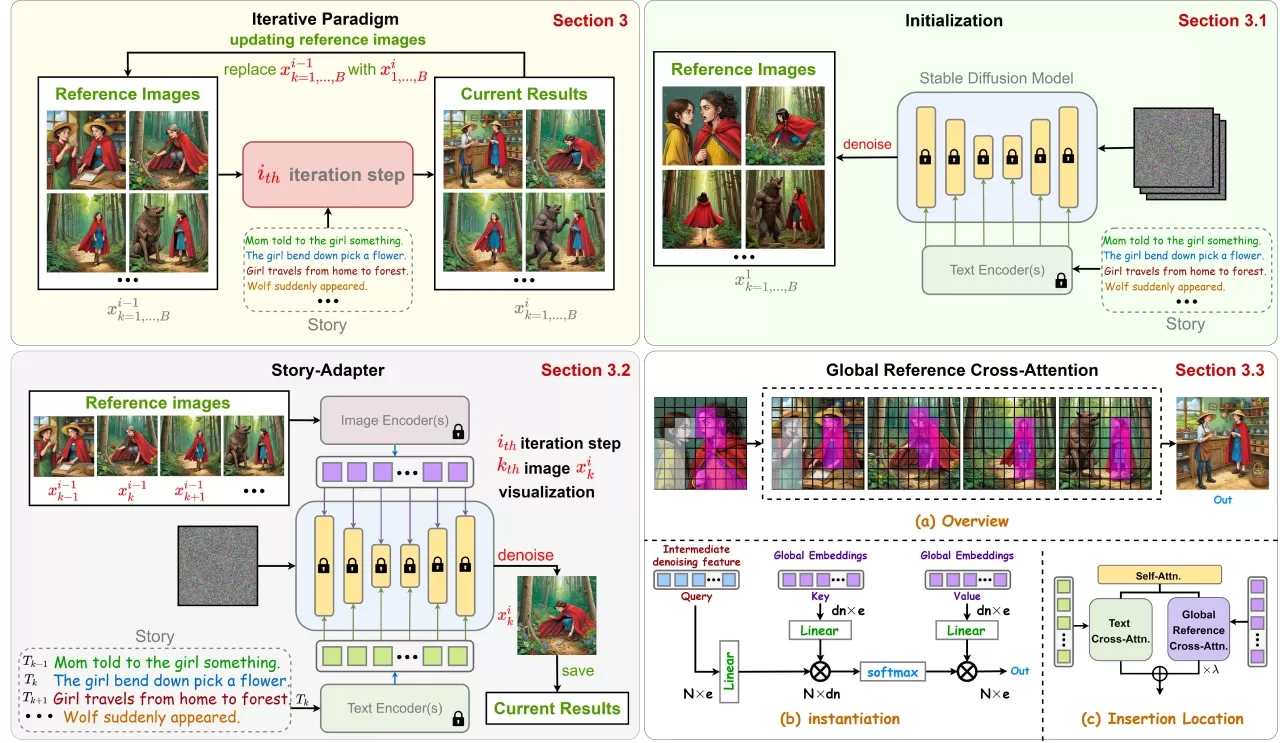
В отличие от авторегрессионных методов, Story-Iter использует внешний итерационный механизм: помимо шагов денойзинга внутри диффузионной модели, вводится дополнительный итерационный цикл, который оптимизирует качество каждого кадра за счёт постоянной интеграции всех референсных изображений, сгенерированных на предыдущем раунде.
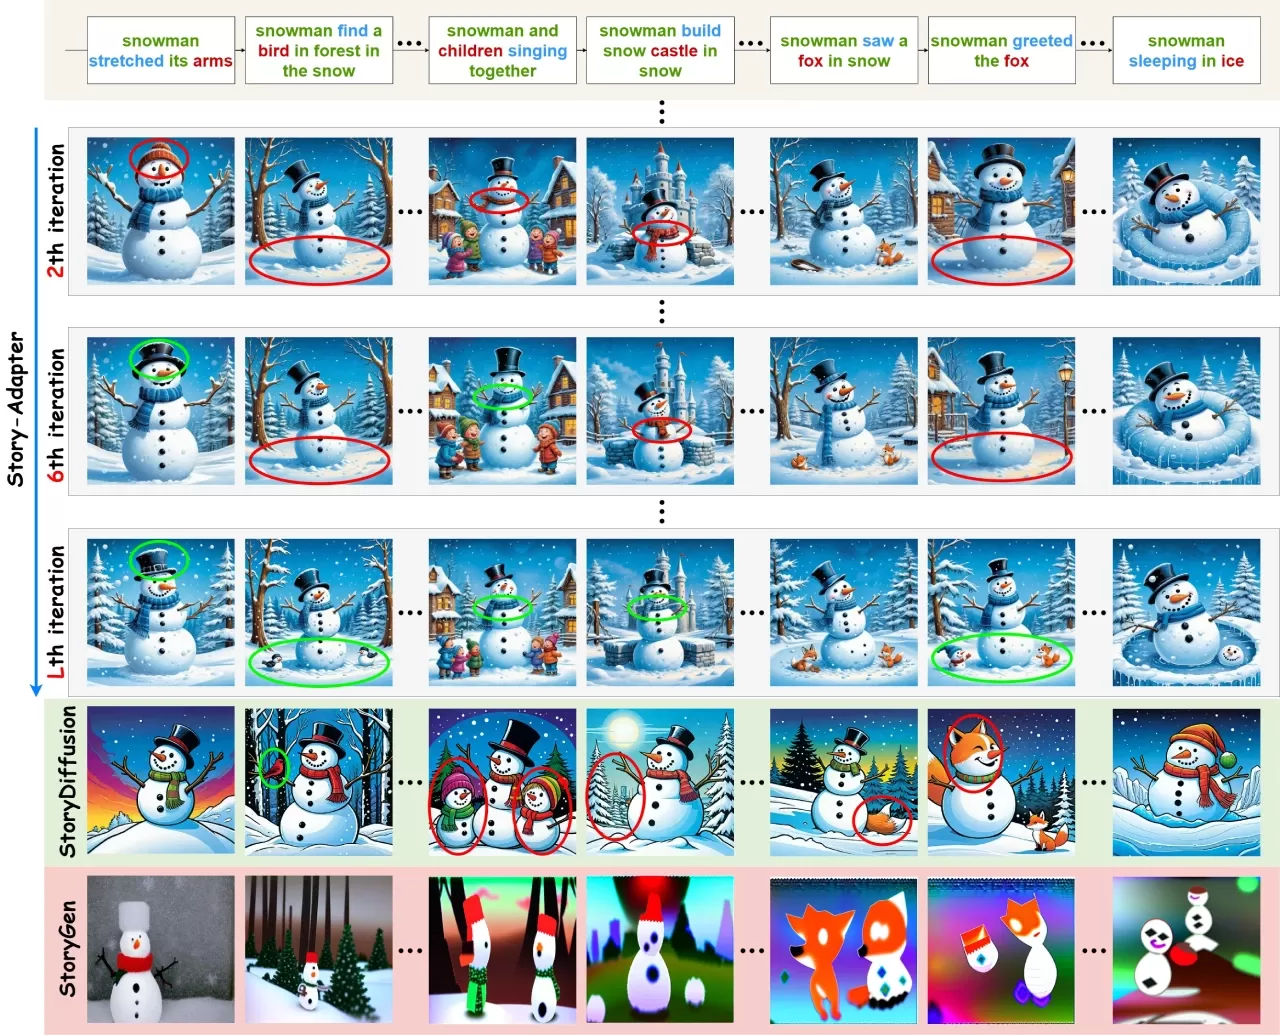
🔧 Функциональные особенности Story-Iter
1. Модуль глобальной референсной кросс-внимания
Plug-and-play: не требует обучения, напрямую интегрируется в существующие диффузионные модели (например, Stable Diffusion)
Глобальная эмбеддинг: использует глобальные эмбеддинги для моделирования всех референсных кадров, обеспечивая семантическую согласованность длинных последовательностей
Механизм кросс-внимания: агрегирует информационные потоки всех референсных изображений в процессе генерации изображений
2. Парадигма итерационной оптимизации
Этап инициализации: генерация начальной версии изображения каждого кадра на основе текстовых подсказок сюжета
Итерационное уточнение: все изображения, сгенерированные на предыдущем раунде, используются как референсы для следующего раунда с постепенной оптимизацией
Прогрессивное улучшение: точная генерация с тонкими взаимодействиями за счёт многократной интеграции общего визуального контекста и текстовых ограничений
3. Поддержка длинных последовательностей
Поддержка генерации последовательностей изображений длинных историй до 100 кадров
Превосходные результаты в семантической согласованности и тонких взаимодействиях
🎯 Сценарии применения Story-Iter
Генерация комиксов/иллюстрированных книг: автоматическая генерация связных страниц комиксов на основе длинных сюжетных текстов
Превизуализация анимации: предоставление визуальных превью уровня раскадровки для производства анимации
Раскадровка фильмов: помощь режиссёрам и операторам в быстрой генерации эскизов кадров
Детские книги: создание богато иллюстрированных нарративных книг для образовательного контента
Рекламные креативы: генерация длинных последовательностей визуальных историй для продвижения продуктов
Игровые кат-сцены: генерация непрерывных визуальных нарративов для игровых сюжетов
✅ Преимущества и недостатки Story-Iter
Преимущества
Без обучения: не требует дополнительного обучения или дообучения модели, plug-and-play
Вычислительная эффективность: более низкие вычислительные затраты по сравнению с методами, использующими крупные мультимодальные энкодеры
Гарантия согласованности: эффективное поддержание согласованности персонажей, сцен и стиля в длинных последовательностях через механизм глобальных референсов
Тонкие взаимодействия: возможность генерации высококачественных сцен со сложными взаимодействиями персонажей
Масштабируемость: поддержка генерации историй длиной до 100 кадров, что значительно превосходит традиционные методы
Недостатки
Затраты на итерации: хотя обучение не требуется, итерационный процесс требует многократных инференсов, что влечёт высокие временны́е затраты
Зависимость от базовой модели: производительность ограничена возможностями базовой диффузионной модели (например, SD)
Проблемы длинных историй: несмотря на поддержку 100 кадров, в очень длинных историях всё ещё возможен дрейф согласованности
Нет официального кода: в настоящее время репозиторий GitHub может быть ещё не полностью открыт или находится на ранней стадии
🛠️ Как использовать Story-Iter
Подготовка среды
# 克隆仓库(假设已公开)
git clone https://github.com/UCSC-VLAA/story-iter.git
cd story-iter
# 安装依赖
pip install -r requirements.txt
Базовый процесс использования
Подготовка текста истории: разбейте историю на последовательные текстовые описания (каждый кадр соответствует одному описанию)
Инициализация генерации: запустите первый раунд генерации для создания начальной последовательности изображений только на основе текстовых подсказок
Итерационная оптимизация:
Используйте сгенерированные изображения как референсы для следующего раунда генерации
Активируйте модуль GRCA для агрегации информации глобальных референсов
Повторяйте итерации до сходимости или достижения заданного количества итераций
Получение результата: финальная оптимизированная связная последовательность изображений истории
Ключевые параметры
--num_iterations: количество итераций (обычно заметное улучшение наблюдается после 3–5 итераций)
--use_grca: активация модуля глобальной референсной кросс-внимания
--num_frames: количество кадров истории (поддерживается до 100 кадров)
❓ Часто задаваемые вопросы о Story-Iter
В1: Какова связь между Story-Iter и Story-Adapter?
Согласно информации с arXiv, Story-Iter и Story-Adapter — это разные названия одного и того же проекта. В цитировании статьи указано Story-Adapter: A Training-free Iterative Framework for Long Story Visualization, однако на странице проекта и в материалах подачи на ICLR 2026 используется название Story-Iter.
В2: Нужно ли обучать собственную модель?
Нет. Story-Iter — это фреймворк без обучения (training-free), который можно напрямую применять к предобученным моделям Stable Diffusion.
В3: Какие базовые модели поддерживаются?
Преимущественно модели серии Stable Diffusion (например, SD 1.5, SDXL), с расширением функциональности за счёт вставки модуля GRCA.
В4: Сколько времени занимает генерация истории из 100 кадров?
Конкретное время зависит от аппаратной конфигурации и количества итераций. Из-за механизма итерационной оптимизации общее время = время генерации одного кадра × количество кадров × количество итераций. Использование GPU A100 может значительно ускорить процесс.
В5: Как обеспечивается согласованность персонажей?
Через механизм глобальных референсов модуля GRCA, который на каждой итерации агрегирует информацию обо всех уже сгенерированных кадрах, обеспечивая согласованность внешности персонажей, одежды и элементов сцены на протяжении всей истории.
📚 Связанные ресурсы
Страница проекта: https://jwmao1.github.io/storyiter/
Адрес статьи: https://arxiv.org/abs/2410.06244
Репозиторий GitHub: https://github.com/UCSC-VLAA/story-iter
Принадлежность: UCSC-VLAA (Лаборатория визуального языка и искусственного интеллекта Калифорнийского университета в Санта-Крус)














