Помощник сценариста▸
 AI Приложения
 AI Новости

Scrapeless_云技派,专注ai人工智能!
Scrapeless_云技派,专注ai人工智能!Описание
Что такое Scrapeless?
Scrapeless — это AI-инструмент для парсинга веб-страниц, который позволяет эффективно извлекать структурированные данные с сайтов. Он поддерживает режим headless-браузера, автоматически обходит капчи и IP-блокировки, оснащён высококачественным прокси-сервисом, охватывающим более 195 стран мира. Его API для парсинга прост в использовании и подходит для массового сбора данных предприятиями и разработчиками. Функции очистки и преобразования данных обеспечивают их точность и пригодность к использованию. Scrapeless предлагает бесплатную пробную версию, помогающую эффективно собирать данные.
Основные инструменты Scrapeless
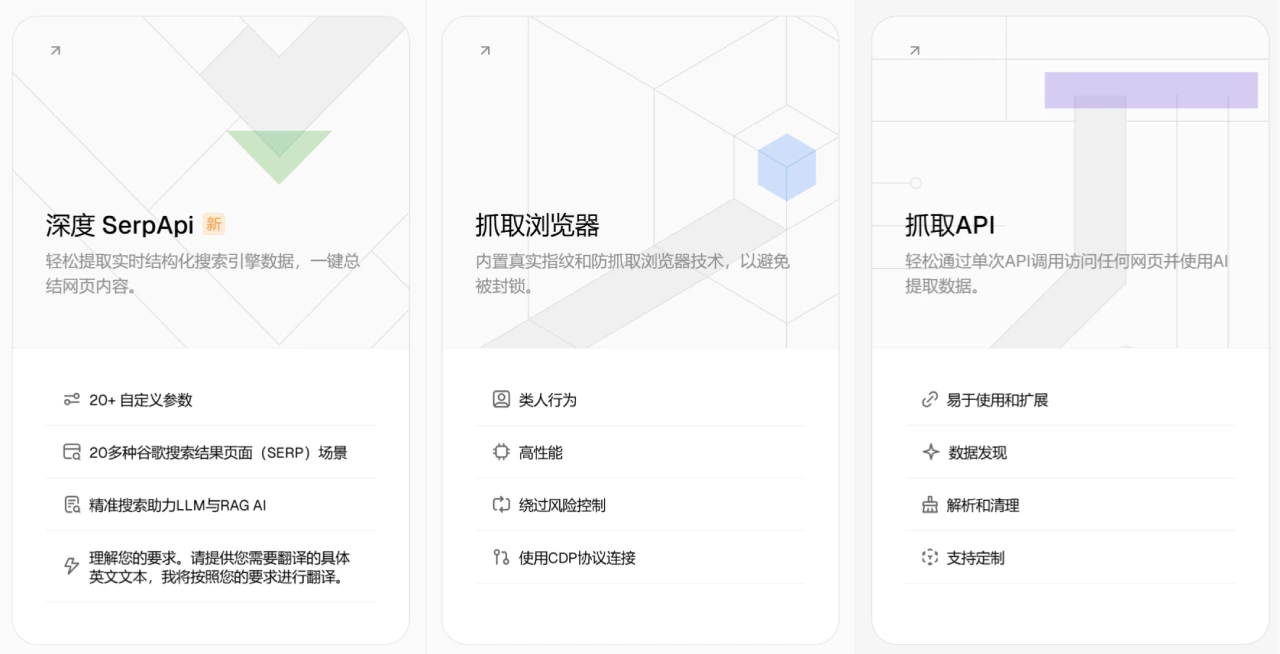
Scraping API: позволяет получать структурированные данные с любого сайта одним вызовом API, подходит для массового извлечения данных.
Scraping Browser: управляется ИИ, поддерживает режим headless-браузера, имитирует поведение реального пользователя и легко парсит динамический контент.
Web Unlocker: автоматически обходит капчи, IP-блокировки и ограничения динамического контента, обеспечивая бесперебойный сбор данных.
Прокси-сервис: предоставляет высококачественные ротируемые прокси с покрытием более 195 стран мира, предотвращая блокировку IP.
CAPTCHA Solver: автоматически решает различные капчи, такие как reCAPTCHA и Cloudflare, обеспечивая бесперебойность процесса парсинга.
Преимущества Scrapeless
Эффективное извлечение данных: быстрое и точное извлечение данных со сложных сайтов с поддержкой высокого параллелизма и высокой производительности.
Гибкая настройка: индивидуальные решения, адаптированные к потребностям предприятия, для различных бизнес-сценариев.
Очистка и преобразование данных: повышение точности и удобства использования данных, превращение исходных данных в ценную информацию.
Безопасность и конфиденциальность: применение передовых мер безопасности, строгое соблюдение стандартов соответствия для защиты пользовательских данных.
Экономическая эффективность: оплата только за успешные запросы, гибкие тарифные планы.
Сценарии использования Scrapeless
Корпоративный парсинг данных: высококачественные, индивидуально настроенные решения для веб-парсинга под ключевые бизнес-проекты.
Потоковая передача данных в реальном времени: благодаря мощной интеграции API приложения всегда остаются синхронизированными с актуальной информацией.
Автоматизация рабочих процессов: упрощение сбора данных, сокращение ручного вмешательства и повышение эффективности работы.
Для кого подходит Scrapeless
Предприятия: компании, которым необходим масштабный и эффективный сбор данных.
Разработчики: специалисты, желающие быстро и легко получать данные из сети.
Специалисты по анализу данных: профессионалы, которым нужны надёжные и эффективные инструменты извлечения данных.
Руководство по использованию Scrapeless
1. Регистрация аккаунта: перейдите на официальный сайт Scrapeless и зарегистрируйте бесплатный пробный аккаунт; на время пробного периода кредитная карта не требуется.
2. Получение API-ключа: после регистрации и входа в систему получите API-ключ в личном кабинете для аутентификации запросов.
3. Выбор инструмента: в зависимости от потребностей выберите один из инструментов — Scraping Browser, Scraping API, Web Unlocker, CAPTCHA Solver или Прокси.
4. Установка SDK: установите SDK Scrapeless для нужного языка программирования, например Python, Node.js и др.
5. Отправка запроса: используйте API-ключ для отправки запроса; базовый запрос должен содержать целевой URL и учётные данные. Например, код вызова Scraping API на Python выглядит так:
import requests
import json
API_KEY = "your_api_key"
host = "api.scrapeless.com"
url = f"https://{host}/api/v1/unlocker/request"
payload = json.dumps({
   "actor": "unlocker.webunlocker",
   "input": {
      "url": "https://httpbin.io/get",
      "redirect": False,
      "method": "GET",
   },
   "proxy":{
       "country": "ANY",
   }
})
headers = {
   'Content-Type': 'application/json',
   'x-api-token': f'{API_KEY}'
}
response = requests.request("POST", url, headers=headers, data=payload)
print(response.text)
6. Обработка ответа: полученные данные парсинга возвращаются в формате JSON, уже очищенные и структурированные, готовые к использованию.
7. Масштабирование парсинга: при необходимости увеличьте количество параллельных запросов и объём парсинга — Scrapeless автоматически обрабатывает меры по борьбе с ботами.
8. Мониторинг использования: отслеживайте использование API, процент успешных запросов и остаток кредитов через личный кабинет.
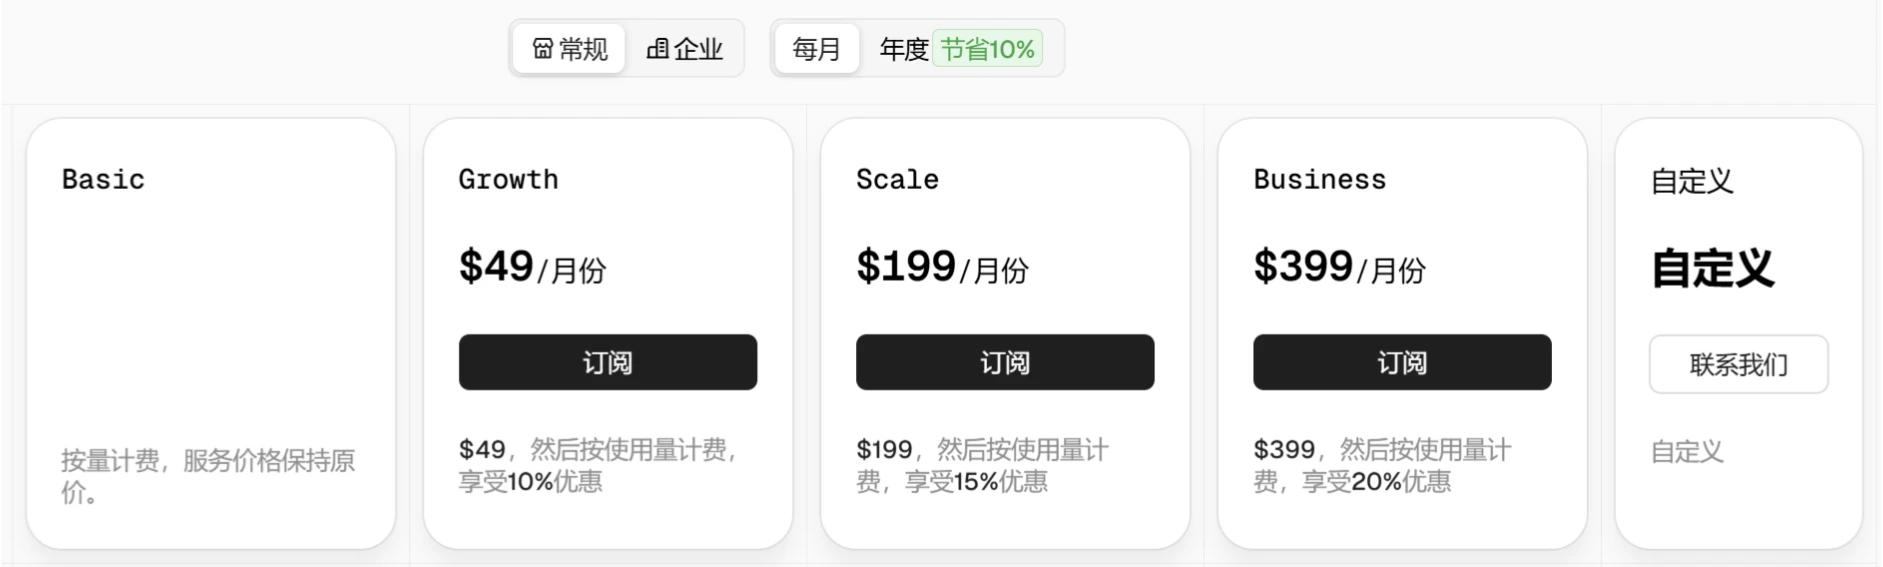
Цены Scrapeless