
 Помощник сценариста▸
 AI Приложения
 AI Новости
Spark-TTS: эффективная система синтеза речи с поддержкой zero-shot клонирования голоса и многоязычного озвучивания
Spark-TTS: эффективная система синтеза речи с поддержкой zero-shot клонирования голоса и многоязычного озвучиванияОписание
Что такое Spark-TTS?
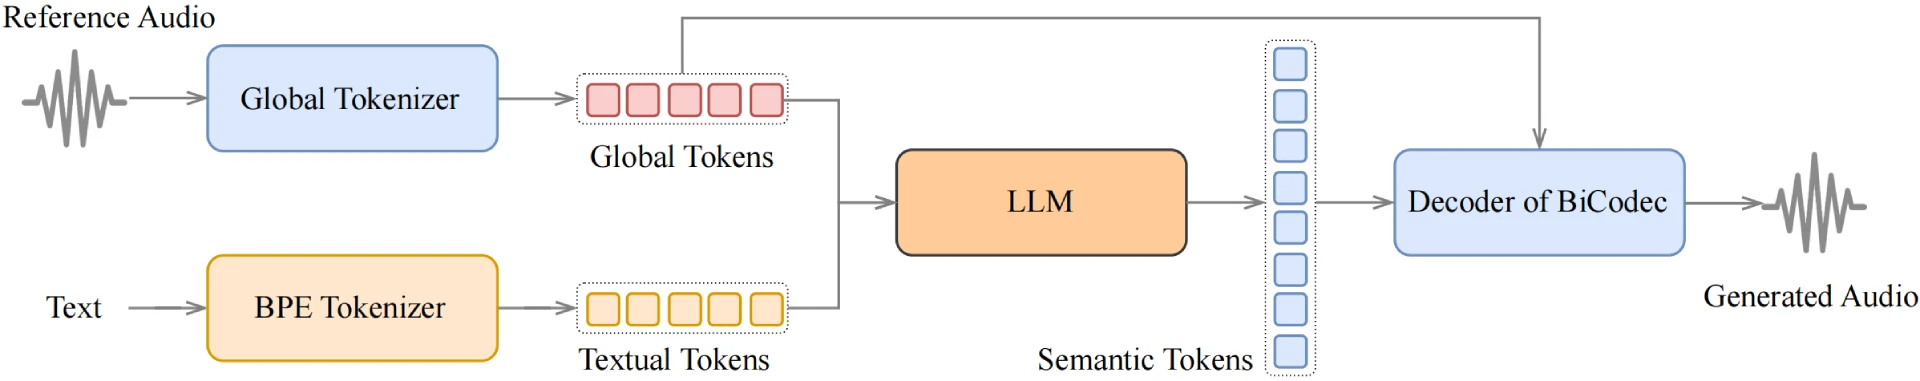
Spark-TTS — это система преобразования текста в речь (TTS), разработанная командой SparkAudio на базе Qwen2.5, которая обеспечивает прямой контроль высоты тона, скорости и стиля говорящего непосредственно из текста. Поддерживает клонирование голоса с нулевым количеством примеров (zero-shot voice cloning), многоязыковой синтез, тонкое управление голосом и генерацию речи через Web UI, что позволяет быстро преобразовывать текст в естественное и качественное голосовое содержимое. В отличие от традиционных TTS-систем, Spark-TTS восстанавливает аудио непосредственно из кодировок, предсказанных LLM, что упрощает процесс генерации речи и повышает эффективность.
Основные функции Spark-TTS
Клонирование голоса с нулевым количеством примеров: Spark-TTS поддерживает клонирование голоса без обучающих данных конкретного говорящего, позволяя воспроизводить его голос. В сценариях кросс-языкового и кодового переключения система превосходно обеспечивает бесшовное переключение между различными языками и говорящими.
Многоязыковая поддержка: система поддерживает китайский и английский языки, сохраняя высокую степень естественности и точности при кросс-языковом синтезе. Пользователь вводит текст на одном языке и получает голосовой вывод на другом.
Тонкое управление голосом: пользователи могут настраивать голос виртуального говорящего, изменяя такие параметры, как пол, высота тона и скорость речи, что удовлетворяет потребности в разнообразном голосовом контенте для виртуальных ведущих, аудиокниг и других сценариев.
Эффективный синтез речи: Spark-TTS полностью построен на архитектуре Qwen2.5, не требует дополнительных генеративных моделей и восстанавливает аудио непосредственно из кодировок, предсказанных LLM, что упрощает процесс и снижает сложность.
Создание виртуального говорящего: пользователи могут создавать собственных виртуальных говорящих, настраивая параметры для придания им уникального стиля речи.
Техническая архитектура Spark-TTS
Технической основой Spark-TTS является однопоточный речевой кодек BiCodec, который разлагает речь на низкоскоростные семантические токены (отвечающие за языковое содержание) и глобальные токены фиксированной длины (отвечающие за характеристики говорящего). Такое разделение позволяет гибко настраивать голосовые характеристики, а в сочетании с технологией цепочки рассуждений (Chain-of-Thought) Qwen2.5 дополнительно повышает качество и управляемость генерации речи.
Сценарии применения Spark-TTS
Создание аудиокниг: естественное качество голоса особенно подходит для аудиокниг.
Виртуальные ведущие: путём настройки параметров голоса можно генерировать виртуальных говорящих, соответствующих конкретным требованиям.
Кросс-языковой синтез речи: поддержка нескольких языков расширяет применимость системы по всему миру.
Установка и использование Spark-TTS
1. Подготовка среды
Установка Python: убедитесь, что установлен Python 3.12.
Установка Conda: используется для управления виртуальными средами, можно загрузить и установить с официального сайта Miniconda.
2. Клонирование репозитория
git clone https://github.com/SparkAudio/Spark-TTS.git
cd Spark-TTS
3. Установка зависимостей
conda create -n sparktts -y python=3.12
conda activate sparktts
pip install -r requirements.txt
При нахождении в материковом Китае можно использовать зеркало Alibaba Cloud:
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
4. Загрузка предобученной модели
Загрузите предобученную модель с помощью следующей команды:
from huggingface_hub import snapshot_download
snapshot_download("SparkAudio/Spark-TTS-0.5B", local_dir="pretrained_models/Spark-TTS-0.5B")
5. Базовое использование
Выполните следующую команду для синтеза речи:
python -m cli.inference \
    --text "text to synthesis." \
    --device 0 \
    --save_dir "path/to/save/audio" \
    --model_dir pretrained_models/Spark-TTS-0.5B \
    --prompt_text "transcript of the prompt audio" \
    --prompt_speech_path "path/to/prompt_audio"
6. Использование Web UI
python webui.py --device 0
Репозиторий на GitHub:https://github.com/SparkAudio/Spark-TTS
Коллекция моделей на HuggingFace: https://huggingface.co/spaces/Mobvoi/Offical-Spark-TTS
Документ (статья):https://arxiv.org/pdf/2503.01710
Демонстрация:https://sparkaudio.github.io/spark-tts/
Связанные новости:
Octave: TTS-модель, выпущенная Hume AI, с контекстной осведомлённостью и эмоциональной адаптацией
llasa 3B TTS: модель преобразования текста в речь (TTS) на архитектуре LLaMA














