
 Помощник сценариста▸
 AI Приложения
 AI Новости
Step-Audio: первая открытая модель голосового взаимодействия от Stepfun
Step-Audio: первая открытая модель голосового взаимодействия от StepfunОписание
Step-Audio, являющаяся первой в отрасли продуктовой моделью речевого взаимодействия с открытым исходным кодом, способна генерировать разнообразные речевые выражения в зависимости от потребностей сценария, включая эмоции, диалекты, языки, пение и индивидуальные стили, при этом взаимодействие отличается естественностью и плавностью. В оценке шестого уровня экзамена по китайскому языку HSK Step-Audio показала выдающиеся результаты и была названа моделью с открытым исходным кодом, лучше всех понимающей китайский язык. Данная ai-модель была совместно разработана StepFun и Geely Automobile Group, а её исходный код был официально открыт 18 февраля 2025 года.
Функциональные особенности Step-Audio:
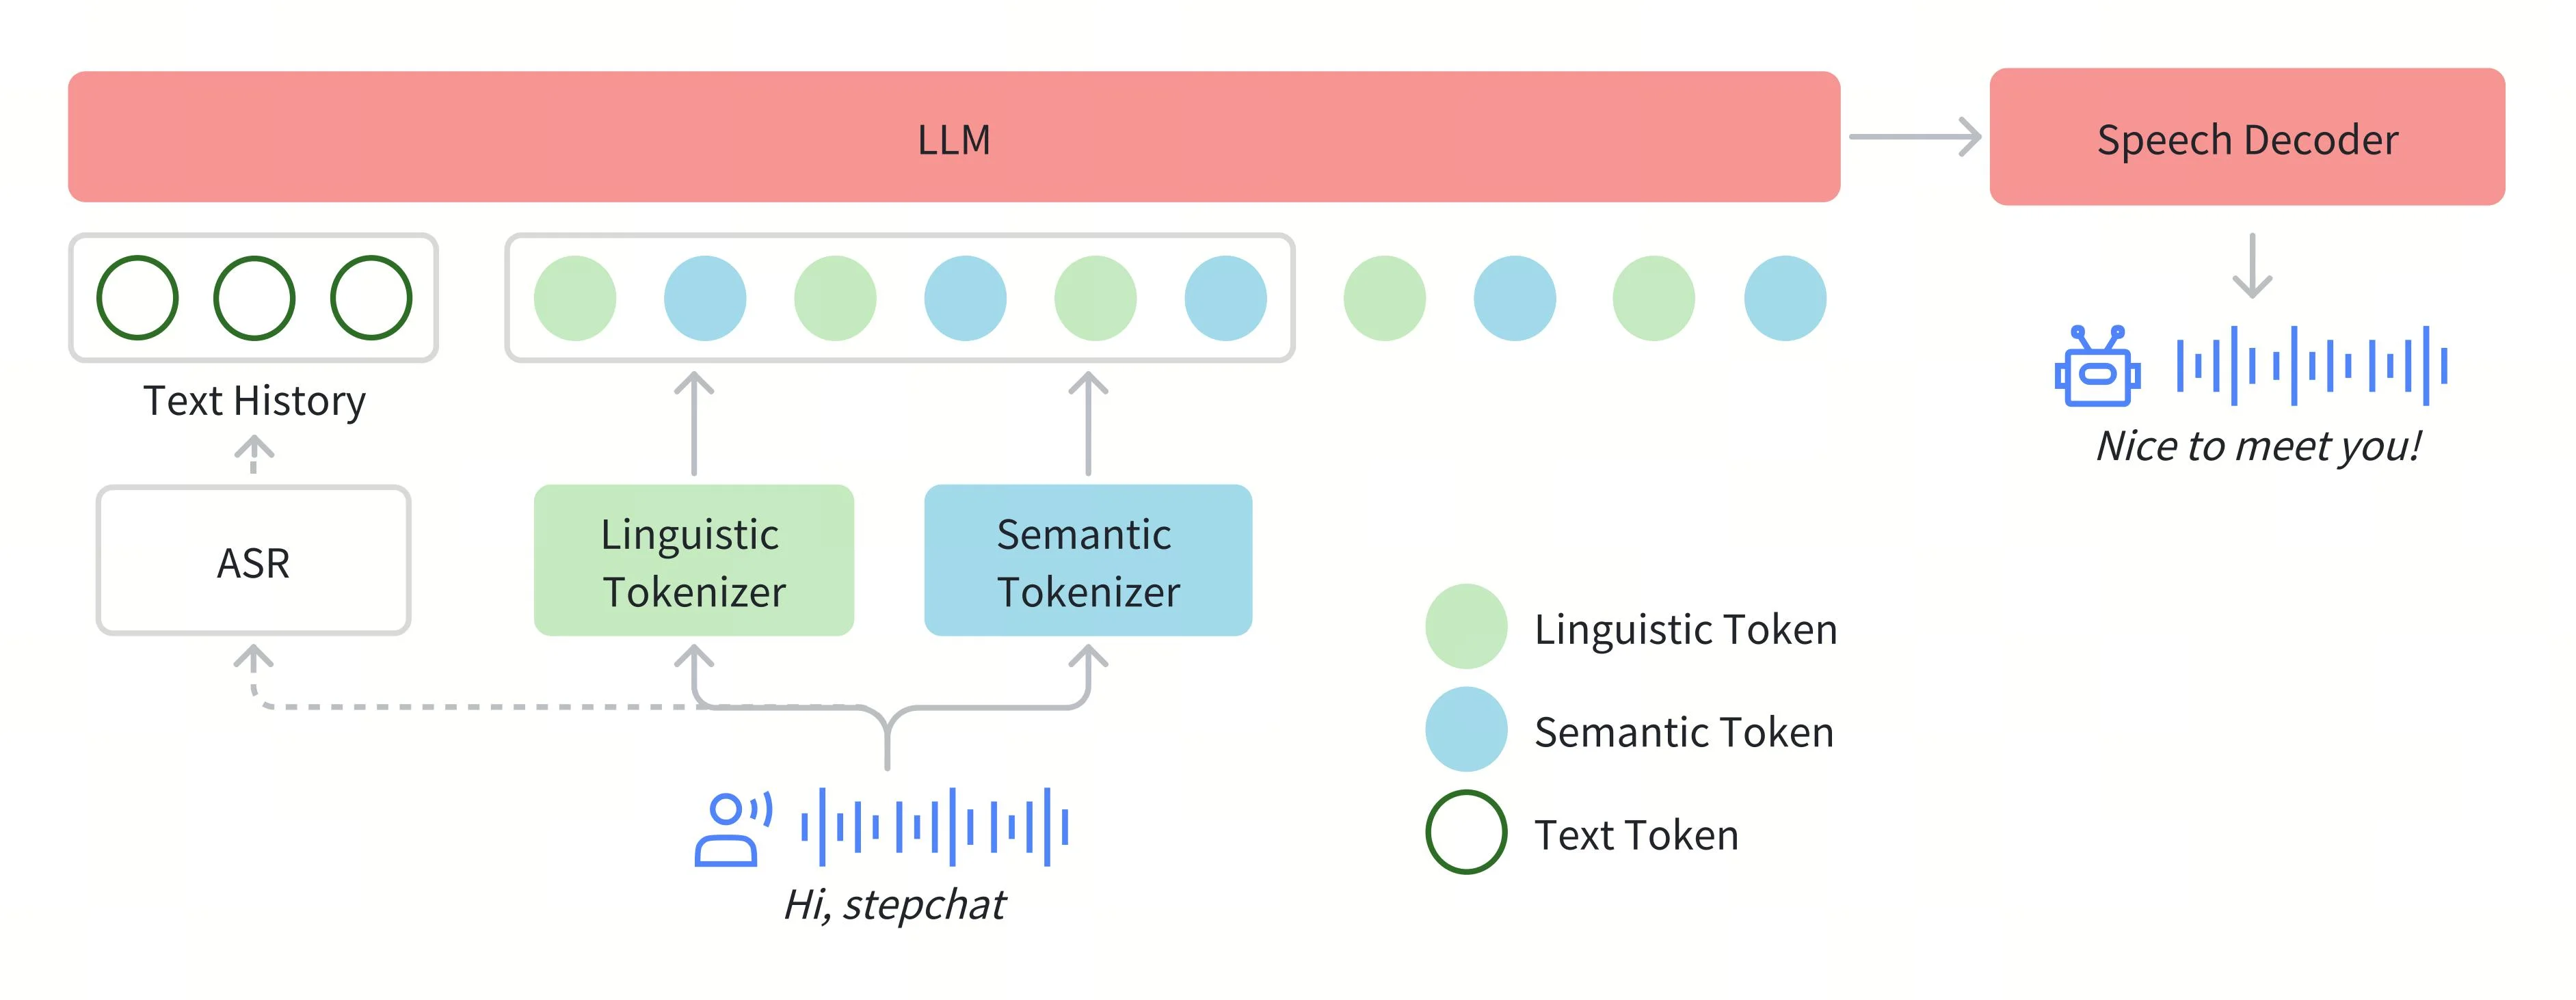
Единая модель: мультимодальная модель на 13 миллиардов параметров, объединяющая понимание и генерацию речи, способная одновременно обрабатывать распознавание речи, семантическое понимание, диалог, клонирование голоса, редактирование и синтез аудио.
Разнообразие эмоций и стилей: генерация речи с различными эмоциями (гнев/радость/грусть), диалектами (кантонский/сычуаньский и др.), языками, пением (рэп/мычание) и индивидуальными стилями по запросу, с точным контролем эмоций, диалектов, языков и пения.
Сценарии применения Step-Audio:
Интеллектуальная поддержка клиентов: предоставление персонализированного, эмоционального обслуживания для улучшения пользовательского опыта.
Аудиокниги: генерация эмоционального чтения для усиления эффекта погружения при прослушивании.
Создание аудио- и видеоконтента: автоматическая генерация озвучки видео или озвучивания персонажей анимации.
NPC в играх: обеспечение естественного и плавного речевого взаимодействия для игровых персонажей.
Запись совещаний: преобразование речи в текст в реальном времени с предоставлением голосовой обратной связи.
Помощь в образовании: персонализированный ассистент преподавателя с настройкой стиля и тона обучения.
Технические особенности Step-Audio:
Технология высокой степени сжатия: использование эффективных технологий сжатия, таких как Video-VAE, для оптимизации обработки данных.
Двуязычная обработка: использование Hunyuan-CLIP и Step-LLM для обработки подсказок на китайском и английском языках.
Архитектура DIT и алгоритм Video-DPO: оптимизация обработки сложных видео- и аудиоданных.
Обучение на крупномасштабных наборах данных: создание больших наборов данных для обеспечения обобщения модели и детализации результатов.
Инструкция по использованию Step-Audio:
Получение модели: доступ к версии Step-Audio с открытым исходным кодом через приложение 跃问 или такие платформы, как Hugging Face.
Технический отчёт: ознакомьтесь с техническим отчётом на arxiv.org или GitHub для получения подробной информации.
API-интерфейс: реализация речевого взаимодействия через вызов API в соответствии с лицензией MIT с открытым исходным кодом.
Интеграция и разработка: интеграция в приложения в соответствии с официальной документацией или примерами кода.
Тонкая настройка: продвинутые пользователи могут выполнять дообучение модели для адаптации к конкретным сценариям или повышения производительности.
Способы получения Step-Audio
GitHub: https://github.com/stepfun-ai/Step-Audio
ModelScope: [перейти]
Технический отчёт: [перейти]
Поддержка развёртывания в один клик через PAI Model Gallery [перейти]














