
 Помощник сценариста▸
 AI Приложения
 AI Новости

MakeAnything: модель генерации согласованных последовательных изображений
MakeAnything: модель генерации согласованных последовательных изображенийОписание
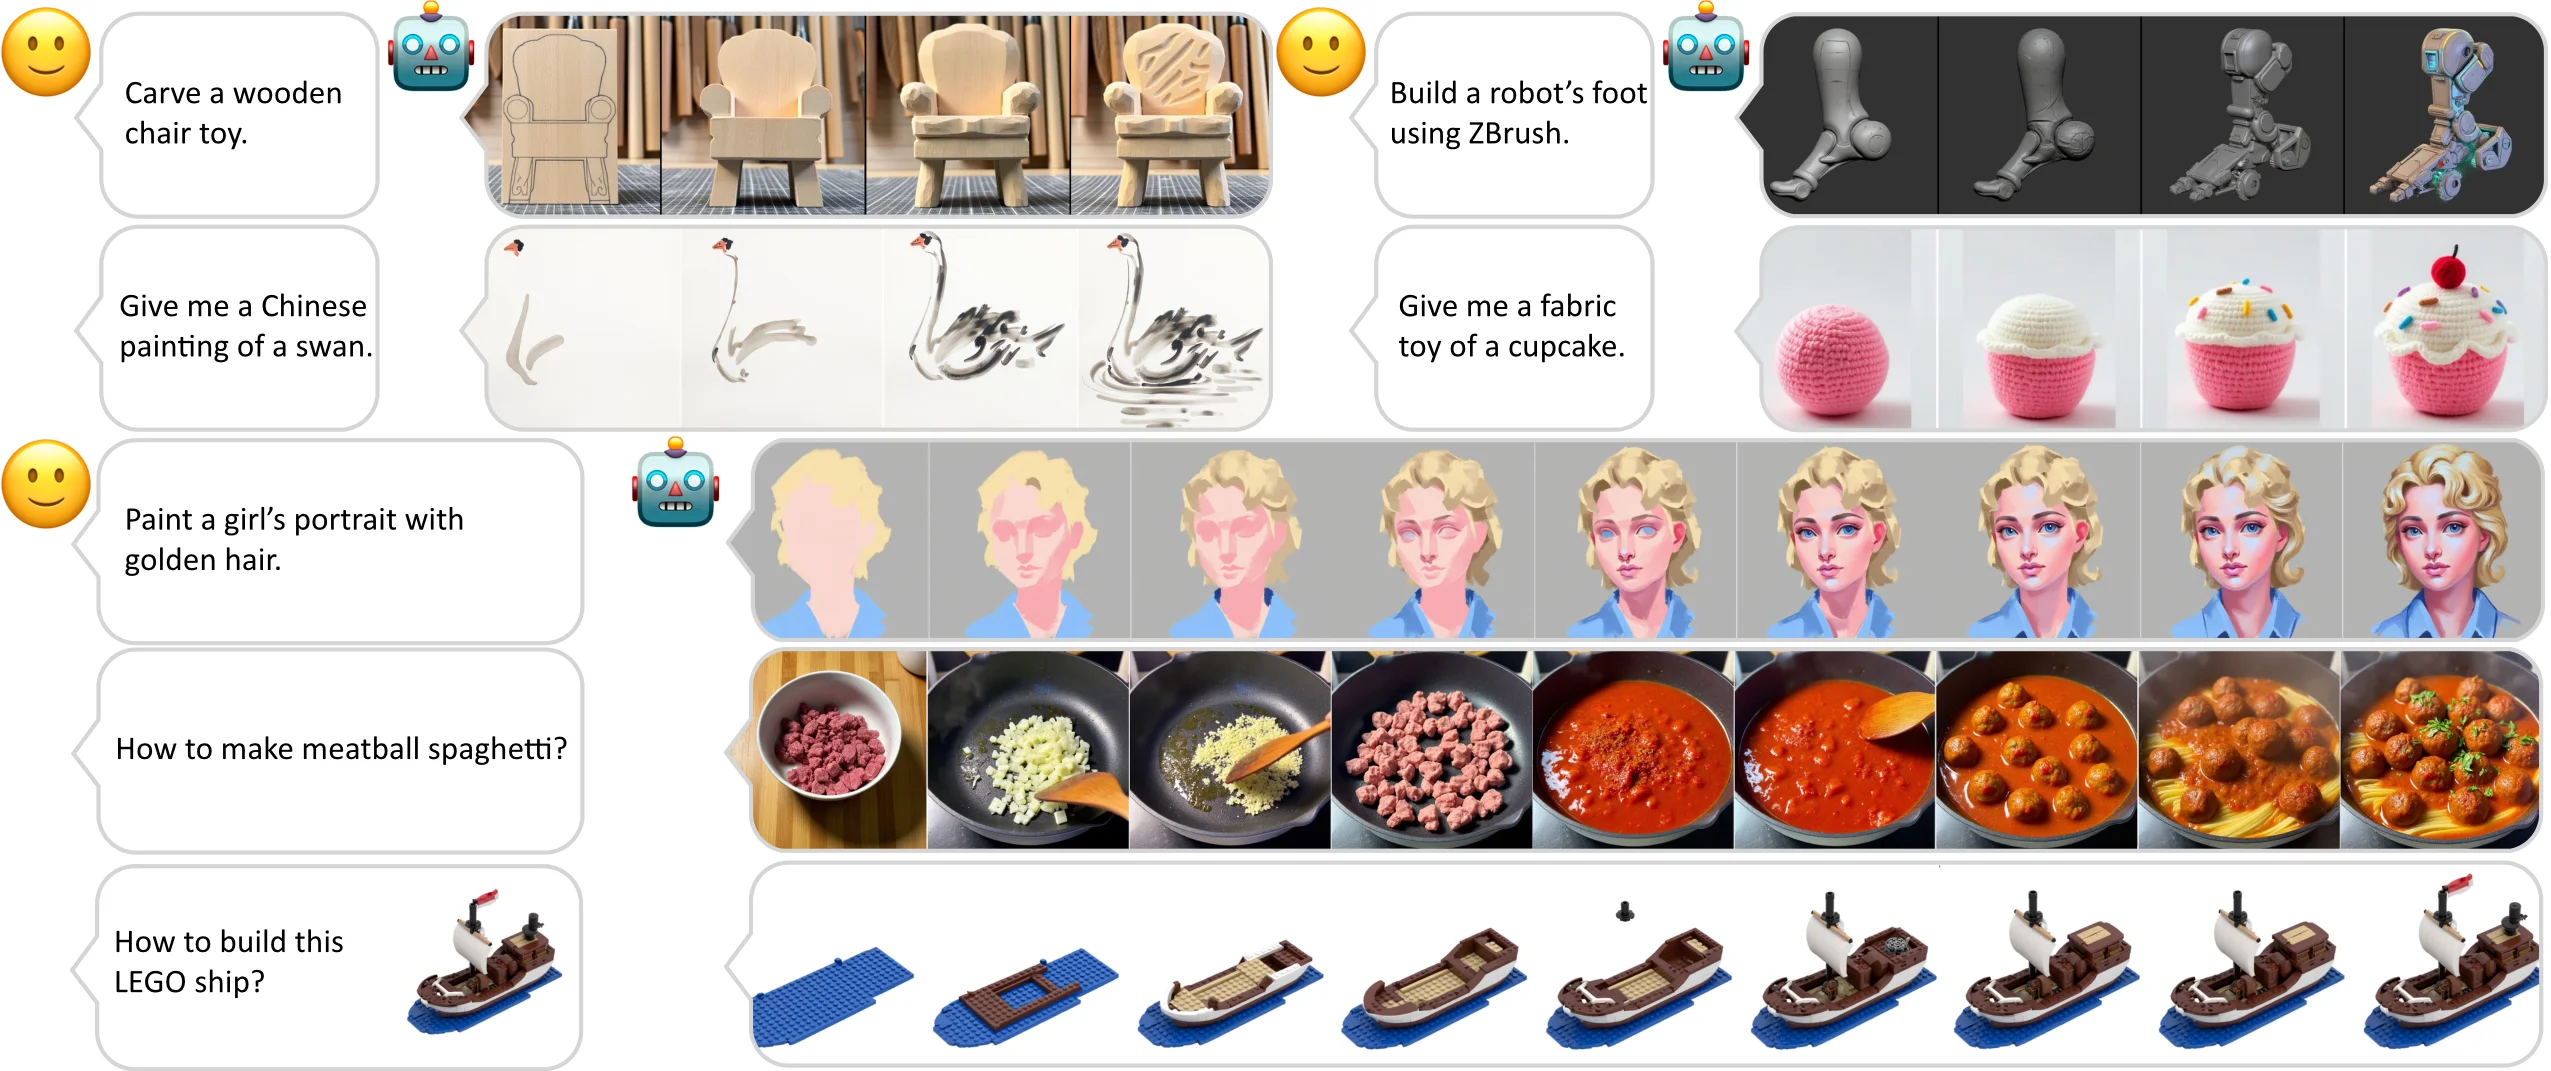
MakeAnything — это модель генерации последовательностей, разработанная Национальным университетом Сингапура на основе диффузионных трансформеров (Diffusion Transformers), которая способна создавать последовательности изображений по текстовому описанию и, благодаря мощным возможностям генерации, обеспечивать согласованные многоэлементные коллажи.
Функциональные особенности MakeAnything:
Диффузионный трансформер: использует выдающуюся производительность диффузионного трансформера для генерации сложных изображений.
Текст в изображение: поддерживает преобразование текстового описания в изображения различных стилей, усиливая качество генерации за счёт обучения и промптов.
Согласованность под-изображений: обеспечивает визуальную согласованность нескольких под-изображений, создаваемых в процессе генерации.
Технические особенности MakeAnything:
Данная модель сочетает технологию асимметричной низкоранговой адаптации (LoRA) с моделью ReCraft, что делает процесс генерации более эффективным, а также позволяет преобразовывать статичные изображения в интерпретируемый творческий процесс, чтобы пользователь мог чётко видеть каждый шаг. Это решает проблему поддержания логической связности и визуальной согласованности при генерации многошаговых последовательностей.
Порядок использования MakeAnything:
Подготовка обучающих данных: в соответствии с требованиями задачи подготовить наборы текстовых и графических данных, как правило, выполняя очистку и форматирование данных.
Обучение модели: провести обучение с использованием асимметричного метода LoRA на наборе данных MakeAnything, настраивая модель для повышения её генеративных способностей.
Генерация контента: после завершения обучения пользователь может вводить текстовые подсказки, и модель будет генерировать соответствующие изображения и другой мультимодальный контент.
Постобработка: сгенерированный контент может быть дополнительно оптимизирован на этапе постобработки, например, путём корректировки цветов или добавления деталей, чтобы он лучше соответствовал потребностям пользователя.
Области применения MakeAnything:
Дизайн резьбы: используется для создания эскизов резьбы и 3D-моделей.
Создание рисунков: применяется для автоматизированного художественного рисования, принося авторам новое вдохновение.
Автомобильный тюнинг: в области автомобильного дизайна позволяет реализовать эффекты трансформации под разными ракурсами и стилями.
Рукоделие и DIY: пользователи могут получать пошаговые инструкции по различным техникам рукоделия для последующей практической работы.
Кулинария и рецепты: можно генерировать подробные шаги приготовления, помогая пользователям освоить процесс создания сложных блюд.
Github:https://github.com/showlab/MakeAnything














