
 Помощник сценариста▸
 AI Приложения
 AI Новости
FireRedASR: модель распознавания речи с открытым исходным кодом от Xiaohongshu
FireRedASR: модель распознавания речи с открытым исходным кодом от XiaohongshuОписание
FireRedASR — это модель распознавания речи на основе большой языковой модели, выпущенная и опубликованная в открытом доступе командой FireRed платформы Xiaohongshu 9 февраля 2025 года. Она установила новый уровень SOTA (коэффициент ошибок на уровне символов CER 3,05%) в области распознавания китайской путунхуа, а также поддерживает распознавание диалектов, английского языка и текстов песен.
Основные возможности FireRedASR:
Высокоточное распознавание речи: FireRedASR-LLM (8,3 млрд параметров) достигла коэффициента ошибок на уровне символов (CER) 3,05% на открытых тестовых наборах, что стало новым SOTA и снизило уровень ошибок на 8,4% по сравнению с предыдущей SOTA-моделью Seed-ASR (12 млрд+ параметров).
Эффективное распознавание: FireRedASR-AED (1,1 млрд параметров) при сохранении высокой точности значительно повышает эффективность распознавания, её CER составляет 3,18%.
Адаптация к различным сценариям: FireRedASR отлично показывает себя в самых разных повседневных сценариях, таких как короткие видеоролики, прямые трансляции, голосовой ввод и голосовые ассистенты. По сравнению с ведущими поставщиками ASR-сервисов в индустрии и моделью Paraformer-Large относительное уменьшение CER составляет от 23,7% до 40,0%.
Распознавание текстов песен: в сценариях, где требуется распознавание текстов песен, CER FireRedASR-LLM показал относительное снижение на 50,2%–66,7%, что демонстрирует исключительные возможности адаптации.
Поддержка нескольких языков: FireRedASR поддерживает путунху, а также показывает отличные результаты в распознавании китайских диалектов и английской речи, что ещё больше расширяет сферу её применения.
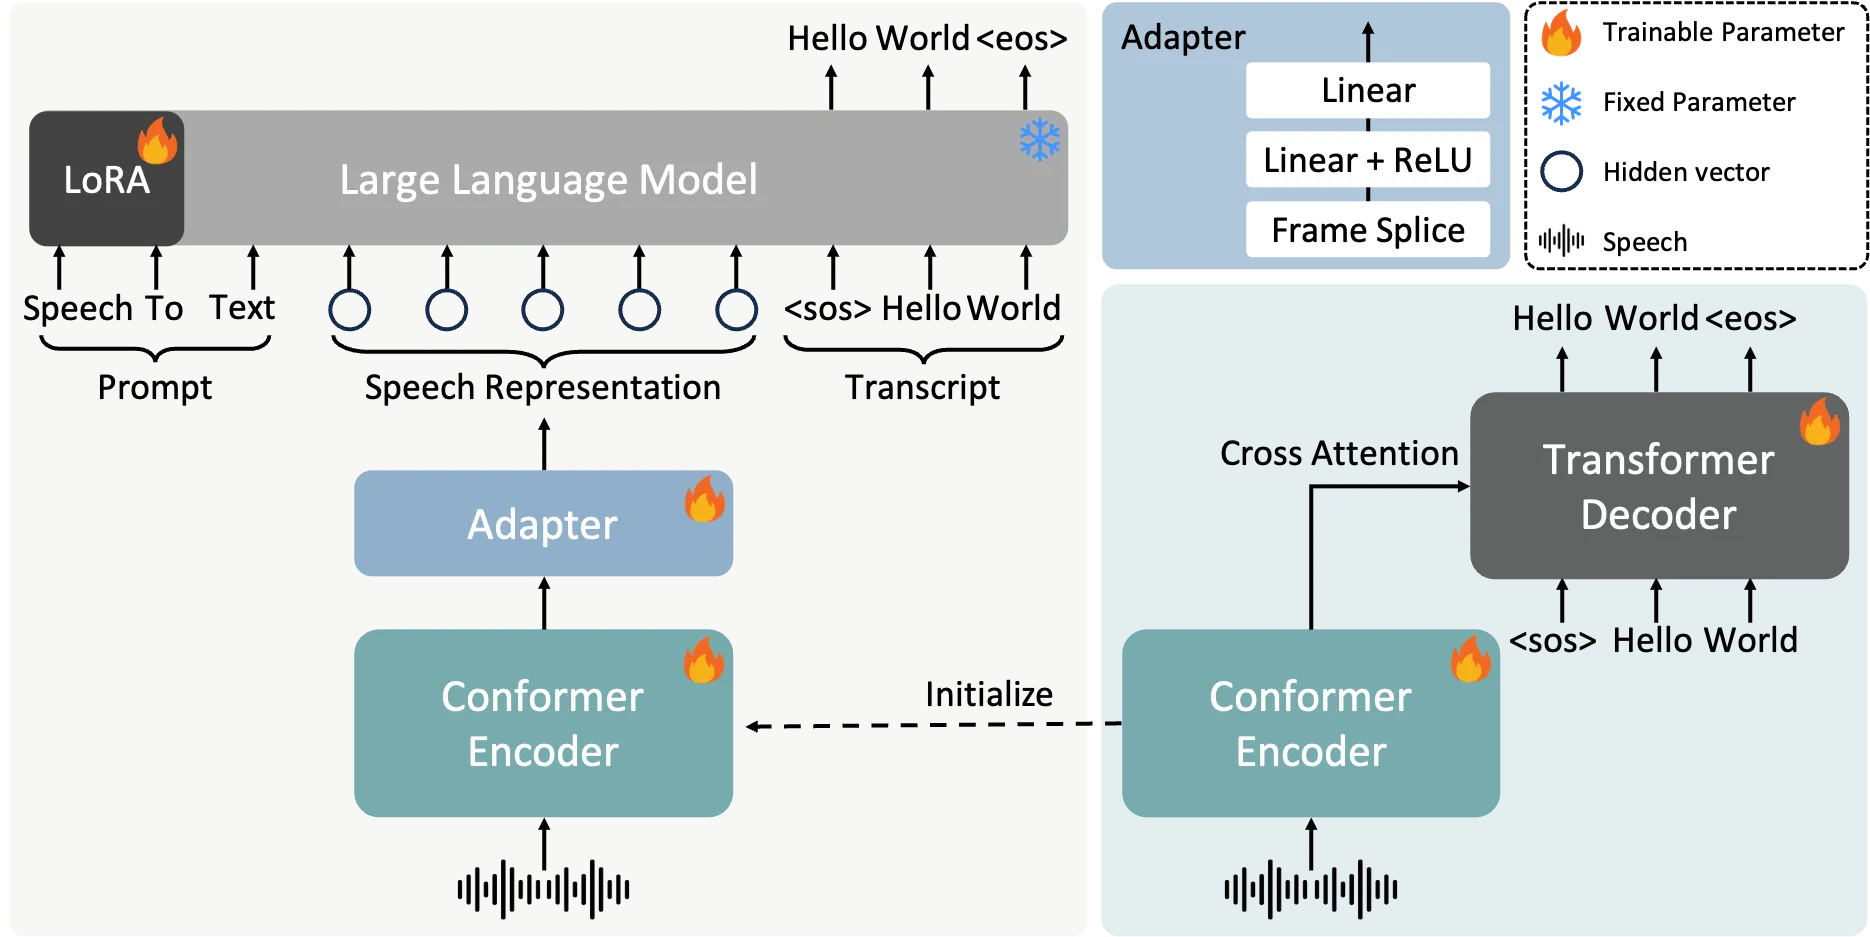
Две основные версии модели FireRedASR:
FireRedASR-LLM
Архитектура: использует фреймворк Encoder-Adapter-LLM в сочетании с большой языковой моделью Qwen2-7B-Instruct, обеспечивая сквозное голосовое взаимодействие посредством дообучения LoRA.
Производительность: CER 3,05% в тестах на путунху, что на 8,4% снижает уровень ошибок по сравнению с предыдущей SOTA-моделью; относительное снижение CER в сценариях распознавания текстов песен составляет 50,2%–66,7%.
Особенности: 8,3 млрд параметров, ориентация на максимальную точность, подходит для требовательных сценариев, таких как профессиональное создание субтитров.
FireRedASR-AED
Архитектура: основана на архитектуре «кодировщик-декодировщик» с вниманием (кодировщик Conformer + декодировщик Transformer), 1,1 млрд параметров.
Производительность: CER 3,18%, что превосходит Seed-ASR с 12 млрд параметров, при более высокой эффективности распознавания.
Особенности: баланс между точностью и вычислительной эффективностью, подходит для приложений реального времени, таких как субтитры в прямых трансляциях и голосовые ассистенты.
Технические преимущества FireRedASR:
Адаптация к различным сценариям: в повседневных сценариях, таких как короткие видеоролики и прямые трансляции, относительное снижение CER составляет 23,7%–40,0%; поддерживает китайские диалекты и английский язык.
Экосистема открытого кода: модель и код опубликованы в открытом доступе (GitHub), используют промышленный дизайн и поддерживают дальнейшую разработку сообществом.
Стратегия обучения: в версии LLM большая часть параметров зафиксирована, обучаются только кодировщик и адаптер, что сохраняет возможности предварительного обучения.
Сценарии применения FireRedASR
Интеллектуальное голосовое взаимодействие: FireRedASR может применяться в сценариях интеллектуальных голосовых ассистентов, голосового ввода и других, обеспечивая высокоточное распознавание речи.
Понимание мультимедийного контента: FireRedASR отлично показывает себя в таких сценариях понимания мультимедийного контента, как создание субтитров для видео и распознавание текстов песен.
Применение в повседневных сценариях: FireRedASR отлично показывает себя в самых разных повседневных сценариях, таких как короткие видеоролики, прямые трансляции, голосовой ввод и голосовые ассистенты. По сравнению с ведущими поставщиками ASR-сервисов в индустрии и моделью Paraformer-Large относительное уменьшение CER составляет от 23,7% до 40,0%.
Ссылки по теме FireRedASR:
Адрес проекта: https://github.com/FireRedTeam/FireRedASR
Адрес статьи: https://arxiv.org/abs/2501.14350














